この教材の目次を開く
回答はこのページを開いている間だけ保持します。別ページへの移動や再読み込みで消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
1画像を作ることと、一部を直すことは同じ?
交換会のポスターに挿絵がほしい。一か所だけ直した画像なら、その部分だけ見ればよい?
画像を作ることと、一部を直すことは同じ?
この話で学ぶこと:ポスターの一部を直す狙いから、範囲/周囲/公開条件を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
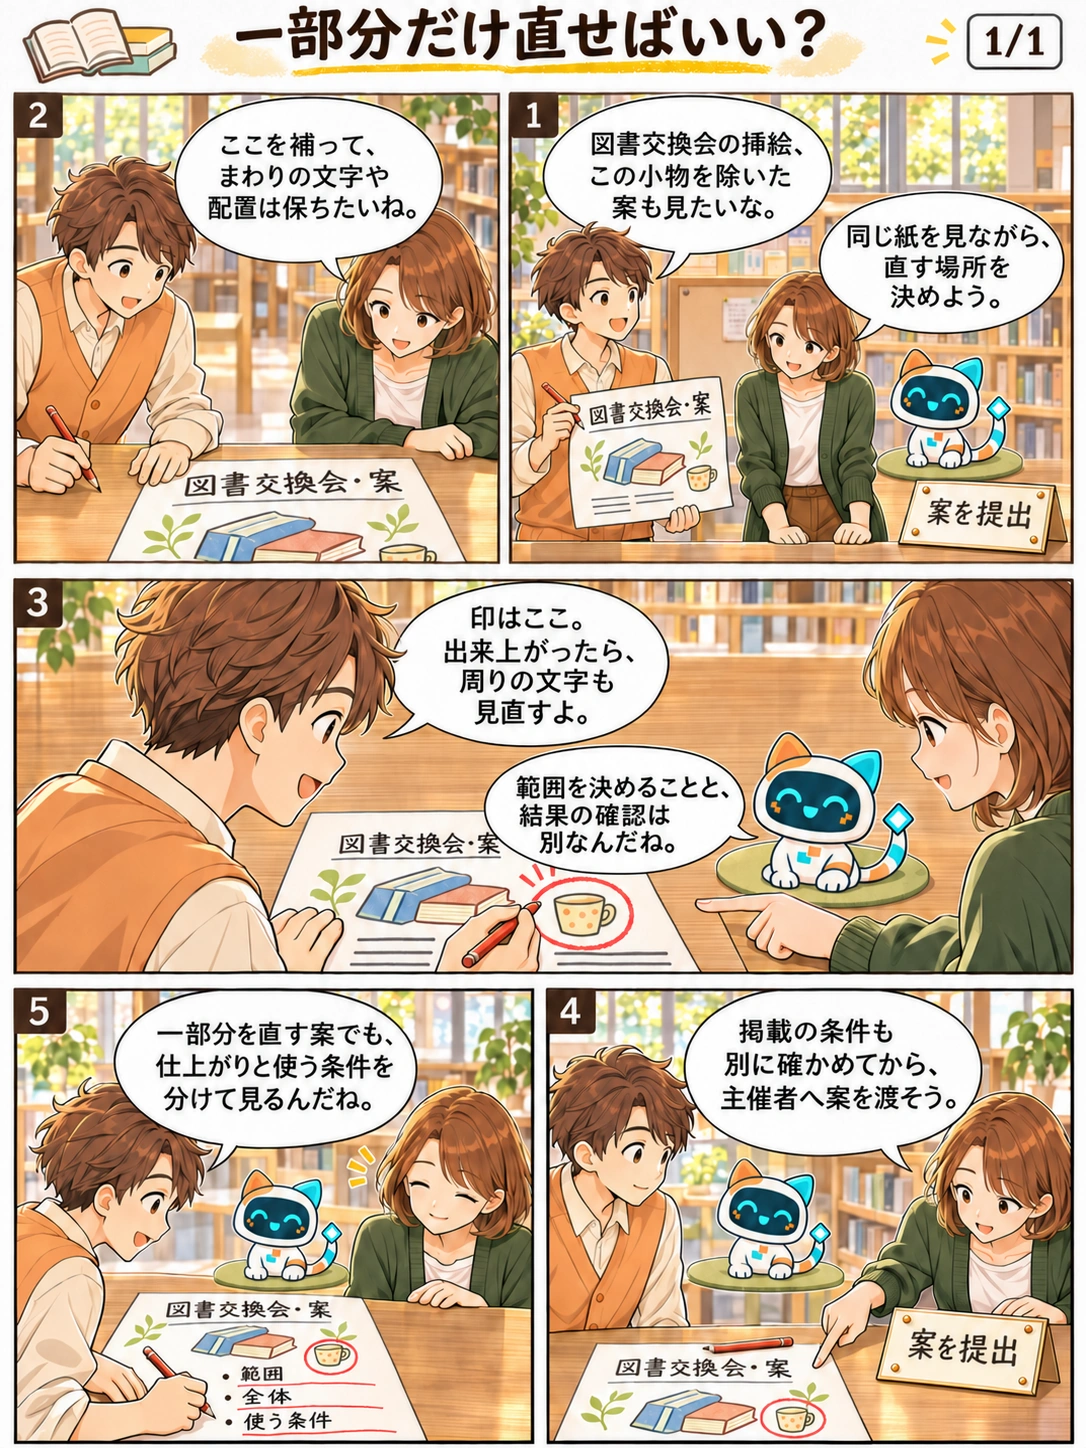
会話を文章で読む
場面:図書交換会の掲示案をハルがミオに見せ、直す場所を一緒に決めます。
ハル「図書交換会の挿絵、この小物を除いた案も見たいな。」 ミオ「同じ紙を見ながら、直す場所を決めよう。」場面:同じ紙を机に置き、周りの文字と配置も見ることを話します。
ミオ「ここを補って、まわりの文字や配置は保ちたいね。」場面:ハルが小物に赤丸を付けます。丸は編集したい範囲の印で、確認済みの印ではありません。
ハル「印はここ。出来上がったら、周りの文字も見直すよ。」 ビット「範囲を決めることと、結果の確認は別なんだね。」場面:ミオが提出先の札の近くを指し、掲載条件も確かめようと話します。
ミオ「掲載の条件も別に確かめてから、主催者へ案を渡そう。」場面:ハルは「範囲・全体・使う条件」を書きます。掲示・公開の完了は描いていません。
ハル「一部分を直す案でも、仕上がりと使う条件を分けて見るんだね。」
図書交換会の掲示案で、Haruが丸を付けたのは挿絵の一部分でした。Mioにも同じ紙を見せ、直す場所と仕上がり全体を確かめることにしました。画像では、どこをどう作るのかと、できた画像をどう使うのかを分けます。
条件に合う画像の候補を作る
画像生成AIは、文章や画像などの条件に合わせて、写真や絵のような視覚的な内容を新しく作る仕組みです。代表的な方式の一つに拡散モデルがあります。学習では画像へ段階的にノイズ、つまり雑音を加えた状態と、ノイズを減らす関係を学びます。新しい画像を作るときは、ノイズから出発し、文章などの条件も使って徐々に画像の候補を作ります。既存の写真をそのまま検索して返す処理とは区別します。
道具の例としてAdobe Fireflyの公式案内では、作りたい画像を文章で説明し、画像の候補を得る使い方が示されています。例えば「本と葉を組み合わせた、余白の多い挿絵」と指定し、ポスターの案を比べる用途です。モデルや設定によって使える機能は異なります。Fireflyという道具名だけから、全モデルが同じ内部方式だとは決めません。
根拠:High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗ / Generate images from text descriptions — Adobe Firefly(別タブで開く) ↗
選んだ範囲を補うインペインティング
インペインティングは、画像の指定した範囲を、周囲や指示に合わせて補う編集です。編集したい範囲を示す印をマスクと呼びます。新しい画像全体を作ること、指定範囲を補うこと、画像の大きさやファイル形式だけを変えることは、目的が違います。
FireflyのGenerative removeの案内では、画像の不要な部分をブラシで選び、周囲に合う置換内容を生成する使い方が示されています。挿絵の余計な小物を除く案を作る、といった用途です。選択範囲の指定は編集の狙いであり、周囲が意図どおり保たれたという確認の代わりではありません。対象と周囲を含む完成候補を見直します。
根拠:High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗ / Use generative remove — Adobe Firefly(別タブで開く) ↗
電子透かしと来歴情報は、何を知らせる?
電子透かしは、生成などに関する手がかりを画像や音声などへ埋め込む技術です。目や耳で気づきにくいものもあります。GoogleのSynthIDは、対応するAI生成の画像・音声・動画などへ透かしを入れ、その透かしを技術的に検出する例です。対象の透かしを探すことと、世界中のあらゆるAI生成物を判定することは同じではありません。
画像や音声などのデジタルな内容をコンテンツといいます。来歴情報は、そのコンテンツがどのように作られ、編集されたかなどの履歴に関する情報です。C2PAは、この来歴を扱う技術仕様を整備する取り組みです。C2PA仕様のContent Credentialsでは、来歴の記録にデジタル署名を付けます。デジタル署名は、署名者や記録の改変を技術的に確かめるための仕組みです。版2.4の説明は、記録の整合性や署名、対象ファイルとの結び付けを検証する範囲を示しています。
根拠:Google SynthID(別タブで開く) ↗ / C2PA Explainer 2.4(別タブで開く) ↗ / C2PA FAQs(別タブで開く) ↗
来歴の検証と、内容・利用条件の確認を分ける
C2PAの検証が成功しても、写っている出来事が真実だと判定したことにはなりません。来歴は利用を制限するDRM、つまりアクセスや利用を制御する仕組みでもありません。また、来歴情報がファイルから分離する場合があるため、情報が見つからないだけで実写や未編集と決めません。電子透かしの有無も、内容の真実や権利の許可を一括して証明しません。
掲示や公開に使う前には、文字や物の形が目的に合うか、編集範囲以外に意図しない変化がないかを見ます。人物、ロゴ、元にした画像などの利用条件も別に確認します。AIで生成したことや来歴が付いたことだけで、第三者の権利を含む全ての利用が許されたとは扱いません。
根拠:C2PA Explainer 2.4(別タブで開く) ↗ / C2PA FAQs(別タブで開く) ↗ / Google SynthID(別タブで開く) ↗ / Use generative remove — Adobe Firefly(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
 図を拡大する ↗
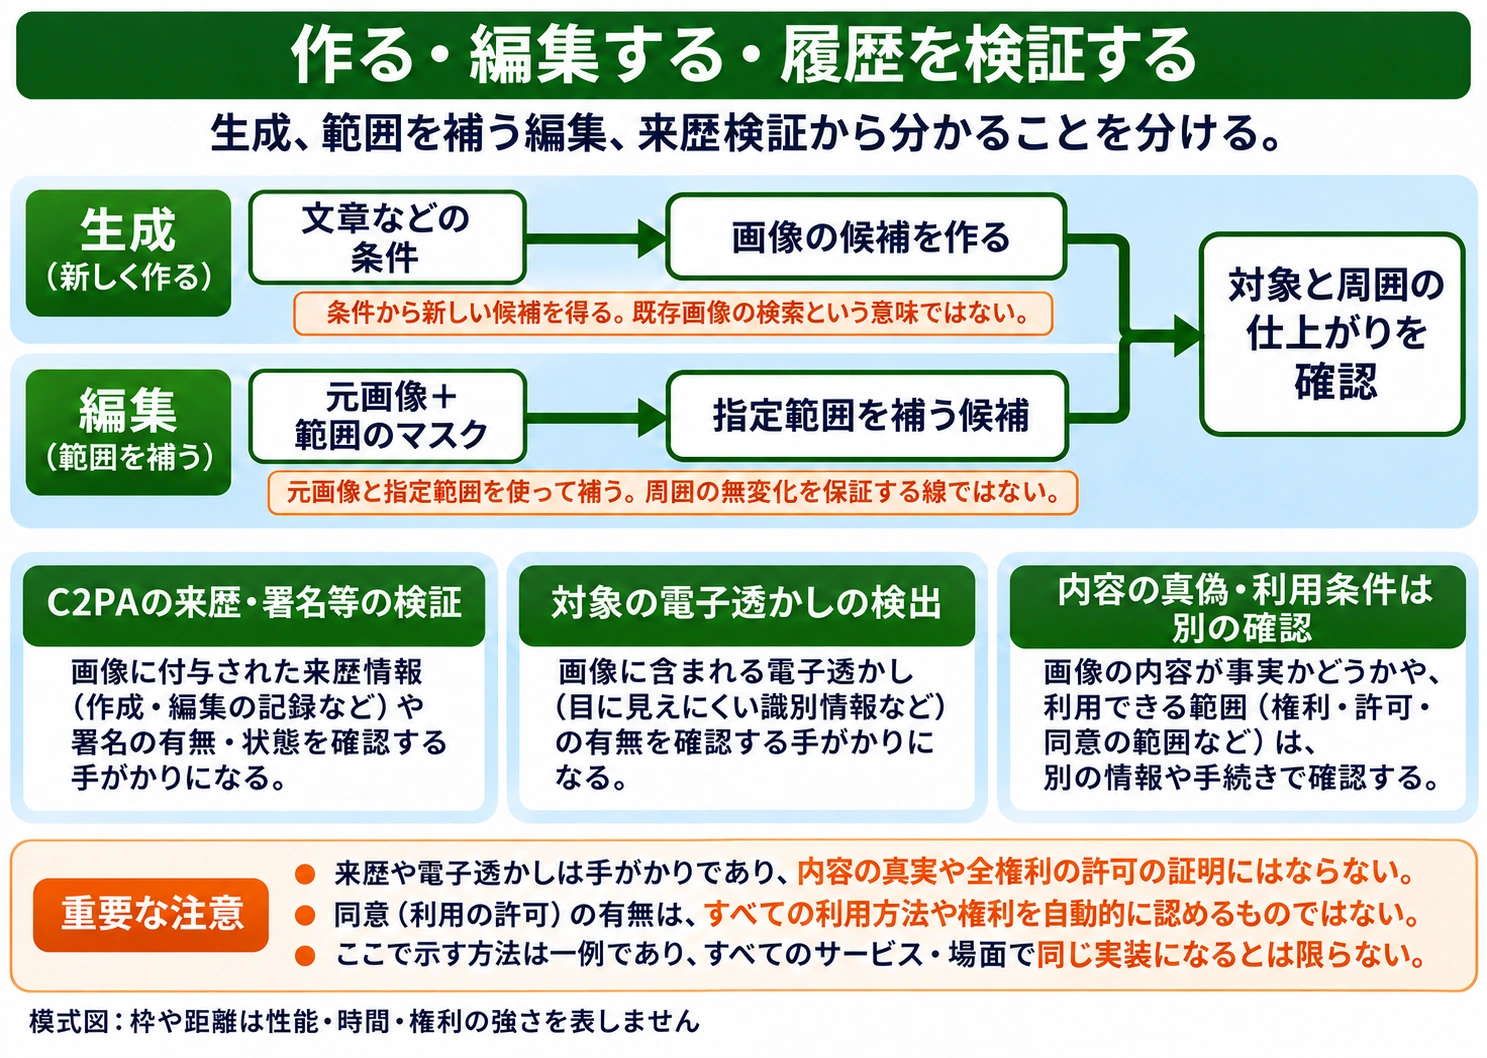
図の内容を文章で確認する
文章から画像を作ることと、元画像の範囲を補うことを分け、結果を確かめる。来歴や透かしは手がかりであり、内容の真実や全権利の許可の証明へ置き換えない。
- 表題と判断
- 作る・編集する・履歴を検証する。生成、範囲を補う編集、来歴検証から分かることを分ける。
- 生成の経路
- 生成(新しく作る):文章などの条件 → 画像の候補を作る → 対象と周囲の仕上がりを確認。条件から新しい候補を得る。既存画像の検索という意味ではない。
- 編集の経路
- 編集(範囲を補う):元画像+範囲のマスク → 指定範囲を補う候補 → 対象と周囲の仕上がりを確認。元画像と指定範囲を使って補う。周囲の無変化を保証する線ではない。
- C2PAの来歴・署名等の検証
- 画像に付与された来歴情報(作成・編集の記録など)や署名の有無・状態を確認する手がかりになる。
- 対象の電子透かしの検出
- 画像に含まれる電子透かし(目に見えにくい識別情報など)の有無を確認する手がかりになる。
- 内容の真偽・利用条件は別の確認
- 画像の内容が事実かどうかや、利用できる範囲(権利・許可・同意の範囲など)は、別の情報や手続きで確認する。
- 重要な注意1
- 来歴や電子透かしは手がかりであり、内容の真実や全権利の許可の証明にはならない。
- 重要な注意2
- 同意(利用の許可)の有無は、すべての利用方法や権利を自動的に認めるものではない。
- 重要な注意3
- ここで示す方法は一例であり、すべてのサービス・場面で同じ実装になるとは限らない。
- 模式図の凡例
- 枠や距離は性能・時間・権利の強さを表しません。
図の枠や距離は性能・時間・権利の強さを表しません。長い注記は拡大画面の「見る位置」で意味ごとに分けて読めます。文章版も続けて読めます。
根拠:High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗ / Use generative remove — Adobe Firefly(別タブで開く) ↗ / Google SynthID(別タブで開く) ↗ / C2PA Explainer 2.4(別タブで開く) ↗ / C2PA FAQs(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。公式問題や試験全体の難易度を再現したものではありません。
2音楽の雰囲気を指定すれば、公開まで決まる?
スライドに落ち着いた音楽を付けたい。曲ができたら、入力した素材も自由に使えることになる?
音楽の雰囲気を指定すれば、公開まで決まる?
この話で学ぶこと:同じ音楽を聴く経路を作り、用途の確認と歌詞素材の未確認を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
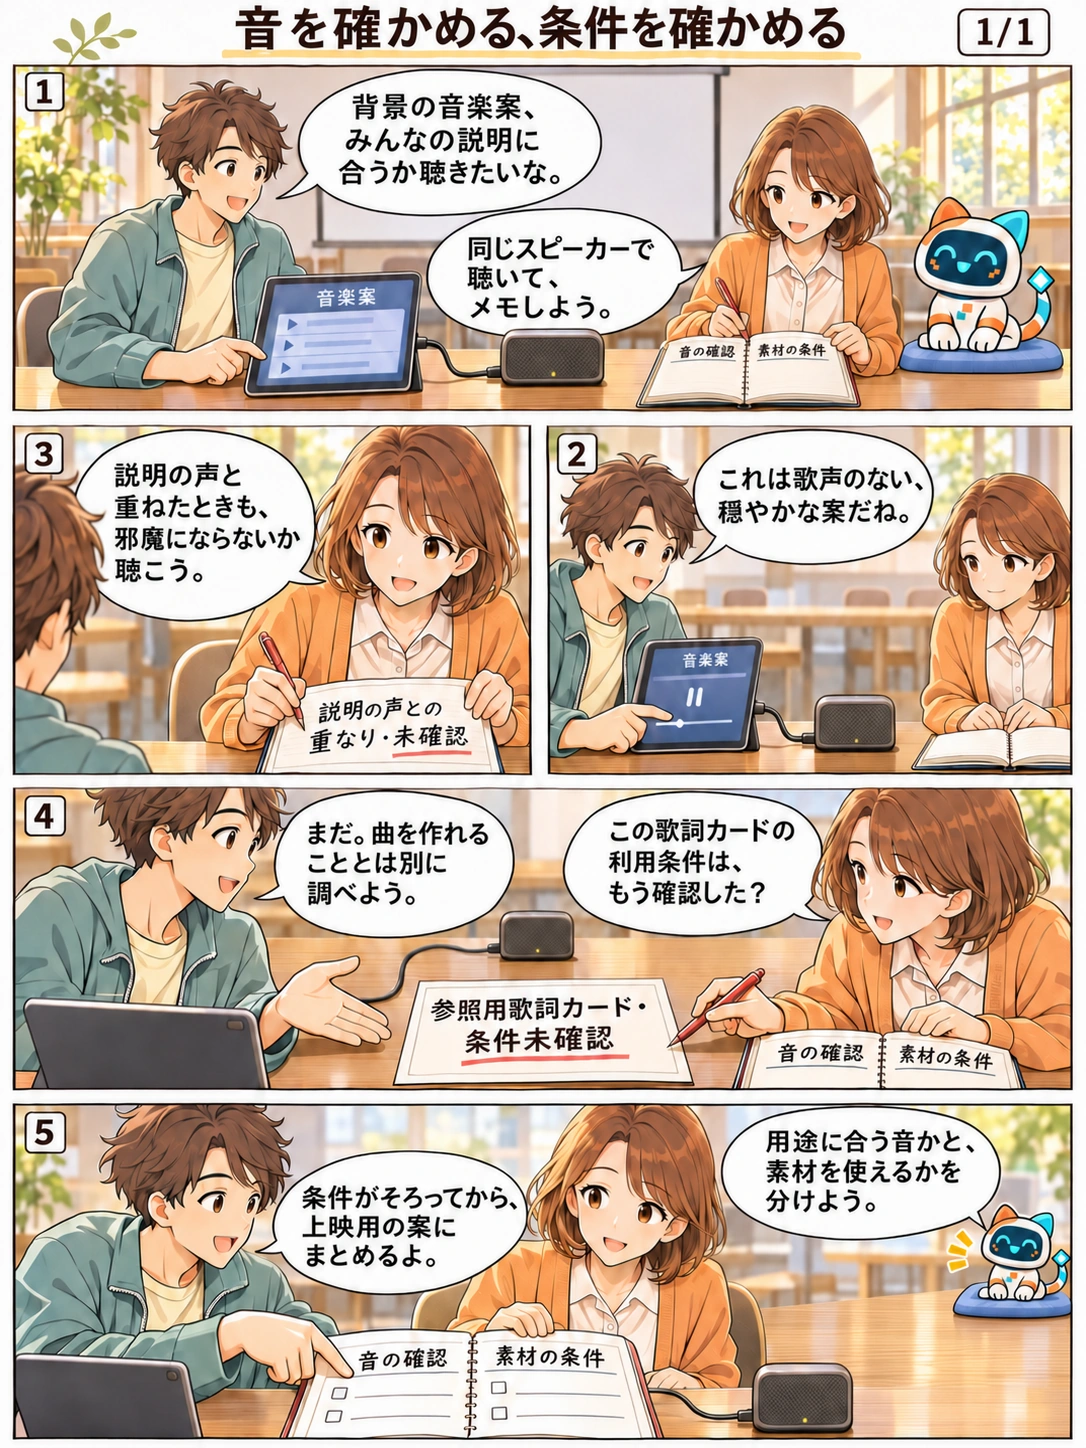
会話を文章で読む
場面:集会所で同じスピーカーを使い、ハルとミオが音楽案を聴きます。
ハル「背景の音楽案、みんなの説明に合うか聴きたいな。」 ミオ「同じスピーカーで聴いて、メモしよう。」場面:歌声のない穏やかな案をハルが確かめます。
ハル「これは歌声のない、穏やかな案だね。」場面:ミオは説明の声との重なりが未確認だとメモします。
ミオ「説明の声と重ねたときも、邪魔にならないか聴こう。」場面:ミオが歌詞カードの条件を尋ね、ハルがまだ調べていないと答えます。右のミオから左のハルへ読みます。
ミオ「この歌詞カードの利用条件は、もう確認した?」 ハル「まだ。曲を作れることとは別に調べよう。」場面:ビットが音と素材の条件を分け、ハルは条件がそろってから上映用の案にまとめると話します。
ビット「用途に合う音かと、素材を使えるかを分けよう。」 ハル「条件がそろってから、上映用の案にまとめるよ。」
集会所で同じ音楽案を聴いたHaruとMioは、雰囲気だけでなく、話し声の邪魔にならないかをメモしました。机の歌詞カードについては、利用条件をまだ確認していません。音楽を作る指示と、素材や公開の条件を分けて考えましょう。
音のつながりを学び、音楽の候補を作る
音楽生成AIは、学習した音楽の特徴や、文章などで与えた条件を使って音楽を作るものです。曲調、楽器、速さ、歌声の有無などを条件にし、音の流れを持つ音楽の候補を得ます。音楽を説明する文章をそのまま読み上げることや、既存曲の検索とは区別します。
仕組みの一例として、2026年3月更新のLyria 3のモデルカードは、文章を入力し、音楽の音声と歌詞の文章を出力すると説明しています。内部では、音の時間的な特徴を圧縮した潜在表現で拡散を用います。潜在表現は、音や画像の特徴をモデル内部で扱う表し方です。このモデルの方式を、全ての音楽生成AIに共通だとはしません。
根拠:Lyria 3 Model Card — Google DeepMind(別タブで開く) ↗ / Generate music with Gemini Apps(別タブで開く) ↗ / High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗
道具の入力から、使い道に合う音へ
Gemini Appsの公式案内には、Lyriaを使い、欲しい曲を文章で説明して音楽や歌詞を作る例があります。例えば「穏やかな木琴中心、ゆっくり、歌声なし」と伝え、スライドの背景音楽の案を得る使い方です。出力された曲を利用する機能と、個別の素材や公開の権利条件は別に読みます。提供条件は対象のアカウント向けの公式案内で確認します。
背景音楽では、話し声を妨げないか、場面の長さに合うか、始まりと終わりが不自然でないかを聴いて確かめます。歌詞がある場合は、その言葉や発音も確認します。短い試聴で雰囲気が合ったことだけでは、全体の仕上がりや利用条件の確認は終わりません。
作る段階と、公開する段階を分ける
既存曲の音源や歌詞などを参照素材へ使うなら、その素材を入力・利用してよいかを確認します。生成ツールの規約が生成物の利用を認めていても、第三者が持つ元の歌詞や音源の権利まで代わりに許可したとは限りません。ダウンロードできることや、有料契約であることも、全権利の確認済みを意味しません。
文化庁の2024年4月の概要は、生成が適法に行える場合でも、公開などの利用が直ちに適法になるわけではなく、場面ごとの判断が必要と説明しています。元の作品との創作的な表現の共通性や、それをもとに作ったか、権利制限の対象かなどの条件も関わります。音楽案では参照素材、提供者の条件、公開先と使い方を確認し、この教材だけで個別の法務確認が済んだとは扱いません。
根拠:文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗ / Generate music with Gemini Apps(別タブで開く) ↗
 図を拡大する ↗
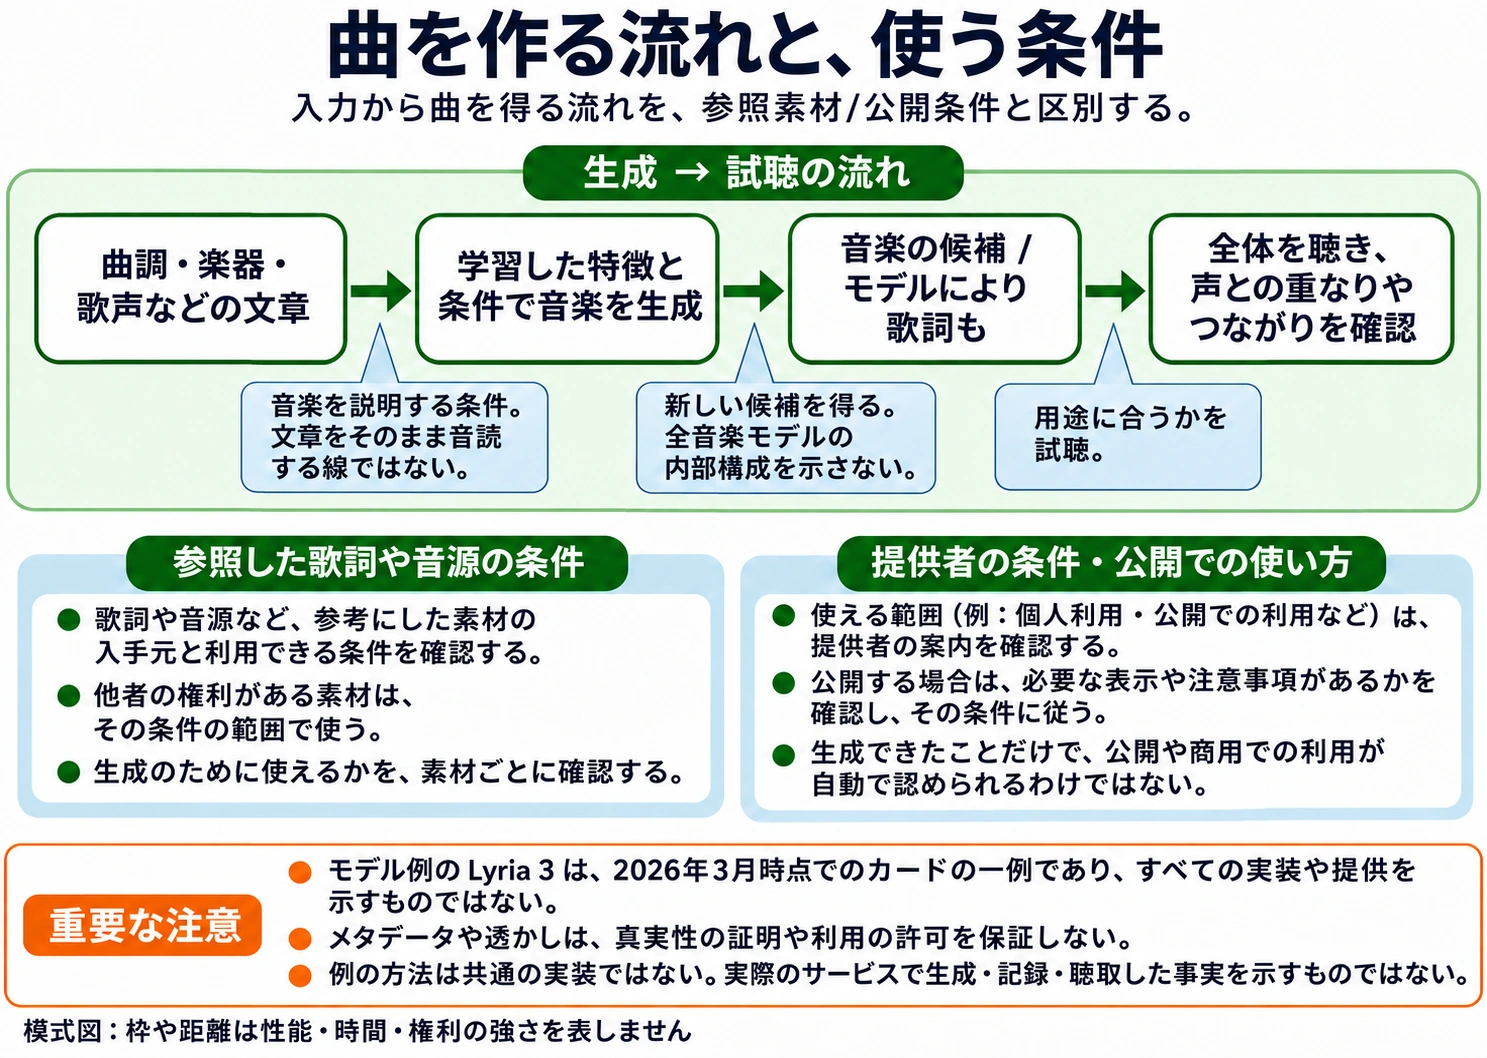
図の内容を文章で確認する
曲調や楽器などを文章で伝え、音楽の候補を聴いて用途へ合わせる。参照素材の条件と、生成曲を公開する条件を、曲が作れたことだけで完了としない。
- 表題と判断
- 曲を作る流れと、使う条件。入力から曲を得る流れを、参照素材/公開条件と区別する。
- 生成から試聴への経路
- 曲調・楽器・歌声などの文章 → 学習した特徴と条件で音楽を生成 → 音楽の候補/モデルにより歌詞も → 全体を聴き、声との重なりやつながりを確認。
- 三つの矢印の意味
- 一つ目は音楽を説明する条件。文章をそのまま音読する線ではない。二つ目は新しい候補を得る。全音楽モデルの内部構成を示さない。三つ目は用途に合うかを試聴。
- 参照した歌詞や音源の条件
- 歌詞や音源など、参考にした素材の入手元と利用できる条件を確認する。他者の権利がある素材は、その条件の範囲で使う。生成のために使えるかを、素材ごとに確認する。
- 提供者の条件・公開での使い方
- 使える範囲(例:個人利用・公開での利用など)は、提供者の案内を確認する。公開する場合は、必要な表示や注意事項があるかを確認し、その条件に従う。生成できたことだけで、公開や商用での利用が自動で認められるわけではない。
- 重要な注意1・モデル例と日付
- モデル例の Lyria 3 は、2026年3月時点でのカードの一例であり、すべての実装や提供を示すものではない。
- 重要な注意2
- メタデータや透かしは、真実性の証明や利用の許可を保証しない。
- 重要な注意3
- 例の方法は共通の実装ではない。実際のサービスで生成・記録・聴取した事実を示すものではない。
- 模式図の凡例
- 枠や距離は性能・時間・権利の強さを表しません。
図の枠や距離は性能・時間・権利の強さを表しません。長い注記は拡大画面の「見る位置」で意味ごとに分けて読めます。文章版も続けて読めます。
根拠:Lyria 3 Model Card — Google DeepMind(別タブで開く) ↗ / Generate music with Gemini Apps(別タブで開く) ↗ / High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。公式問題や試験全体の難易度を再現したものではありません。
3文章を読む声と、特定の人の声の再現は同じ?
案内文を読み上げたい。手元に録音があれば、その人に似た声で公開してよい?
文章を読む声と、特定の人の声の再現は同じ?
この話で学ぶこと:提供音声でのTTSと本人の声の再現、店内と公開の範囲を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
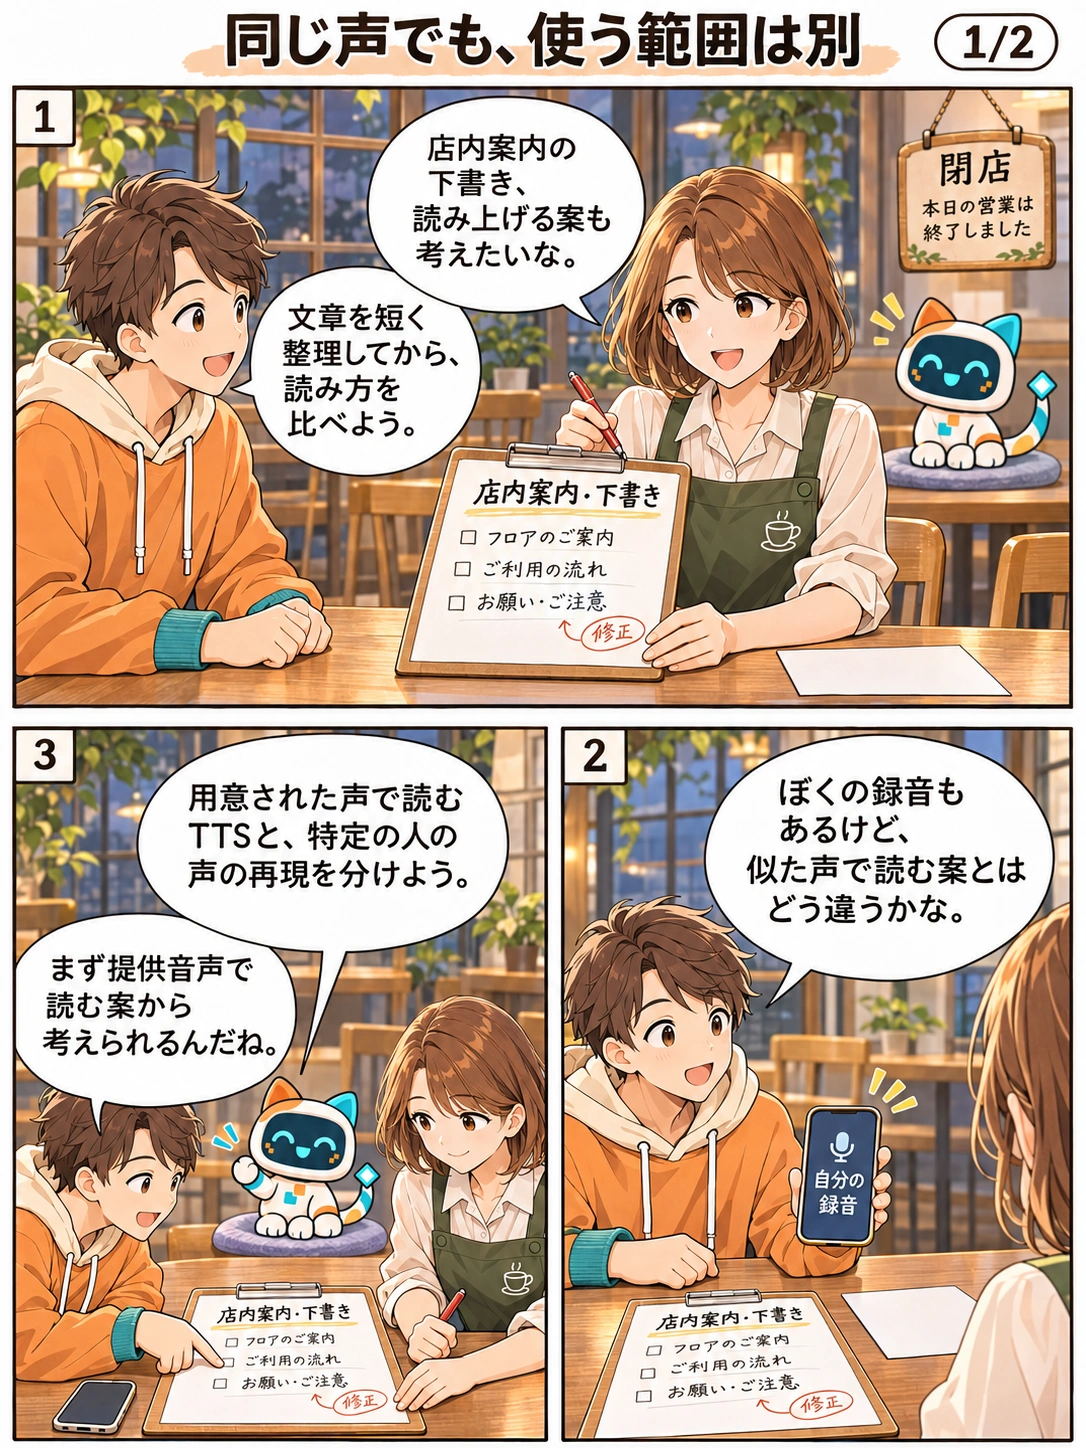
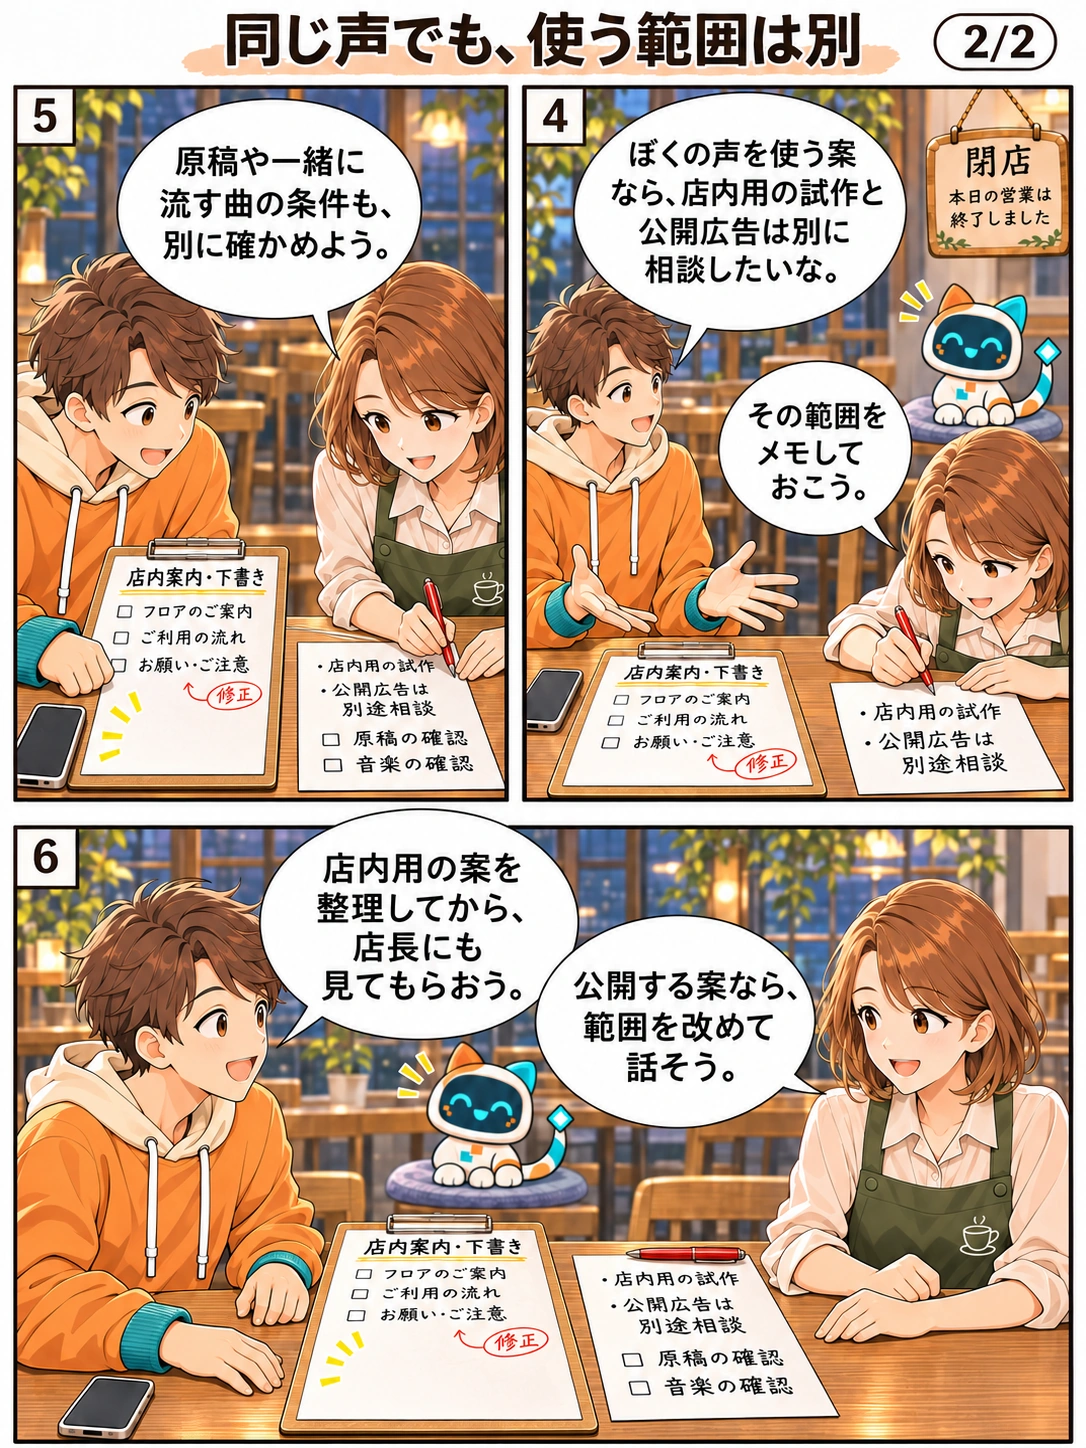
会話を文章で読む
場面:閉店後、ミオが店内案内の下書きを見せ、ハルと読み方を相談します。
ミオ「店内案内の下書き、読み上げる案も考えたいな。」 ハル「文章を短く整理してから、読み方を比べよう。」場面:ハルが自分の録音を示し、似た声で読む案との違いを尋ねます。録音内容の再生や合成は描いていません。
ハル「ぼくの録音もあるけど、似た声で読む案とはどう違うかな。」場面:ビットが提供音声と特定人の声を分け、ハルが提供音声から考えます。
ビット「用意された声で読むTTSと、特定の人の声の再現を分けよう。」 ハル「まず提供音声で読む案から考えられるんだね。」場面:ハルは店内用の試作と公開広告を分けて相談したいと話し、ミオが別の確認紙に記録します。
ハル「ぼくの声を使う案なら、店内用の試作と公開広告は別に相談したいな。」 ミオ「その範囲をメモしておこう。」場面:ミオは原稿や音楽の条件も別に確認しようと話します。確認紙のチェック欄は未選択です。
ミオ「原稿や一緒に流す曲の条件も、別に確かめよう。」場面:ハルが店長にも見てもらうと話し、ミオは公開するなら範囲を改めて相談すると答えます。机上には二枚の紙、一本の赤ペン、一台の電話が残っています。
ハル「店内用の案を整理してから、店長にも見てもらおう。」 ミオ「公開する案なら、範囲を改めて話そう。」
閉店後、Mioが店内案内の下書きを見せると、Haruは自分の録音も使えるかと尋ねました。二人は、提供されている音声で読む方法と、特定の人に似た声を作る場合を分けました。店内の案内と公開用の広告も、同じ範囲の依頼とは決めません。
文章から声を合成する
音声生成AIは、声などの音声を新しく作る仕組みです。TTS(Text-to-Speech)は文章を音声へ変える読み上げで、ニューラルTTSは、深いニューラルネットワークを使って発音や抑揚などを扱う合成方式です。録音を文章へ変える音声認識とは、入力と出力の向きが違います。
Google Cloud Text-to-Speechの基本資料では、文章と使用する音声などを指定し、合成した音声データを得ます。MicrosoftのText to speechの概要も、用意された標準のneural音声(ニューラル音声)と、独自の声を作る選択肢を分けています。neuralは、ニューラルネットワークで音声を合成する方式の呼び名です。例えば自分たちで書いた会場案内を、提供音声で読み上げる用途です。特定の知人の録音を用意しないと読み上げができない、という意味ではありません。
根拠:Text to speech overview — Microsoft Learn(別タブで開く) ↗ / Cloud Text-to-Speech basics(別タブで開く) ↗
特定の人の声には、対象を定めた同意を
Voice Cloning(声の複製)は、特定の人の声の特徴を録音などから捉え、その人に似た声を合成する技術です。声の特徴をもとにする準備と、用意した文章をその声で読み上げる段階を分けます。提供音声を選ぶ通常のTTSを、毎回、自分が特定人の声を複製する作業だと捉えません。
本人の同意は、その人が何のために、どの範囲で自分の声などを使うことを認めたかを確かめるものです。MicrosoftのPersonal voiceの公式手順にも、声を使う本人から明示的な同意を得て記録する工程があります。録音ファイルを持っているだけで、複製や公開まで許されたとはしません。社内用、店内用、公開広告など、使いたい範囲が同意と合うかを確認します。
根拠:Add user consent for personal voice — Microsoft Learn(別タブで開く) ↗ / Text to speech overview — Microsoft Learn(別タブで開く) ↗
読み方、公開範囲、他の権利を確認する
案内音声では、原稿の内容、固有名詞の読み、数字、話す速さや間が適切かを確認します。自然に聞こえても、その人が実際に話した録音だとは限りません。声の合成を使う目的に応じて、聞き手が本人の実際の発言と取り違えない伝え方も考えます。
本人が声の利用に同意したことは、原稿や背景音楽など第三者の権利、サービスの規約、公開先の条件を一括して許可したことではありません。まず誰の何をどこで使うかをそろえ、本人の声の範囲と、他の素材や公開の条件を別々に確認します。個別の法的適合をこの説明だけで認定するものではありません。
根拠:Cloud Text-to-Speech basics(別タブで開く) ↗ / Text to speech overview — Microsoft Learn(別タブで開く) ↗ / NIST AI100-4 Reducing Risks Posed by Synthetic Content(別タブで開く) ↗ / Add user consent for personal voice — Microsoft Learn(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
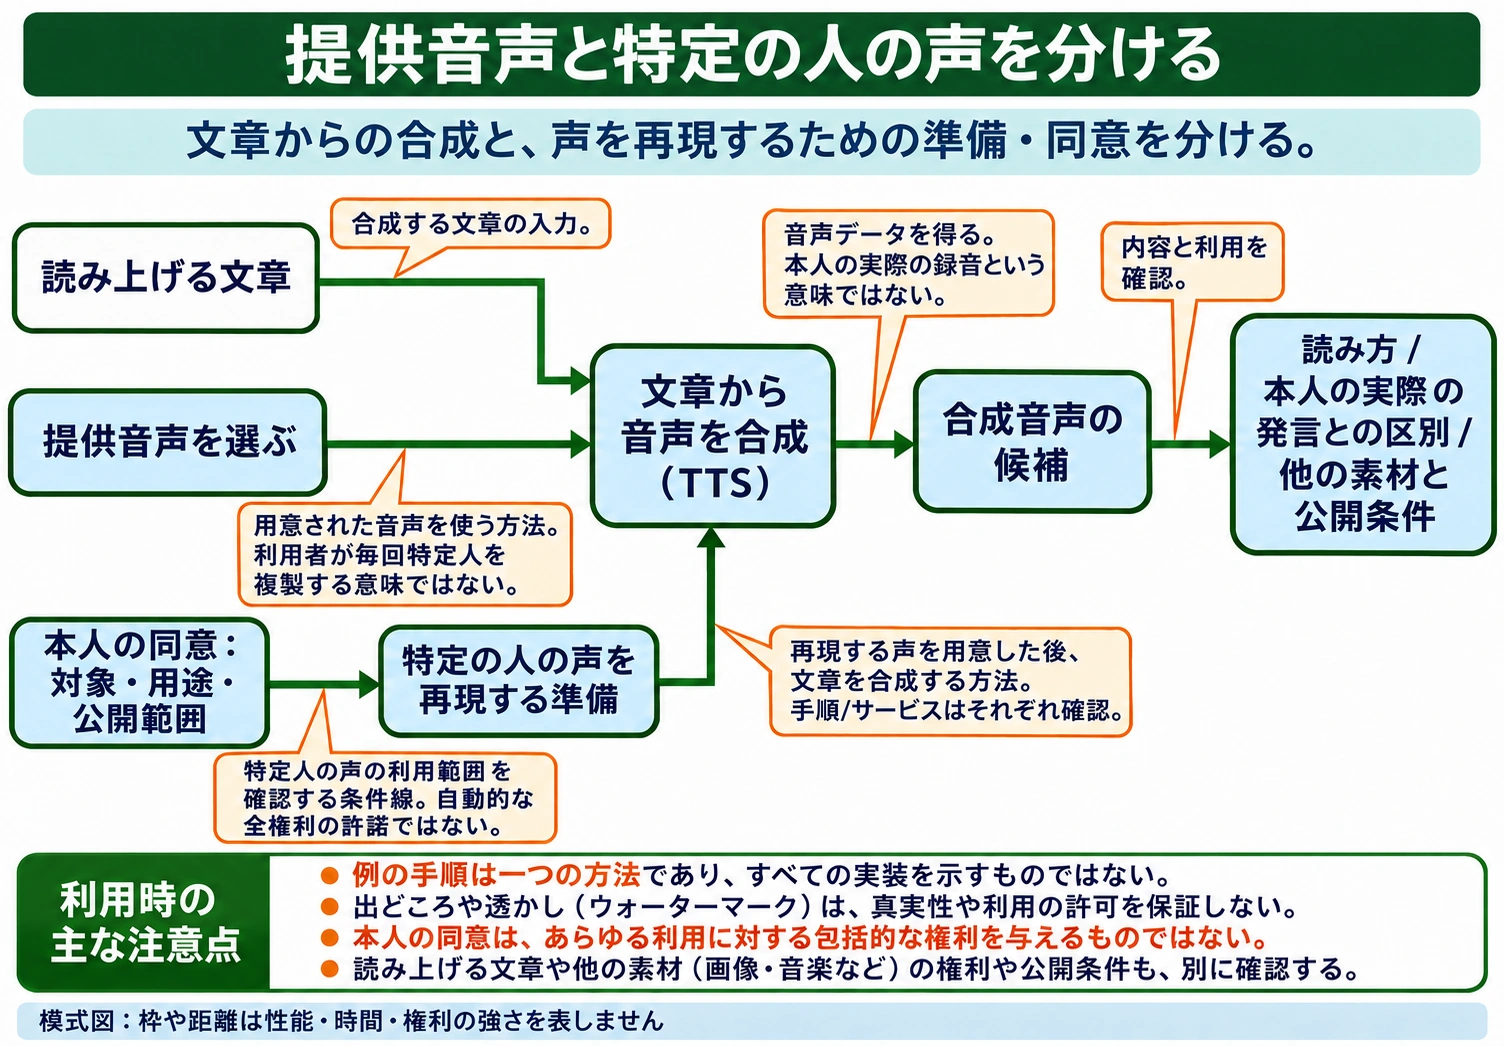 図を拡大する ↗
図の内容を文章で確認する
文章を音声へ合成するTTSでは、用意された音声を選ぶ方法がある。特定人の声を再現する場合は本人の同意と範囲を確認し、読み上げる文章や他の素材の権利を別に確かめる。
- 表題と判断
- 提供音声と特定の人の声を分ける。文章からの合成と、声を再現するための準備・同意を分ける。
- 提供音声の経路
- 読み上げる文章 → 文章から音声を合成(TTS)。提供音声を選ぶ → 文章から音声を合成(TTS)。用意された音声を使う方法。利用者が毎回特定人を複製する意味ではない。文章の矢印は合成する文章の入力。
- 特定人の声の準備の経路
- 本人の同意:対象・用途・公開範囲 → 特定の人の声を再現する準備 → 文章から音声を合成(TTS)。特定の人の声の利用範囲を確認する条件線。自動的な全権利の許諾ではない。再現する声を用意した後、文章を合成する方法。手順/サービスはそれぞれ確認。
- 合成した出力と確認の経路
- 文章から音声を合成(TTS) → 合成音声の候補 → 読み方/本人の実際の発言との区別/他の素材と公開条件。音声データを得る。本人の実際の録音という意味ではない。最後の矢印は内容と利用を確認。
- 利用時の主な注意点1
- 例の手順は一つの方法であり、すべての実装を示すものではない。
- 利用時の主な注意点2
- 出どころや透かし(ウォーターマーク)は、真実性や利用の許可を保証しない。
- 利用時の主な注意点3
- 本人の同意は、あらゆる利用に対する包括的な権利を与えるものではない。
- 利用時の主な注意点4
- 読み上げる文章や他の素材(画像・音楽など)の権利や公開条件も、別に確認する。
- 模式図の凡例
- 枠や距離は性能・時間・権利の強さを表しません。
図の枠や距離は性能・時間・権利の強さを表しません。長い注記は拡大画面の「見る位置」で意味ごとに分けて読めます。文章版も続けて読めます。
根拠:Text to speech overview — Microsoft Learn(別タブで開く) ↗ / Cloud Text-to-Speech basics(別タブで開く) ↗ / Add user consent for personal voice — Microsoft Learn(別タブで開く) ↗ / NIST AI100-4 Reducing Risks Posed by Synthetic Content(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。公式問題や試験全体の難易度を再現したものではありません。
4動いて見える映像は、実際に起きた記録?
映像の一場面は自然。でも、前後の動きや「誰の実際の発言か」まで分かったことになる?
動いて見える映像は、実際に起きた記録?
この話で学ぶこと:時間のつながりと、合成案/実際の記録の区別を結び付ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
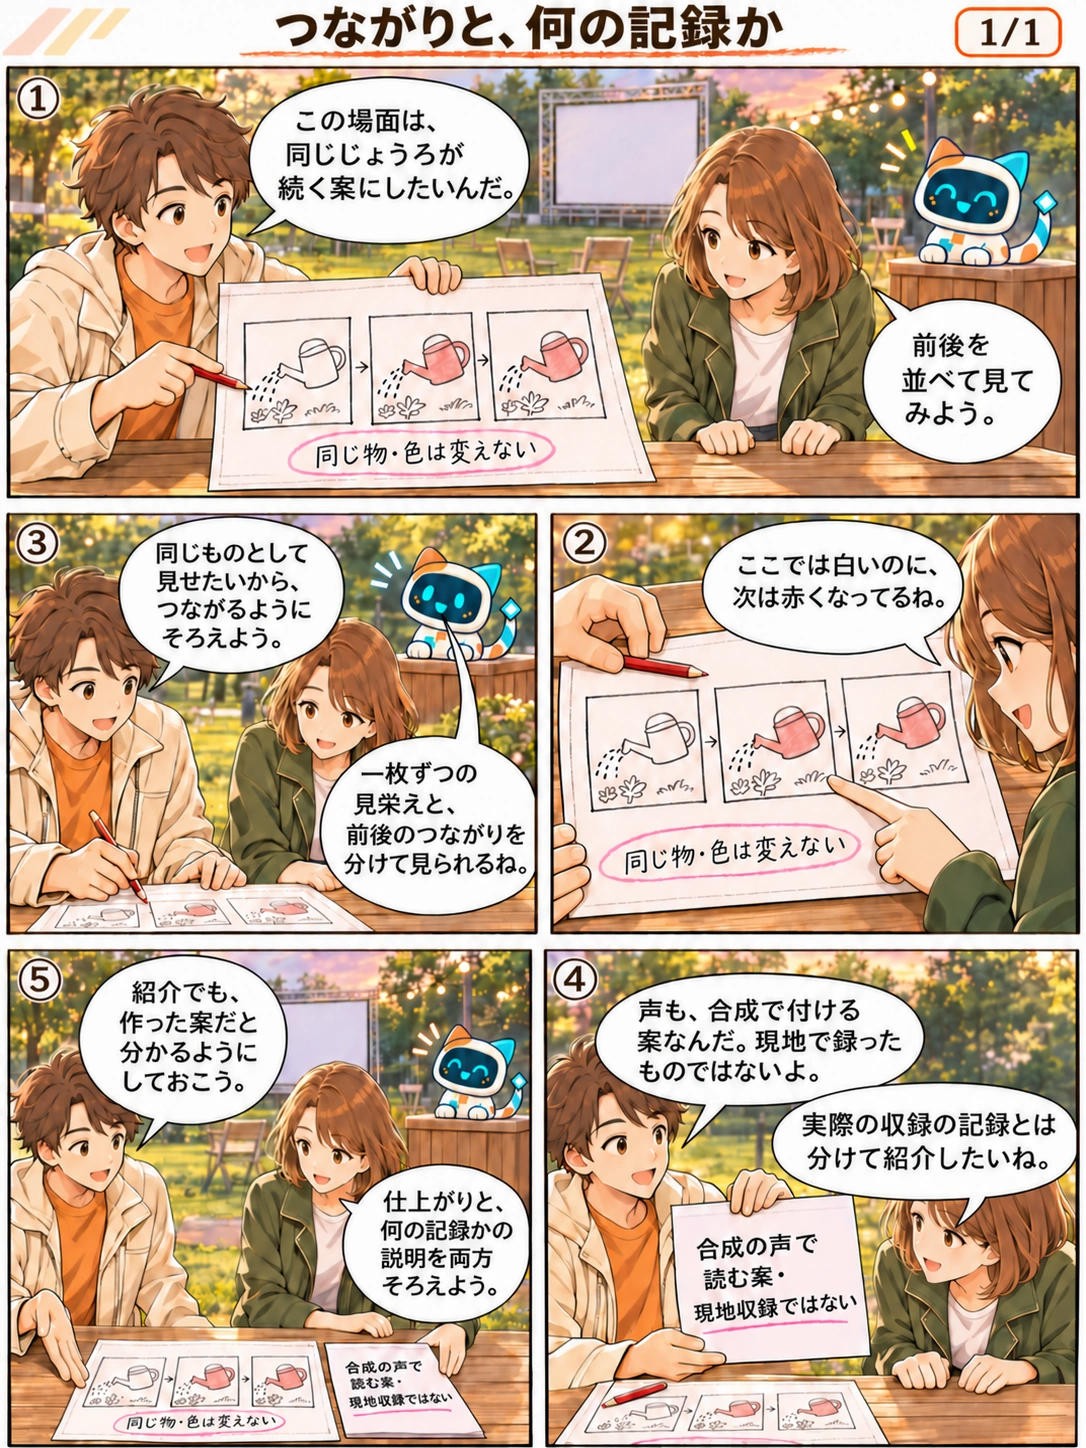
会話を文章で読む
場面:野外上映の下見で絵コンテを比べます。じょうろが白から赤になるのは意図的な不一致です。
ハル「この場面は、同じじょうろが続く案にしたいんだ。」 ミオ「前後を並べて見てみよう。」場面:ミオが前後のじょうろの色の違いに気づきます。
ミオ「ここでは白いのに、次は赤くなってるね。」場面:ハルが同じものとしてのつながりを問い、ビットが一枚の見栄えと前後のつながりを分けます。
ハル「同じものとして見せたいから、つながるようにそろえよう。」 ビット「一枚ずつの見栄えと、前後のつながりを分けて見られるね。」場面:ハルが合成する声の案を現地収録と呼ばないと説明し、ミオが実際の収録記録と分けて紹介しようと話します。
ハル「声も、合成で付ける案なんだ。現地で録ったものではないよ。」 ミオ「実際の収録の記録とは分けて紹介したいね。」場面:ハルとミオは作った案だと分かる説明と仕上がりを両方そろえると決めます。
ハル「紹介でも、作った案だと分かるようにしておこう。」 ミオ「仕上がりと、何の記録かの説明を両方そろえよう。」
野外上映の下見で、HaruとMioは同じ絵コンテの前後を比べ、小物のつながりに気づきました。さらに、これから合成する声の案を現地で収録した記録とは呼ばないと確認しました。動画は、時間のつながりと、何の記録として伝えるかの両方を考えます。
時間のつながりを持つ映像を作る
動画生成AIは、文章や画像などの条件から、時間に沿って変化する映像を作るものです。映像を構成する一枚一枚の画像をフレームと呼びます。一枚の形だけでなく、物の位置や動き、場面が前後でどうつながるかも扱います。入力した静止画像が一枚でも、出力は新しい動きを含む動画の候補になり得ます。
仕組みの一例として、Veo 3のモデルカードは、文章や画像から音声付き動画を作り、空間と時間を持つ潜在表現に拡散を用いると説明しています。今回取得したカードは公開日2025年5月23日、更新日2026年1月13日です。当該モデルの説明であり、全動画AIが同じ方式という意味や、古いAPIの利用例を現在も使えるという案内ではありません。
根拠:Create videos in Google Flow(別タブで開く) ↗ / Veo 3 Model Card(別タブで開く) ↗
道具へ場面を伝え、できた流れを確かめる
現在の道具の例としてGoogle Flowの公式案内では、被写体、動き、環境、照明などを文章で伝えて動画を作り、画像を参照や始め・終わりのフレームとして使えます。例えば自作の街並みの絵と「看板の横をゆっくり進む」という説明から、紹介映像の案を比べる使い方です。対象モデルや地域などの提供条件は、その時点のFlowの案内を確認します。
映像案は、最初の一枚だけでなく前後を見て、人物や小物の数、手の接続、文字、位置や動きのつながりを確認します。参照画像を与えたことや、拡散モデルを使ったことだけで、それらが意図どおり保たれたとは判断しません。下書きや撮影前の検討に役立つことと、事実を撮影した映像であることも別です。
根拠:Create videos in Google Flow(別タブで開く) ↗ / Veo 3 Model Card(別タブで開く) ↗ / NIST AI100-4 Reducing Risks Posed by Synthetic Content(別タブで開く) ↗
人物の再現と、本人の実際の言動を分ける
ディープフェイクは、深層学習を使って人の顔や声などを本物らしく合成・改変する技術や、その生成物を指します。人物が実際にはしていない発言や動作を、本人の記録のように受け取らせる危険があります。生成AIによる架空の風景作成と、特定の人の言動のように見せる利用は、確認する内容が同じではありません。
顔や声の利用に本人が同意していても、できた台詞が本人の実際の発言だったことにはなりません。来歴の検証や透かしも、その発言や出来事の真実を保証しません。紹介するときは生成・加工した内容であることや、どの範囲の協力を得たかを確かめ、実際の撮影・録音記録と混同させない扱いを考えます。他の素材や公開条件の確認も残ります。
根拠:NIST AI100-4 Reducing Risks Posed by Synthetic Content(別タブで開く) ↗ / C2PA Explainer 2.4(別タブで開く) ↗ / Add user consent for personal voice — Microsoft Learn(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
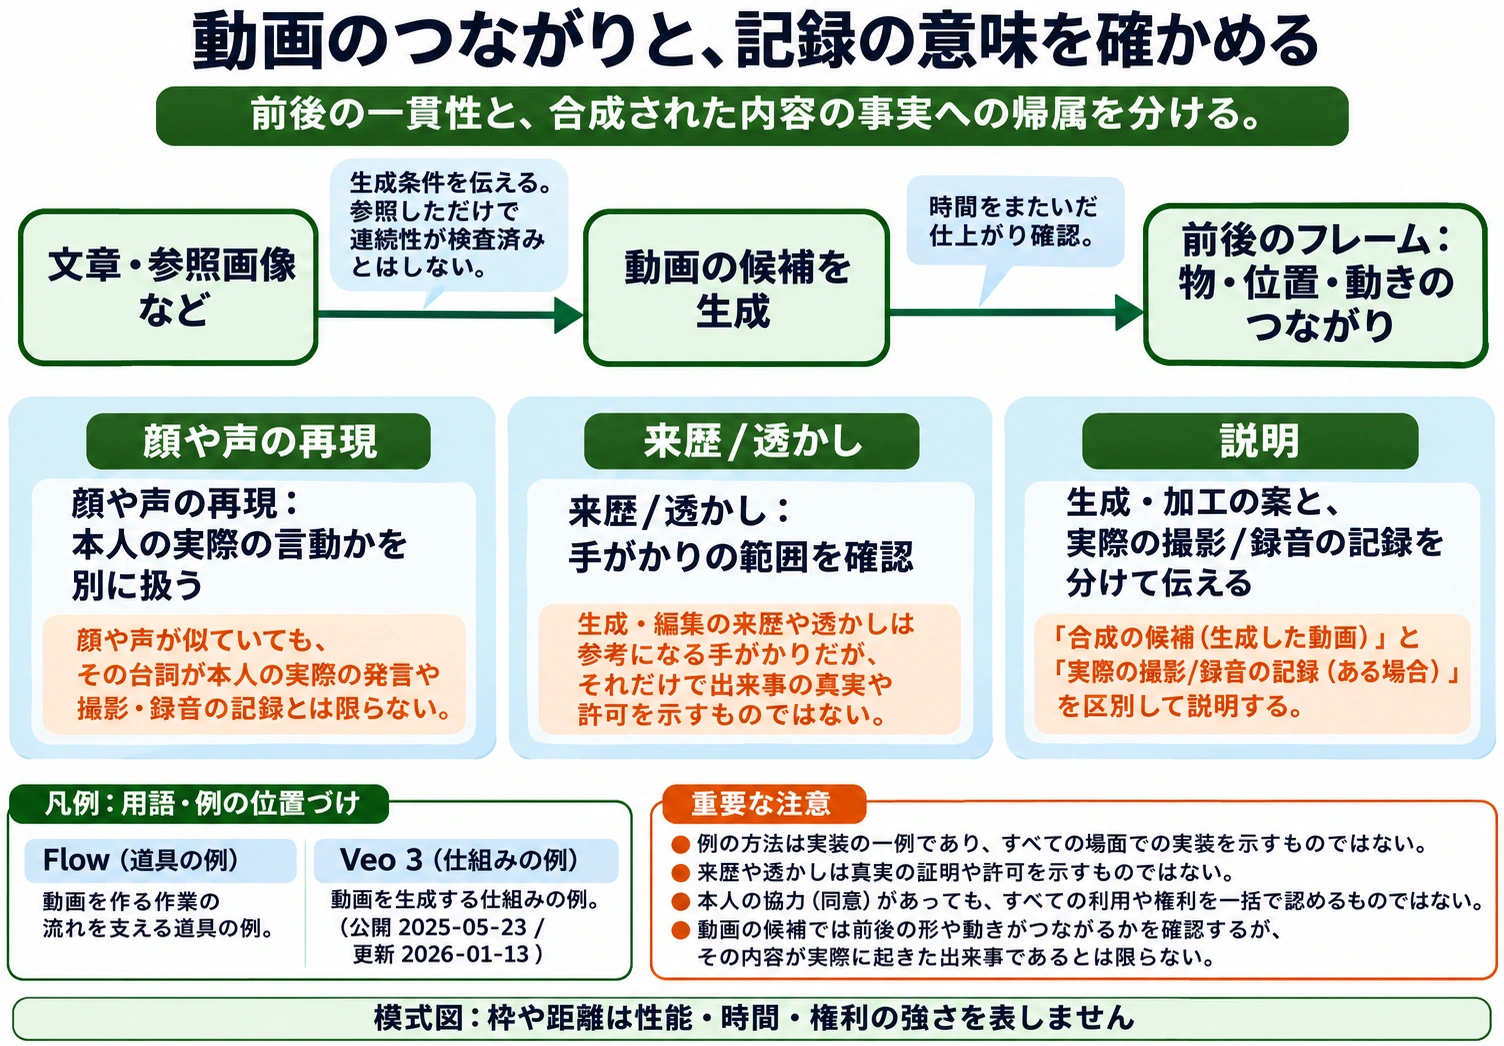 図を拡大する ↗
図の内容を文章で確認する
動画の候補では前後の形や動きがつながるかを確認する。人物の顔や声の再現、本人の協力、来歴があっても、その台詞が実際に発言された撮影記録という意味にはならない。
- 表題と判断
- 動画のつながりと、記録の意味を確かめる。前後の一貫性と、合成された内容の事実への帰属を分ける。
- 二つの矢印と経路
- 文章・参照画像など → 動画の候補を生成 → 前後のフレーム・物・位置・動きのつながり。入力の矢印は生成条件を伝える。参照しただけで連続性が検査済みとはしない。確認の矢印は時間をまたいだ仕上がり確認。
- 顔や声の再現
- 顔や声の再現:本人の実際の言動かを別に扱う。顔や声が似ていても、その台詞が本人の実際の発言や撮影・録音の記録とは限らない。
- 来歴/透かし
- 来歴/透かし:手がかりの範囲を確認。生成・編集の来歴や透かしは参考になる手がかりだが、それだけで出来事の真実や許可を示すものではない。
- 説明
- 生成・加工の案と、実際の撮影/録音の記録を分けて伝える。「合成の候補(生成した動画)」と「実際の撮影/録音の記録(ある場合)」を区別して説明する。
- 凡例:Flow(道具の例)
- 動画を作る作業の流れを支える道具の例。
- 凡例:Veo 3(仕組みの例)と日付
- 動画を生成する仕組みの例。(公開 2025-05-23 / 更新 2026-01-13)。公開日と更新日は別の日付です。
- 重要な注意1
- 例の方法は実装の一例であり、すべての場面での実装を示すものではない。
- 重要な注意2
- 来歴や透かしは真実の証明や許可を示すものではない。
- 重要な注意3
- 本人の協力(同意)があっても、すべての利用や権利を一括で認めるものではない。
- 重要な注意4
- 動画の候補では前後の形や動きがつながるかを確認するが、その内容が実際に起きた出来事であるとは限らない。
- 模式図の凡例
- 枠や距離は性能・時間・権利の強さを表しません。
図の枠や距離は性能・時間・権利の強さを表しません。長い注記は拡大画面の「見る位置」で意味ごとに分けて読めます。文章版も続けて読めます。
根拠:Create videos in Google Flow(別タブで開く) ↗ / Veo 3 Model Card(別タブで開く) ↗ / NIST AI100-4 Reducing Risks Posed by Synthetic Content(別タブで開く) ↗ / C2PA Explainer 2.4(別タブで開く) ↗ / Add user consent for personal voice — Microsoft Learn(別タブで開く) ↗ / 文化庁「AIと著作権に関する考え方について」概要(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。公式問題や試験全体の難易度を再現したものではありません。