この教材の目次を開く
回答はこのページを開いている間だけ保持します。別のページへ移動・再読み込みすると消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
1入力から予測へ、何がつながっているか
脳に似た名前の仕組みは、何を計算している?
この節で使う言葉:ニューラルネットワーク・層・重み・活性化関数・深層学習
この節の学習目標:入力・隠れ・出力の層と重みの役割を説明し、深層学習を機械学習の中へ位置付けられる。
友だちに渡す旅のアルバムを、出来事の順に並べたい二人。「海辺」という分類結果を見たハルは、山のあとに寄った海だと考え、写真を最後へ貼ろうとします。ミオは、山へ向かう前の朝にも海へ寄ったことを思い出します。この一枚はいつの写真でしょうか。貼る手を止め、モデルの計算と、写真を並べるための手がかりを確かめます。
まず入力から出力へ進む道を追い、その途中の計算と、学習で調整する値を分けます。
この海辺は、旅の最後?
この話で学ぶこと:海辺という分類から、撮影時刻や旅行の順番まで分かるわけではない。
会話を文章で読む
場面:博物館の写真体験で、ハル左とミオ右が旅のアルバムの順を考える。ハルは海辺の一枚を持ち、ミオのアルバムの最後の枠は空。ビットは二人の間の机の前縁に座る。
ミオ「友だちに渡すアルバム、この海辺は旅の最後だったっけ。」場面:ハルが海辺写真をアルバムの最後の枠へ近づける。写真はまだ貼っていない。
ハル「「海辺」だ。山の後に寄った海だって、分かったんだね。最後に貼ろう。」場面:ハルの肩越しに一台のPCを見る。海辺写真に予測は海辺、分類先は海辺と山。ミオも画面を見て、机の前縁のビットが写真の前後関係を問いかける。
ビット「この写真だけで、山へ行く前か後かも分かる?」場面:旅の朝、山へ向かう前の海辺をミオが思い出す。ハル左はカメラで撮影し、ミオ右は風で動く髪を押さえる。言葉は現在のミオの声。
ミオ「海には、山へ行く前にも寄ったよ。夕方の一枚とは違うかも。」場面:現在の博物館へ戻る。ハルが同じ海辺写真を手元に戻し、ミオのアルバムの最後の枠にはまだ貼らない。ビットは同じ机の前縁に座る。
ハル「じゃあ、まだ貼らないでおこう。モデルに渡したものを確かめたい。」場面:同じ博物館の机で、ミオが旅の順番は入力していないことを確かめる。海辺写真はまだアルバムへ貼っていない。
ミオ「渡したのは写真だけ。旅の順番は、入れてないね。」場面:ビットが入力から答えまでを確かめるよう提案する。二人の間の机の前縁に座り、ハルは左、ミオは右。
ビット「この体験の、入力から答えまでを確かめてみようか。」場面:ハルの肩越しに、写真の数値から複数の中間層を通り、海辺か山の出力へ至る図を見る。ハルが層の計算を指す。
ハル「写真の数値を層で計算して、海辺か山を出すんだね。」場面:ミオが手元の説明図を見て、重みが次の計算への影響を調整することを確かめる。図には入力、重みとバイアス、次の層が示されている。
ミオ「重みは、次の計算への影響を調整する値なんだね。」場面:ハルとミオがアルバムと海辺写真を見比べる。最後の枠は空いたままで、写真の並べる順はまだ決めていない。
ハル「「深い」でも、旅を体験した証拠にはならない。並べる順は別に確かめよう。」場面:ミオが海辺写真を順番を確認中のトレーへ置く。別の撮影記録を開き、アルバムへ貼る前に記憶と照合しようとする。
ミオ「この一枚はまだ貼らず、撮影記録と私たちの記憶を見比べよう。」
層を通して、入力を予測へ変える
ニューラルネットワークは、神経細胞のつながりに着想を得た、計算を行うモデルです。小さな計算の単位をニューロンやノードと呼び、つながりを通して値を受け渡します。人の脳そのものや、脳の働き全体を再現したものではありません。
ここでは、値が入力側から出力側へ進む基本的な構造を例にします。入力層は、写真を作る小さな点(画素)の色などの値を受け取り、途中の隠れ層(中間層)は計算した値を次へ渡し、出力層は分類などに使う結果を出します。隠れ層は「秘密の答えを保管する場所」という意味ではありません。
予測するときは、この道を入力から出力へ進みます。学習するときは、出した予測と正解などを比べ、つながりに関係する値を調整します。構造をたどることと、学習で値を変えることを分けて読みましょう。ニューラルネットワークには別の接続構造もあり、この図だけがすべての形ではありません。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Google 入力・隠れ・出力の層(別のタブで開く) ↗ / Google ニューラルネットワーク(別のタブで開く) ↗ / Google 機械学習用語集(別のタブで開く) ↗
重みで影響を調整し、活性化関数で値を変換する
重みは、受け取った値が次の計算へどれくらい影響するかを調整する値です。基本的なニューロンでは、入力へ重みを掛けて足し合わせ、バイアスという調整値も加えます。重みやバイアスはモデルが持つパラメータで、写真そのものや正解ラベルとは区別します。
この計算結果を次へ渡す前に変換する働きが活性化関数です。例えばReLUは、負の値を0にし、0以上の値はそのまま出します。活性化関数にはほかの種類もあります。「ニューロンをオンかオフにするだけ」と一つの動作に決め付けません。
一つの計算をつなげてみます。入力2に重み0.5を掛けると1。バイアス-2を加えると-1です。この値をReLUへ渡すと、負なので出力は0になります。「掛けて足す計算」と「活性化関数による変換」を順に追う、小さな例です。
非線形の活性化関数を組み合わせることで、単なる比例や足し算だけでは表せない関係も扱えるようになります。線形の計算だけを何層重ねても、全体としては線形の関係のままです。層を増やすだけで、必ず複雑な関係を学べるわけではありません。どの値を、どの計算へ渡すかが構造の役割です。
例えば、入力を2倍し、さらに3倍して1を足すだけなら、全体は「入力を6倍して1を足す」という一本の直線の関係で表せます。一方、ReLUへ-1・0・1を入れると、出力は0・0・1です。負の側は0で止まり、正の側は入力に合わせて増えるので、0のところで関係が折れ曲がります。このような変換を挟むことが、直線で表す計算だけを重ねる場合との違いです。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Google 活性化関数(別のタブで開く) ↗ / Google モデルの重みの用語(別のタブで開く) ↗
深層学習は、複数の隠れ層を使う学習
深層学習(ディープラーニング)は、複数の隠れ層を持つニューラルネットワークを使う機械学習です。入力に近い層から、さらに計算を重ねた特徴の表し方を学ぶ例があります。AIの方法の中に機械学習、その中に深層学習があります。
「深い」は主に層の重なりを指し、人間のように深く考えることを保証する言葉ではありません。層を増やしたときの性能は、データ、学習の条件、目的に合う評価で確かめます。すべてのAIがニューラルネットワークを使うとも、すべての機械学習が深層学習とも言えません。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Google 深層モデルの用語(別のタブで開く) ↗ / Google 誤差逆伝播(別のタブで開く) ↗
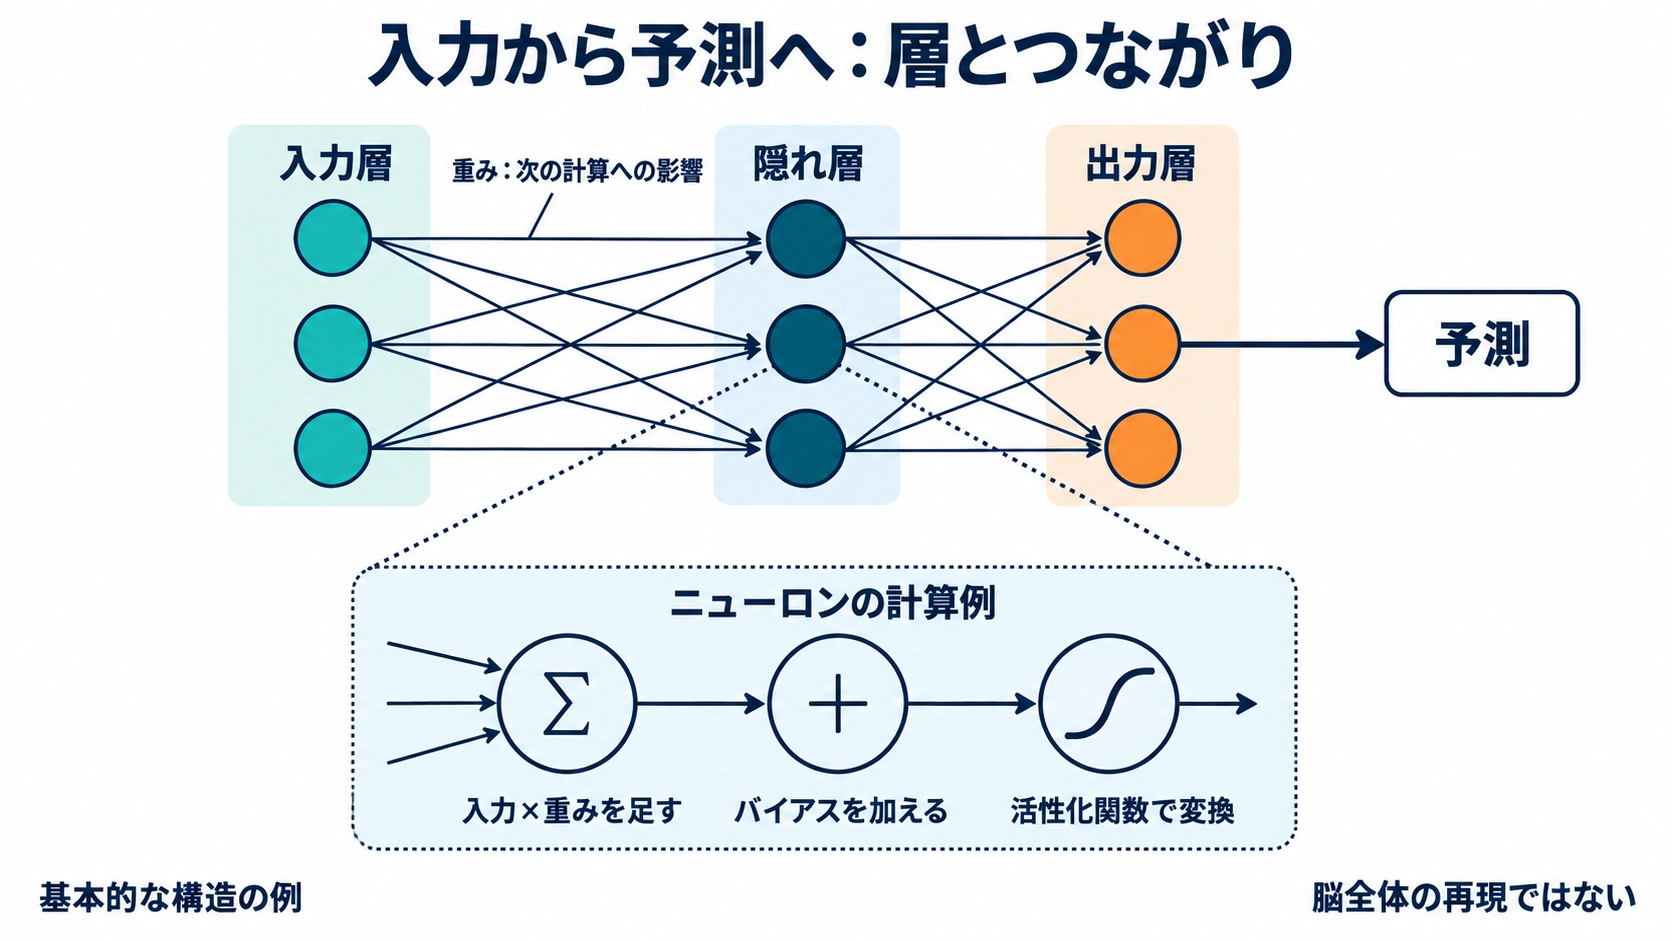 図を拡大する ↗
図の内容を文章で確認する
入力層が今回の値を受け取り、隠れ層で計算し、出力層の結果を予測へ使います。つながりの重みは、次の計算への影響を調整するパラメータです。ニューロンでは入力に重みを掛け、バイアスを加え、活性化関数などで値を変換します。図は入力から出力へ進む基本的な構造の例で、脳全体の再現でもすべてのネットワークの形でもありません。
図の読み方と同じ情報を、下の文章でも確認できます。
別の場面でたどる:所要時間を予測する
距離や荷物量などを入力し、途中の層で計算して、出力を配達の所要時間の予測に使うモデルを考えます。入力の「距離」を変えるのと、距離に関わる「重み」を学習で変えるのは別です。モデルを使う人が新しい距離を入力しただけで、重みまで更新したことにはなりません。
ここで持ち帰ること
層は入力から結果までの計算をつなぎ、重みはその影響を調整します。複数の隠れ層を使う深層学習も、機械学習の一つです。
条件を見て、自分で確かめる
言葉にしてみる (採点なし)
所要時間を予測するモデルで、入力の距離を10kmから20kmへ変えました。これは重みを学習で更新したことですか。入力・重み・出力の役割を使って説明してください。
解説と考え方を読む
距離は今回渡す入力です。重みはモデルの計算に使う値で、入力を替える操作と学習で更新する操作は別です。学習済みの重みなどを使って計算した結果を、所要時間の予測へ使います。
2予測が外れたとき、学習で何を調整するか
新しい入力を渡すだけで、モデルは学習し直す?
この節で使う言葉:損失関数・勾配・誤差逆伝播法・勾配降下法・学習済みモデル
この節の学習目標:予測・損失・勾配・重み更新の役割を区別し、入力を替える利用と学習を分けて説明できる。
旅行写真を分類する体験で、海辺の写真が「山」と予測されました。同じ写真を入れ直しても、結果は変わりません。入力するだけの操作と、モデルを学習し直す操作は何が違うのでしょうか。二人は学習の順序を確認します。別に取っておいた写真を入力し、その予測を人の正解と照合します。一枚の一致から、さらに別の写真の確認へ進みます。
予測を正解などと比べ、損失を計算し、重みをどう変えるかの手掛かりを求めて、更新する順に見ます。
入れ直すだけでは、学習にならない
この話で学ぶこと:同じ写真を入れ直す操作と、正解を使ってモデルを学習し直す操作は違う。
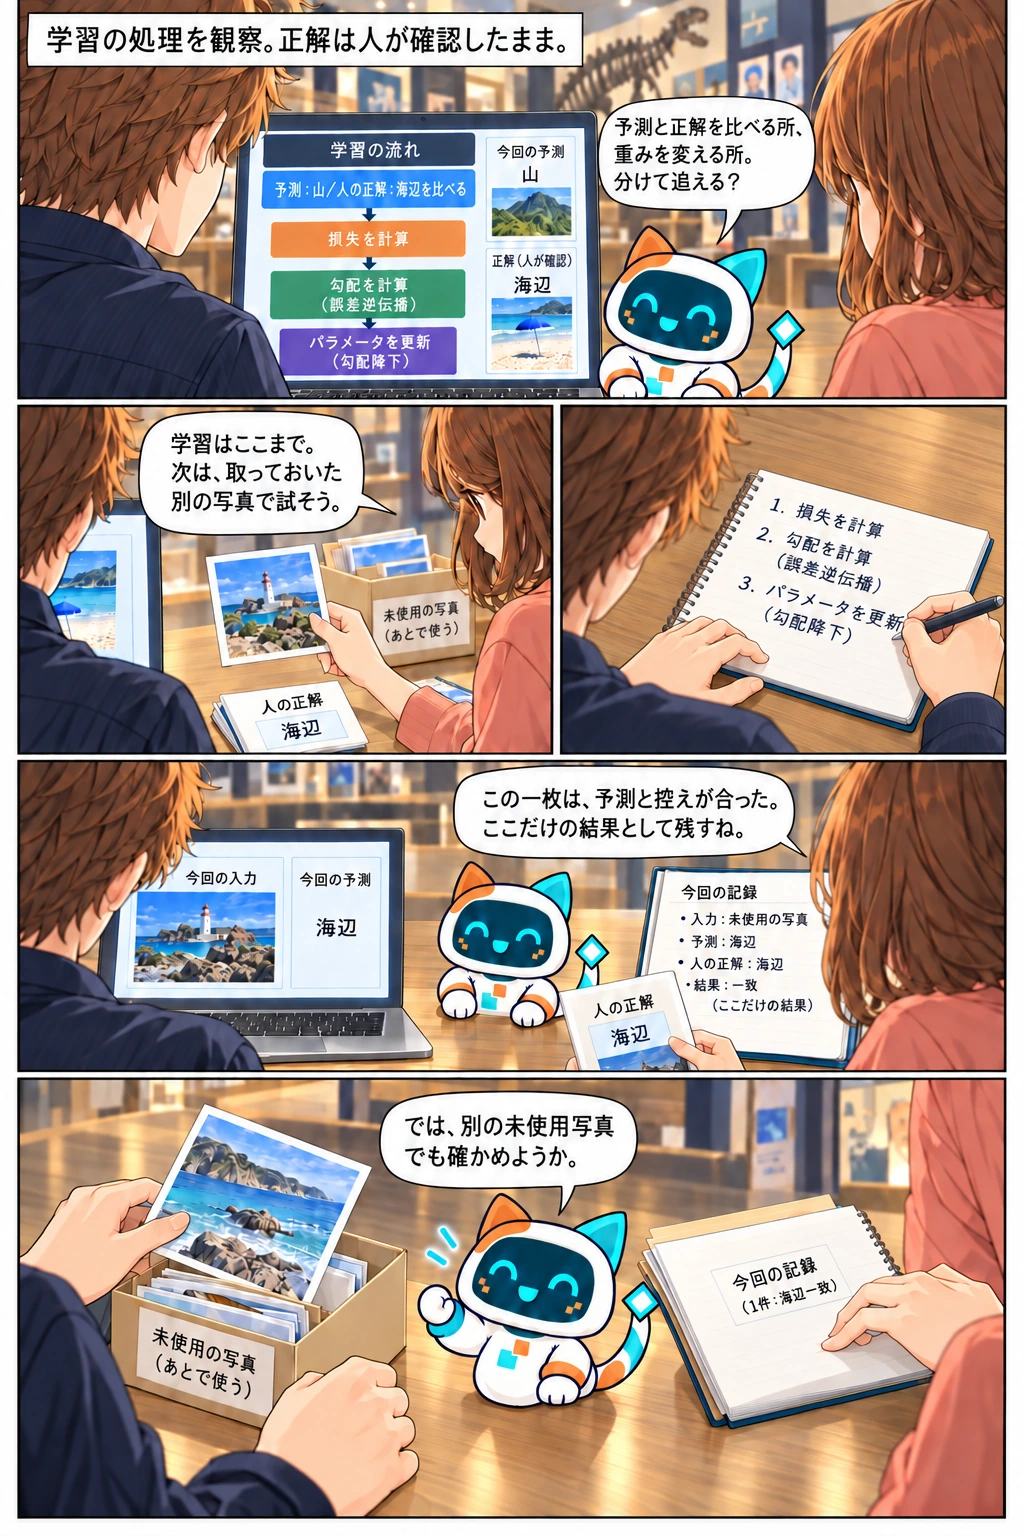
会話を文章で読む
場面:二人の後ろから一台のPCを見る。青い傘の海辺写真に山の予測、人の正解の海辺の控えはミオの右手元。ハルは左、ミオは右。
ハル「海辺の写真なのに、「山」と出た。」場面:ハルの左肩越しに、同じ青い傘の写真を入力する手元をミオと見る。
ハル「もう一度入れたら、覚えるかな。」場面:再入力後も山の予測。操作記録には入力、予測、結果があり、学習を実行していないと表示される。
ミオ「また「山」。今の操作では、学習の処理は動いてないね。」場面:机の手前の小さなビットが問いかけ、一台のPCの体験ガイドを見る。ハルの腕はそのPCのキーボードへ伸びる。
ビット「入力を入れ直す所と、重みを変える所は、どこ?」場面:ハルの右手が自分向きの平らなノートへ書き、左手は紙を押さえる。利用の予測と重みを更新する学習を区別して書く。
ハル「予測を出すだけと、学習する操作は別なんだね。」場面:ハルの肩越しにミオが青い傘の写真と海辺の人の正解をそろえる。白い灯台の写真はあとで使う箱に残る。
ミオ「人が確かめた海辺を使って、予測とのずれから見てみよう。」場面:二人の肩越しに、山の予測と海辺の人の正解を比べ、損失、勾配、パラメータ更新へ進む学習の画面を見る。ビットは机上で問いかける。
ビット「予測と正解を比べる所、重みを変える所。分けて追える?」場面:ハルの肩越しに、机へ自分向きに開いたノートへ損失、勾配、パラメータ更新の順を書き留める。
ハル「損失を出して、勾配を計算して、重みを更新するんだね。」場面:ミオはあとで使う箱から白い灯台の別写真を選び、海辺という人の正解の控えを机に分ける。
ミオ「学習はここまで。次は、取っておいた別の写真で試そう。」場面:二人の肩越しに一台のPCを見る。白い灯台の入力と海辺の予測を、ミオが人の正解の控えと見比べ、一件一致の記録を残す。ビットは同じ手前の天板に座る。
ミオ「この一枚は、予測と控えが合った。ここだけの結果として残すね。」場面:ハルが別の未使用写真を箱から選び、ミオは一件一致の控えを持つ。机上のビットが次の一枚の確認を促す。
ビット「では、別の未使用写真でも確かめようか。」
損失は、学習の目的に沿って予測を評価する値
損失(loss)は、学習の目的に照らして、予測のずれや誤りを評価する数値です。その値を求める決まりが損失関数です。教師あり学習なら、予測と正解を使って計算する例があります。分類と数値の予測では、目的に合う損失関数を選びます。
例えば気温を予測する課題で、正解20℃に対して24℃と予測した場合、差の4℃を使った評価を考えられます。二乗誤差なら4×4=16です。この例の値は、写真分類にそのまま使う数値ではありません。損失の値と、正解率の%は別のものです。
学習では損失を小さくすることを目指しますが、学習用データの損失が小さいだけで、新しい例でもよいとは言えません。損失を何のデータで計算したか、実際の目的に合う評価かを一緒に確認します。新しい例での評価は、次の節で詳しく見ます。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Google 機械学習用語集(別のタブで開く) ↗ / Google 誤差逆伝播(別のタブで開く) ↗
勾配を求め、重みなどを更新する
勾配は、重みなどを少し変えたときに損失がどちらへ、どれくらい変わるかを表す手掛かりです。ニューラルネットワークの誤差逆伝播法(バックプロパゲーション)は、出力側の損失から計算をさかのぼり、各パラメータに関する勾配を効率よく求める方法です。入力の写真を逆向きに流して元に戻す処理ではありません。
勾配降下法は、求めた勾配を使い、損失を小さくする方向へパラメータを調整する方法です。更新の大きさには学習率が関係します。勾配を計算する処理と、その値を使って重みを更新する処理は役割が違います。一度の更新で、すべての例の損失が減ったり、最良の値に到達したりする保証はありません。
学習中のモデルは、こうした更新を繰り返します。学習済みモデルを利用するときは、通常、学習済みのパラメータを使って新しい入力の予測を計算します。写真や指示文を替えて結果が変わっても、それだけで重みが更新されたとは言えません。実際に追加学習を行ったかを確かめます。
手掛かりから更新へ進む小さな例です。「予測=重み×入力」という単純なモデルで、入力1・正解2・重み0とします。予測は0、二乗誤差の損失は(0-2)²=4です。この点の勾配を計算すると-4になります。負なのは、この付近では重みを少し増やすと損失が小さくなる向きだからです。たとえば重み0.1なら損失は3.61、重み-0.1なら4.41です。ここでは勾配の計算結果を受け取り、学習率を0.1として「元の重み-学習率×勾配」で更新すると、0-0.1×(-4)=0.4です。負の値を引くので、重みは0から0.4へ増えます。
更新後の予測は0.4、損失は(0.4-2)²=2.56となり、この例では4より小さくなりました。勾配を求めた時点と、重みを0.4へ変えた時点は別です。学習率0.05なら最初の更新先は0.2になり、更新幅も変わります。これは一つの重みだけの説明用モデルで、写真分類の実際の計算や、毎回の改善を保証する例ではありません。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / PyTorch 勾配計算とパラメータ更新(別のタブで開く) ↗ / Google 誤差逆伝播(別のタブで開く) ↗ / Google モデルの用語(別のタブで開く) ↗
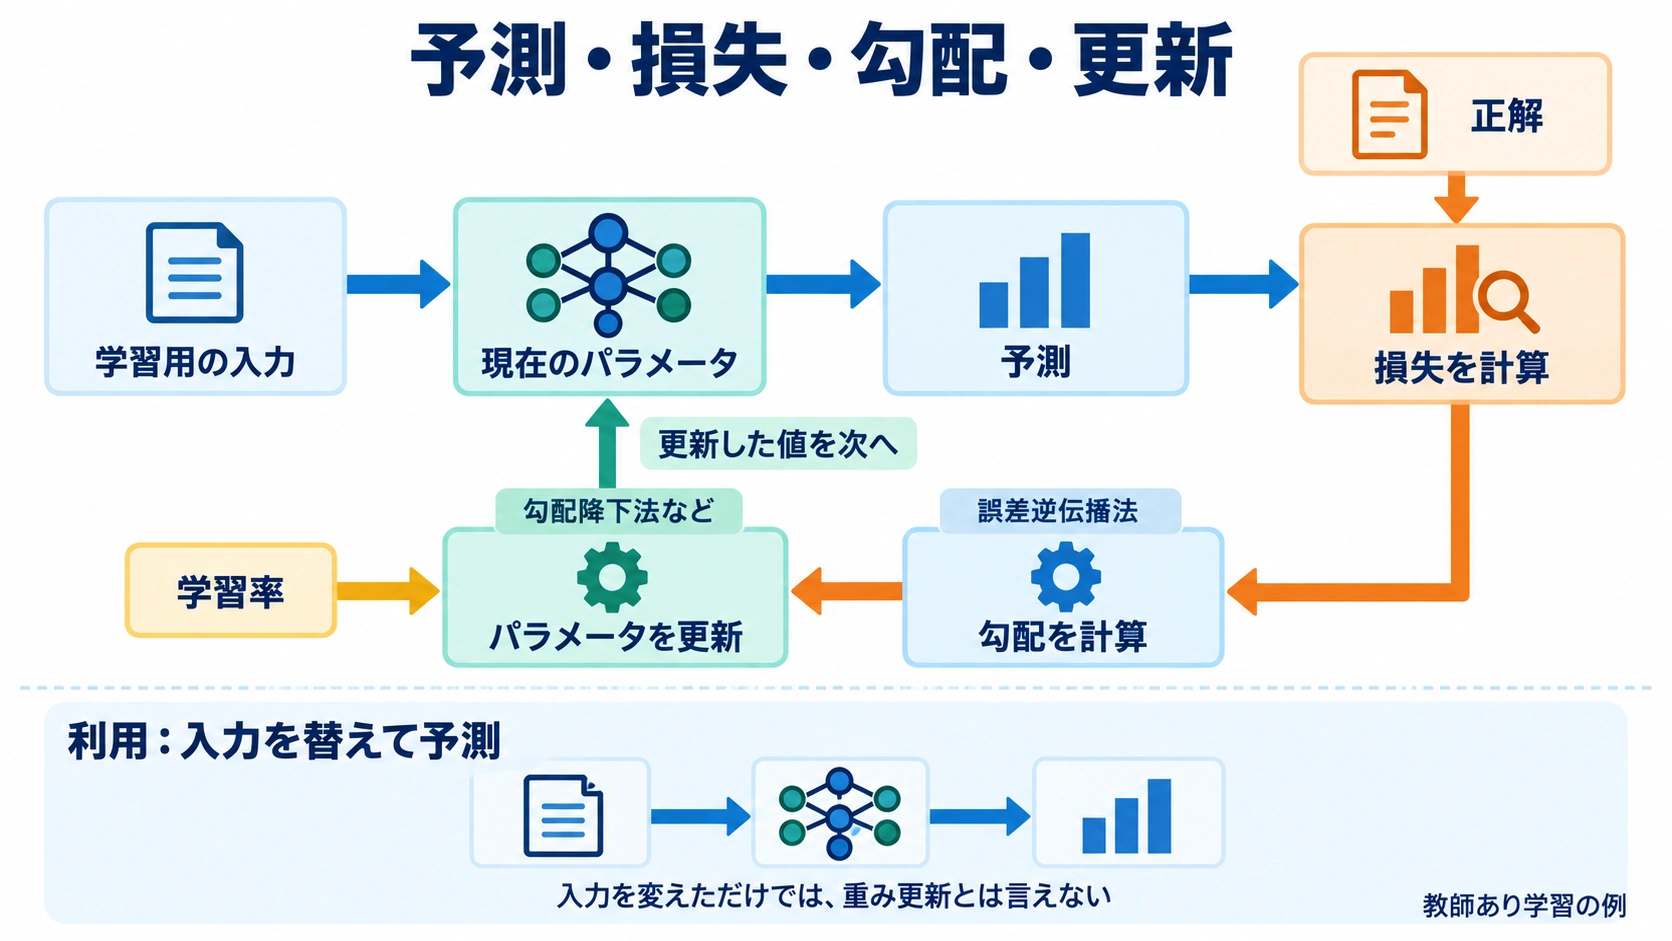 図を拡大する ↗
図の内容を文章で確認する
- 学習用の入力と現在のパラメータから、予測を計算します。
- 予測と正解などを使い、損失を計算します。
- 誤差逆伝播法で、各パラメータに関する勾配を求めます。
- 勾配降下法などで、勾配と学習率を使いパラメータを更新します。
勾配の計算と更新は役割が違います。更新した値を次の予測へ使います。利用時に入力を替える操作だけでは、パラメータを更新したとは言えません。
図の読み方と同じ情報を、下の文章でも確認できます。
別の場面で比べる:依頼文の書き直し
文章などの内容をつくるAIを生成AIと呼びます。生成AIへの依頼を「3行で要約して」と書き直すと、短い答えになりました。これは新しい入力による利用の例です。「短い答えを出した」という結果から、その場で重みを追加学習したとは判断できません。学習の説明では、どの例と目的を使い、どのパラメータを更新したかを確認します。
ここで持ち帰ること
損失は学習の目的に沿う評価、誤差逆伝播は勾配の計算、勾配降下は更新の方法。利用時に入力を替えることと、モデルを学習し直すことを区別します。
条件を見て、自分で確かめる
言葉にしてみる (採点なし)
「前のモデルへ同じ写真をもう一度渡した」「写真と正解で勾配を求め、重みを更新した」。2つの操作を、利用と学習に分けて説明してください。
解説と考え方を読む
同じ写真をもう一度渡すのは、学習済みの値を使う利用として考えます。正解などと比較して損失と勾配を求め、重みを更新するのは学習です。入力を渡したことだけで学習したとは言えません。
3初めての例でも使えるか、どう確かめるか
練習では当たったモデルを、新しい写真にも使ってよい?
この節で使う言葉:汎化・過学習・検証用データ・正則化・ドロップアウト・早期停止
この節の学習目標:学習・検証・テストの用途を分け、過学習の兆候と対策を条件付きで説明できる。
これから撮る写真にも、分類を役立てたい二人。練習ではよく当たったのに、別の日に撮った海辺の写真は「山」と予測されました。晴れた写真と曇った写真の違いが気になりますが、原因はまだ決められません。設定を選ぶための検証用と、最後の評価に残すテスト用を分け、条件と成績を記録する準備を始めます。
学習に使った例と使っていない例の成績を比べ、データの条件も確認して、調整と最終評価を分けます。
練習で当たっても、新しい写真では?
この話で学ぶこと:条件と成績を記録して検証用で設定を選び、テスト用は調整に使わず残す。
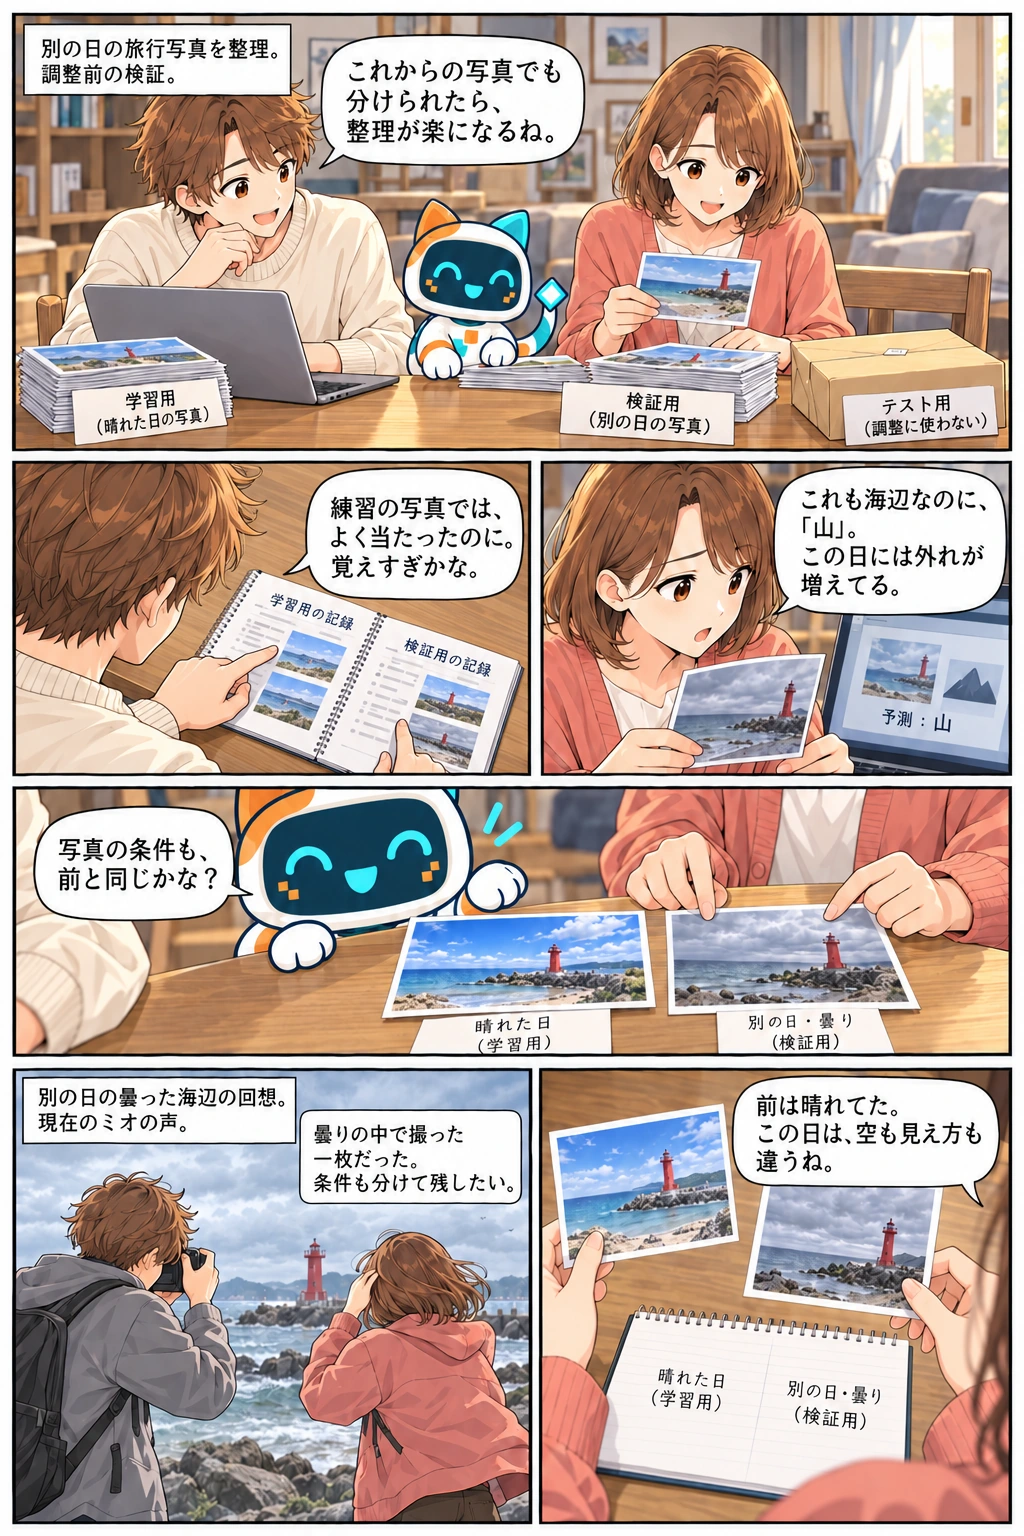
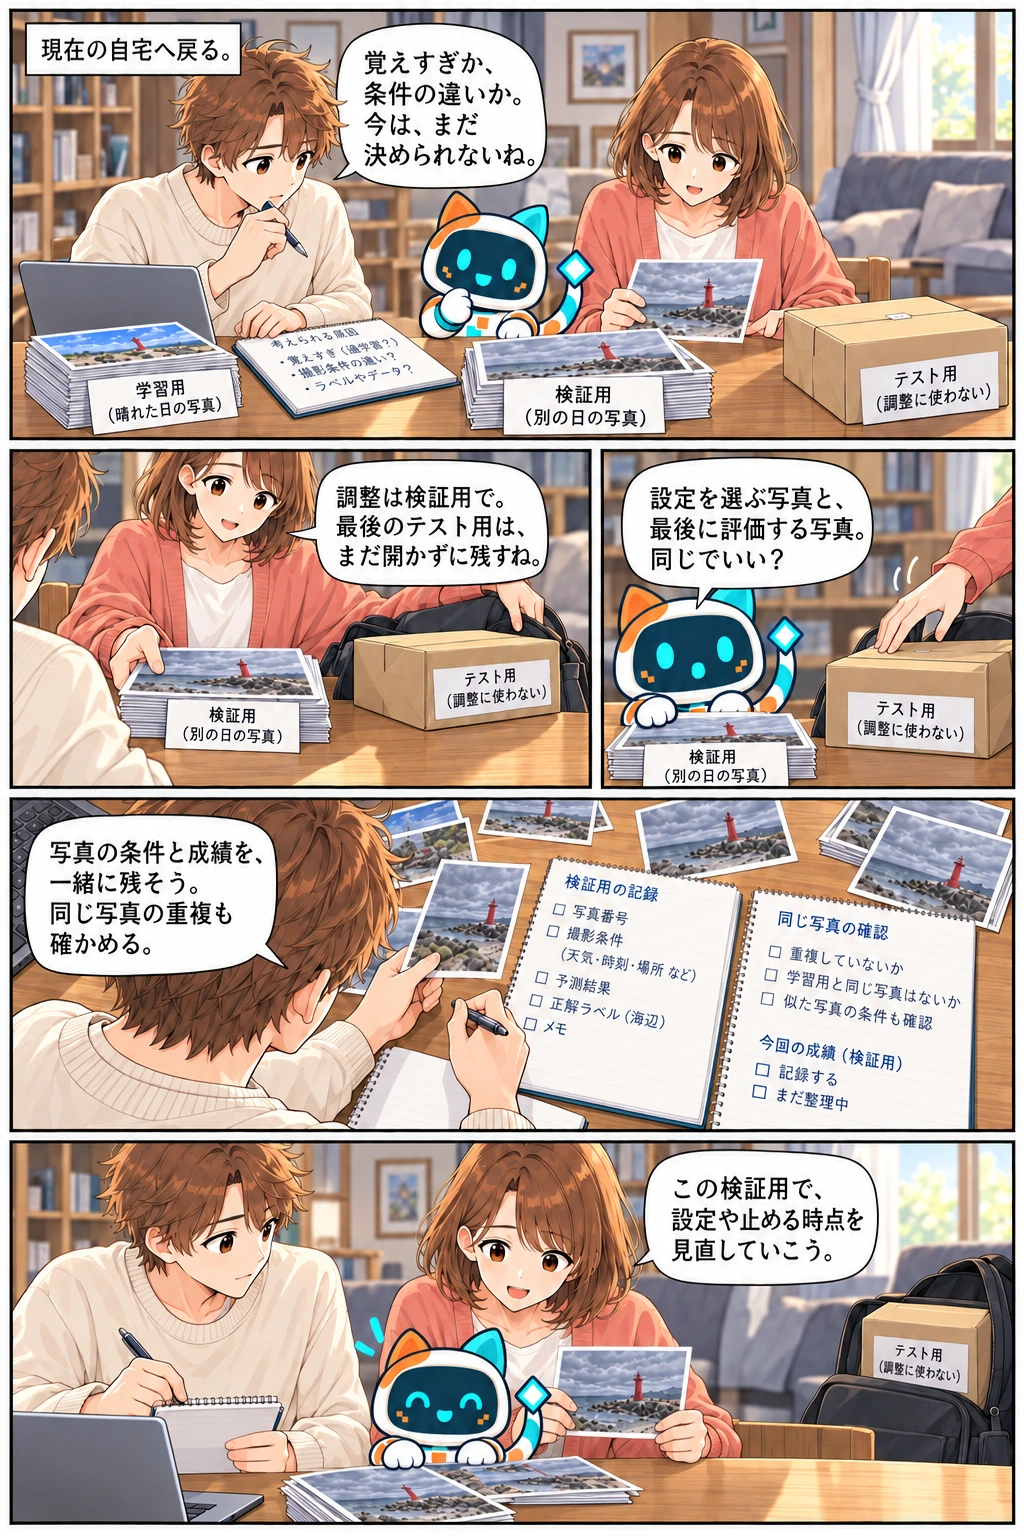
会話を文章で読む
場面:自宅の机でハル左/ミオ右、ビットは中央手前の天板。左に学習用、中央に検証用、右に閉じたテスト箱。ミオの手元には晴れた赤い灯台の写真が見える。
ハル「これからの写真でも分けられたら、整理が楽になるね。」場面:ミオが曇りの赤い灯台の海辺写真を手元で見ながら、同じ写真に山と予測したPCを見る。
ミオ「これも海辺なのに、「山」。この日には外れが増えてる。」場面:ハルの肩越しに机へ開いた学習用と検証用の記録を読む。二つの手はページを指し、ノートを支えている。
ハル「練習の写真では、よく当たったのに。覚えすぎかな。」場面:机上のビットが写真の条件を問い、ミオは晴れた日と別の曇りの日の赤い灯台の二枚を机へ並べて指す。
ビット「写真の条件も、前と同じかな?」場面:ミオの肩越しに晴れと曇りの写真を比べ、下の机上ノートには学習用と検証用を区別して書いてある。
ミオ「前は晴れてた。この日は、空も見え方も違うね。」場面:別の日の曇った海辺への回想。ハルが左で撮影し、ミオが右で海辺を見る。現在のミオの声は尾のない白枠に記され、回想の口から出ていない。
ミオ「曇りの中で撮った一枚だった。条件も分けて残したい。」場面:現在の自宅へ戻る。ハル左の考えられる原因のノートは机へ寝かせてある。ミオ右は曇りの灯台写真、ビットは中央手前の机、テスト箱は右で閉じる。
ハル「覚えすぎか、条件の違いか。今は、まだ決められないね。」場面:ビットが検証用とテスト用を問い、ミオの手は閉じたテスト箱へ伸びかけている。箱は開いていない。
ビット「設定を選ぶ写真と、最後に評価する写真。同じでいい?」場面:ミオが閉じたテスト箱を右の鞄へ分け、中央の検証用の束をハルへ寄せる。
ミオ「調整は検証用で。最後のテスト用は、まだ開かずに残すね。」場面:ハルの肩越しに机上の写真と検証用の記録、同じ写真の確認のノートを見る。写真番号、条件、成績等はまだ確認項目として残る。
ハル「写真の条件と成績を、一緒に残そう。同じ写真の重複も確かめる。」場面:ハル左は記録の準備、ミオ右は次の曇りの灯台写真を手元に置く。ビットは二人の間の同じ手前天板へ座り、テスト箱は右の鞄で閉じたまま。
ミオ「この検証用で、設定や止める時点を見直していこう。」
学習した例以外でも役立つことを確かめる
汎化は、学習に使った例だけでなく、学習に使っていない例にも対応できることです。写真分類なら、新しい写真でも目的に合う予測ができるかを確かめます。学習用の写真で当たることと、今後撮る写真で役立つことは同じではありません。
過学習(オーバーフィッティング)は、学習用データの細かな特徴や偶然のばらつきにまで適合し、新しい例への対応が悪くなることです。ここでは、学習用と検証用に同じ計算方法を使い、予測の外れ具合を表す値(損失)を比べます。学習用の損失は下がるのに、条件をそろえた検証用の損失が上がり始めるなら、過学習を疑う兆候です。ただし、新しい写真で一度外れただけでは、過学習と断定できません。撮影条件や対象が変わった、ラベルに誤りがある、といった原因も考えます。
学習用データは重みなどの調整に使い、検証用データは学習の設定や止める時点を選ぶために使います。選び終えたモデルの評価には、調整に使っていないテスト用データを残します。テストの結果を何度も見て設定を選ぶと、そのテストにも合わせてしまい、未知の例での成績を公平に測りにくくなります。
分けた名前だけで十分とは言えません。同じ写真の複製が複数の組へ入っていないか、実際に使う時期や対象に近い例かも確認します。学習で使わなかったという条件と、今後の用途に合うという条件を、両方見ます。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Google 学習・検証・テストの分離(別のタブで開く) ↗ / Google 正則化と早期停止(別のタブで開く) ↗
覚えすぎを抑える方法にも、条件がある
正則化は、学習用データに過度に合わせないよう、モデルの複雑さなどへ制約を加える方法です。例えば重みが大きくなることにペナルティを加える方法があります。強くすれば必ずよいわけではなく、必要な関係まで捉えにくくなることもあります。検証用データで調整の程度を確認します。
ドロップアウトは、学習中に一部のニューロンの出力をランダムに0にするなどして、特定のつながりへ頼りすぎることを抑える方法です。ニューロンを永久に削除することとは違います。通常の利用時に、学習時と同じランダムな無効化を続けるものではありません。学習時と利用時の動作を分けます。
早期停止(アーリーストッピング)は、検証用の損失などを見て、改善が続かなくなった時点で学習を止める方法です。学習用の成績を限界までよくすることが目的ではありません。正則化、ドロップアウト、早期停止は、新しい例での性能を必ず保証する方法ではありません。データ品質や実際の用途を確認し、目的に合う評価と組み合わせます。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Google 正則化と早期停止(別のタブで開く) ↗ / Keras 学習時のドロップアウト(別のタブで開く) ↗
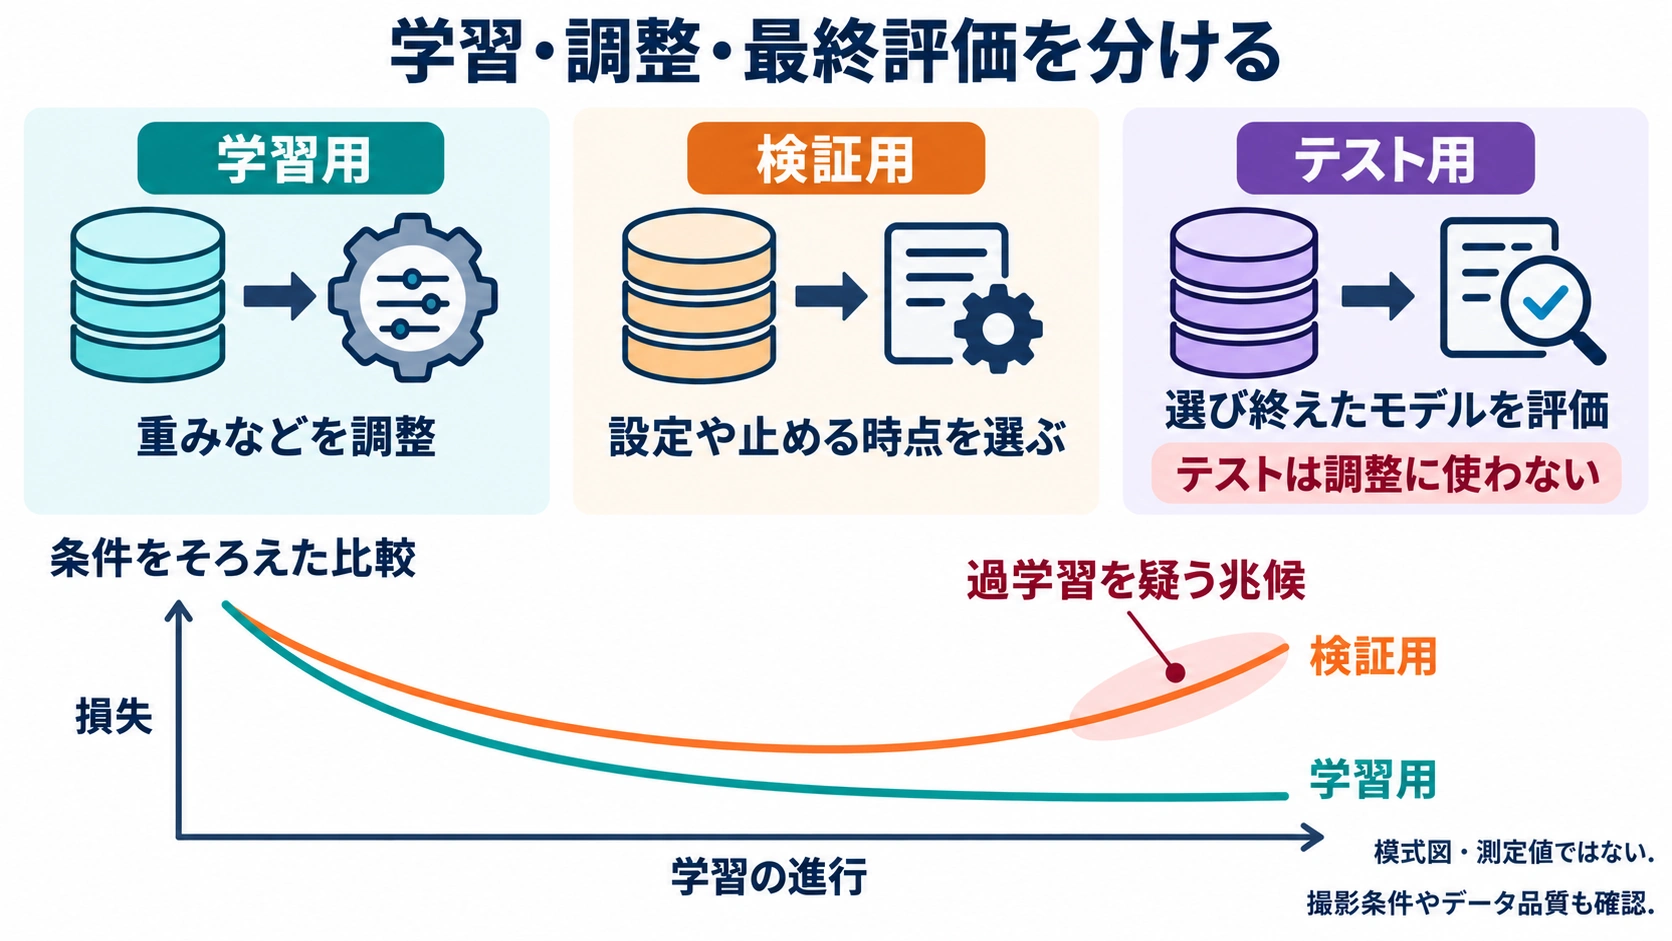 図を拡大する ↗
図の内容を文章で確認する
- 学習用
- 重みなどを調整するためのデータ。
- 検証用
- 学習の設定や止める時点を選ぶためのデータ。
- テスト用
- 調整に使わず残す、選び終えたモデルの評価用データ。
学習用の損失は下がるのに検証用の損失が上がるなら、過学習を疑う兆候です。グラフは説明のための模式図で、測定値ではありません。撮影条件やデータ品質も確認し、一度の誤りだけでは原因を断定しません。
図の読み方と同じ情報を、下の文章でも確認できます。
別の場面で確かめる:来月の需要予測
昨年の販売記録で学んだモデルを、来月の需要予測に使いたいとします。同じ記録の複製を学習用とテスト用へ分けても、新しい時期への対応を十分に確かめたことにはなりません。時期の違い、販売条件の変更、記録の誤りを確認し、今後の用途に近い未使用の記録で評価する方法を考えます。
ここで持ち帰ること
学習用で当たることと、新しい例で役立つことは別です。検証は設定の選定、テストは調整に使わない評価。対策の名前だけで汎化を保証しません。
条件を見て、自分で確かめる
言葉にしてみる (採点なし)
昼間の写真で学んだモデルが、夜の写真を1枚だけ誤分類しました。「過学習だから正則化すれば解決する」と言ってよいですか。何を比べ、どんなデータで確認するか説明してください。
解説と考え方を読む
1枚の誤りだけで原因を決めません。学習用・検証用の成績、昼と夜の条件の違い、ラベルの品質を確認します。設定は検証用で見直し、今後夜の写真を扱うなら、その用途に近く調整に使っていない例で評価します。正則化だけで解決する保証はありません。
4すでに学んだモデルを、別の用途へ生かせるか
既存モデルを使うとき、どの部分をそのまま使い、どこを学習する?
この節で使う言葉:転移学習・ファインチューニング・特徴・パラメータ
この節の学習目標:既存モデルの特徴の再利用と追加調整を説明し、入力内の例示とパラメータ更新を区別できる。
会場の片付けをしながら、備品を写真で探せる索引を作りたい二人。ところが、風景を「海辺/山」に分けるモデルでは、ケーブルと電源アダプターを分ける答えは得られません。入力に見本を添えることと、新しい分類のために学ぶことを比べます。今の片付けは備品表と実物で進め、索引用の学習写真とあとで試す写真は別に用意します。
すでに学んだもの、新しい目的、更新する部分を示し、新しい例で役立つかを確認します。 漫画の「入力に見本」は、入力例に対応するモデルでの方法です。どの画像分類モデルでも同じ操作ができるという意味ではありません。本文では、学習済みの特徴の再利用と、言語モデルへの例示を分けて比べます。
片付ける道具には、別の答えが要る
この話で学ぶこと:学習済みの特徴を固定して使い、新しい備品の分類部分は正解付き写真で学ぶ準備をする。
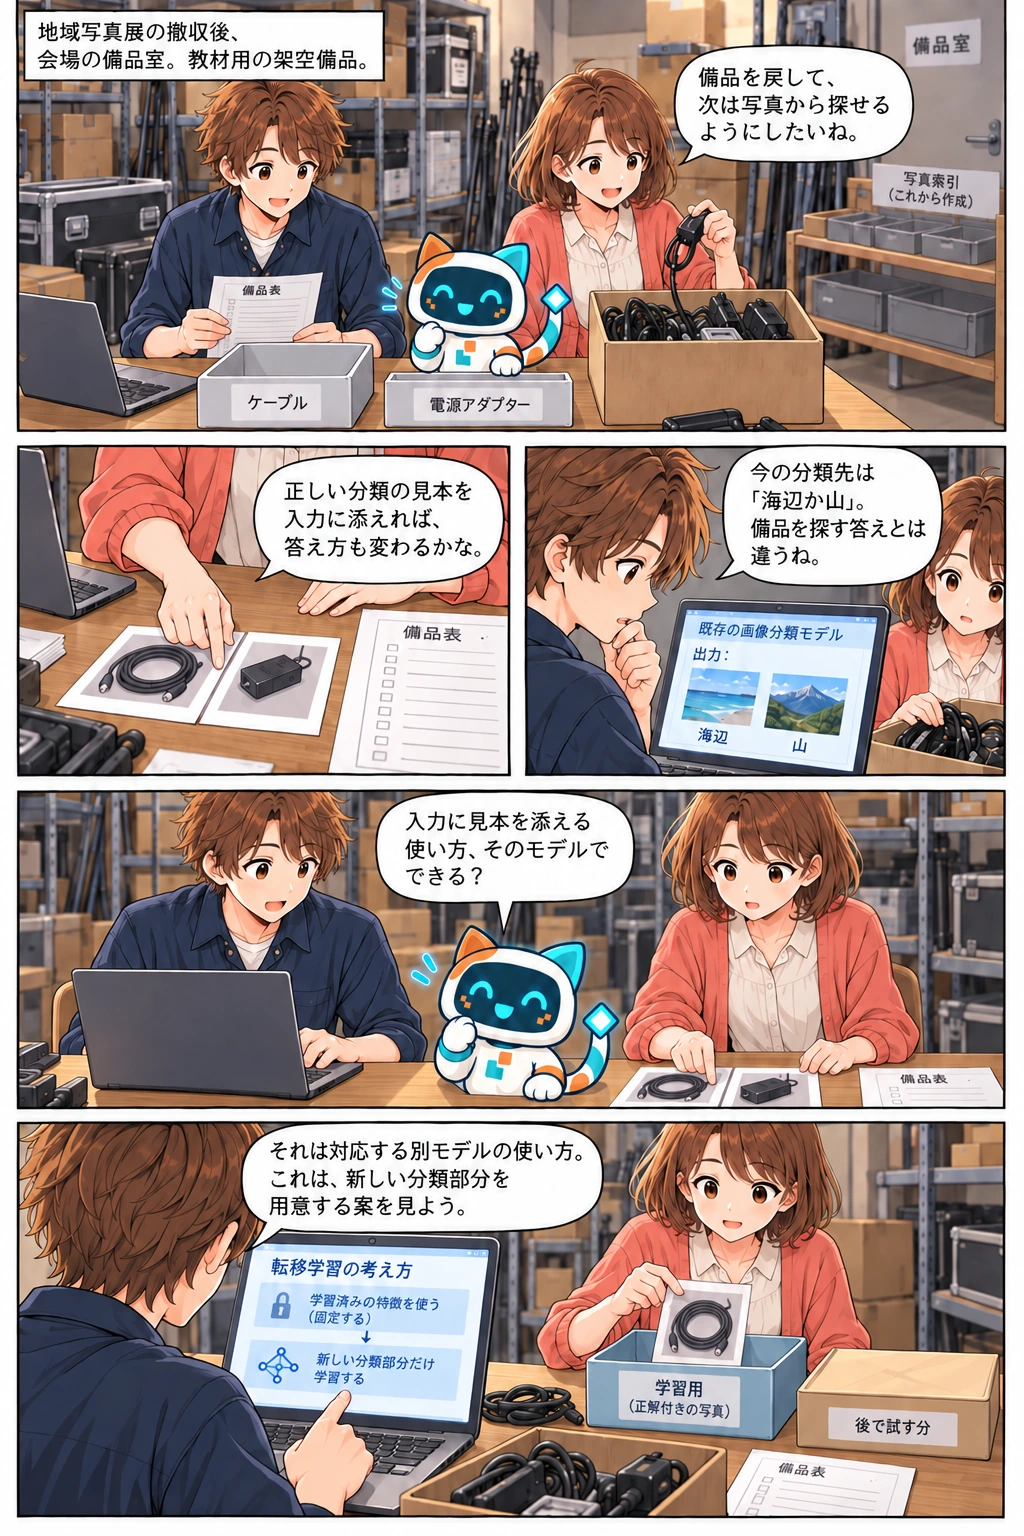
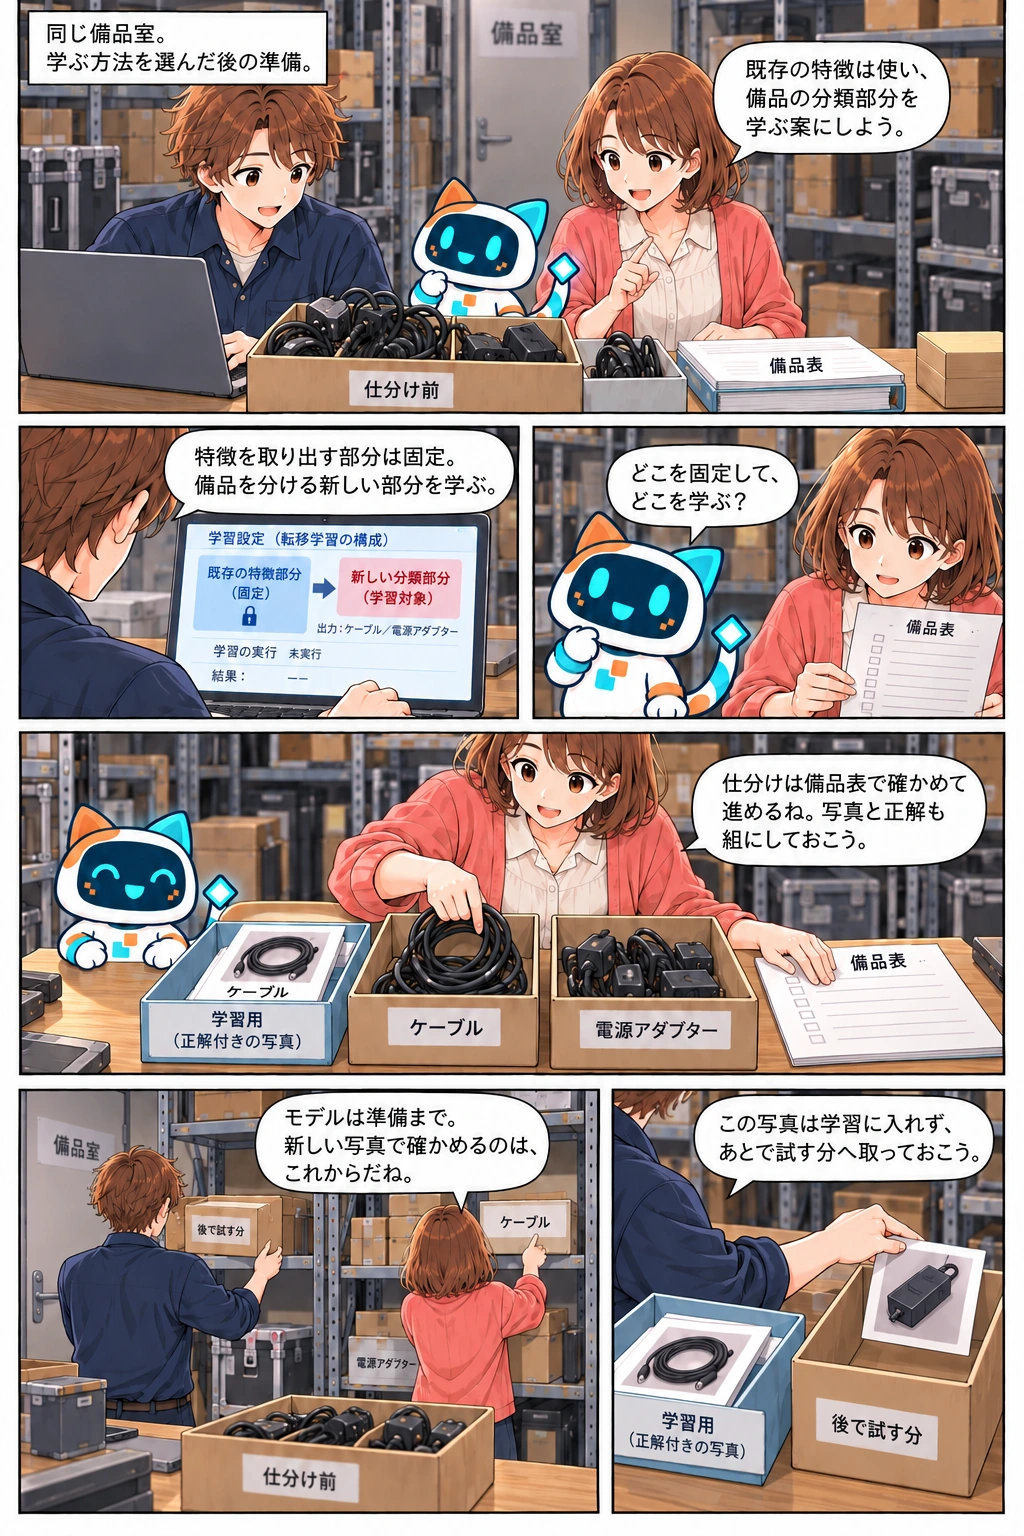
会話を文章で読む
場面:地域写真展の撤収後、備品室で二人が道具を整理する。ハル左は備品表、ミオ右は電源アダプターを持つ。机にはケーブルとアダプターのトレー、混じった備品の箱があり、ビットは二人の間の机の前縁。
ミオ「備品を戻して、次は写真から探せるようにしたいね。」場面:ハルの肩越しに既存の画像分類モデルを見る。出力は海辺と山で、ミオの手元にある備品の種類とは違う。
ハル「今の分類先は「海辺か山」。備品を探す答えとは違うね。」場面:ミオが机上のケーブル写真を指す。隣にはアダプター写真と備品表があり、見本を入力に添える案を話す。
ミオ「正しい分類の見本を入力に添えれば、答え方も変わるかな。」場面:ビットが、そのモデルで見本を添える使い方ができるか問いかける。ハルはPCを前にし、ミオはケーブルとアダプターの写真を見る。
ビット「入力に見本を添える使い方、そのモデルでできる?」場面:ハルの肩越しに、学習済みの特徴を固定し、新しい分類部分を学ぶ案を見る。ミオは正解付きケーブル写真を学習用へ分ける。右の後で試す箱は閉じたまま。
ハル「それは対応する別モデルの使い方。これは、新しい分類部分を用意する案を見よう。」場面:同じ備品室で準備を続ける。ハル左のPCは本人向きで、ミオ右の手元には備品表。ビットは二人の間の机に座り、仕分け前の備品の箱が残る。
ミオ「既存の特徴は使い、備品の分類部分を学ぶ案にしよう。」場面:机上のビットが、どこを固定してどこを学ぶか問いかける。ミオは備品表を手元に持つ。
ビット「どこを固定して、どこを学ぶ?」場面:ハルの肩越しに、既存の特徴部分を固定し、新しい分類部分を学習対象にする設定を見る。出力はケーブルと電源アダプター。学習は未実行で、結果はまだない。
ハル「特徴を取り出す部分は固定。備品を分ける新しい部分を学ぶ。」場面:ミオが備品表を手元で確認しながらケーブルを箱へ戻す。学習用のトレーにはケーブル写真と人の正解が組になっている。
ミオ「仕分けは備品表で確かめて進めるね。写真と正解も組にしておこう。」場面:ハルが電源アダプターの写真を後で試す分の箱へ分ける。隣の学習用トレーには別のケーブル写真がある。
ハル「この写真は学習に入れず、あとで試す分へ取っておこう。」場面:ハルが後で試す分の箱を、ミオがケーブルの箱を棚へ戻す。手前には仕分け前の備品が残り、モデルは準備の段階にとどまる。
ミオ「モデルは準備まで。新しい写真で確かめるのは、これからだね。」
学習済みの特徴などを、新しい課題へ使う
転移学習は、ある課題などで学習したモデルの知識や特徴を、別の課題へ生かす方法です。画像で学習したモデルが捉えた形などの特徴を、新しい写真分類へ使う例があります。最初からすべてを学ぶ以外の方法として考えられます。
一つの例として、たとえば、形などの特徴を取り出す部分は、学習済みの重みを変えずに使います。その先に新しい分類用の部分を付け、その部分の重みを学習で調整します。固定して再利用する部分と、新しく学習する部分を区別します。「特徴を取り出す部分を固定したから、どこも学習していない」とは限りません。これは転移学習の一例で、唯一の構成ではありません。
使う前に、既存モデルの対象と新しい写真の特徴が合うか、入力形式や利用条件が適切かを確認します。既存モデルが有名でも、新しい用途でよいとは決まりません。新しい課題に合う未使用の例で、予測の性能を確かめます。
少ないデータや時間で使うときの利点と限界
たとえば、商品の傷を写真から見つけたいものの、正解を付けた写真が少なく、使える計算機や学習時間も限られるとします。最初から大きなモデル全体を学ぶ方法と、画像の特徴を学習済みのモデルから取り出し、新しい分類用の部分を学ぶ方法を比べます。
後者では、既存の形や模様などの特徴を利用でき、学習する部分を絞って、計算や時間の負担を減らせる場合があります。特徴を一度計算して保存し、その特徴から小さな分類用の部分を学ぶ構成もあります。ただし、写真の大きさや数値の範囲をモデルに合わせる前処理や、新しい分類の正解付きデータ、性能を確かめるデータの準備は必要です。
| 条件 | 考えること |
|---|---|
| 元の対象に近い写真 | 形や模様の特徴が新しい課題にも役立つか、未使用の写真で確かめる。 |
| 元の対象とは違う写真 | 普通のカラー写真で得た特徴が、特殊な撮影方法の画像などにも合うとは限らない。 |
| 学習する部分を増やす | 追加調整のためのデータ・計算・時間が必要になる。結果が改善したか再評価する。 |
転移学習を使うことと、少ないデータで十分な性能を得ることは別です。対象が合わなければ、固定する部分を変える、学習済みの重みを追加で調整するファインチューニングを試す、別のモデルやデータを検討する、といった見直しが必要です。追加調整は次の項で詳しく説明します。以前の用途での高い性能を、新しい用途での性能として報告しません。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Keras 転移学習と追加調整(別のタブで開く) ↗ / TensorFlow 転移学習とファインチューニング(別のタブで開く) ↗
追加で重みを調整することと、入力の例示を分ける
ファインチューニングは、学習済みモデルの一部または全体のパラメータを、新しいデータなどで追加学習して調整することです。特徴の再利用に続けて、既存部分の一部も新しい課題へ合わせる例があります。既存の重みをすべて捨てることや、必ず全パラメータを更新することを意味しません。
一方、生成AIへ「この例のように分類して」と入力に見本を添えることは、入力内の例示としてモデルを利用する方法です。入力に例を添えたことだけで、モデルの重みを追加学習したとは言えません。使っているサービスが別途学習するかどうかは、その処理や取扱いの条件を確認します。
ここでは一般的な区別を押さえます。追加学習でも、データの偏りや学習しすぎで新しい例への対応が悪くなる場合があります。更新した部分、学習の目的、未使用の例での結果を確かめます。「追加で学ばせた」という操作の名前だけで、品質が上がったと結論付けません。
根拠:GUGA 2027年2月適用シラバス(別のタブで開く) ↗ / Keras 転移学習と追加調整(別のタブで開く) ↗ / Brownほか 入力内の例示と重み更新の区別(別のタブで開く) ↗
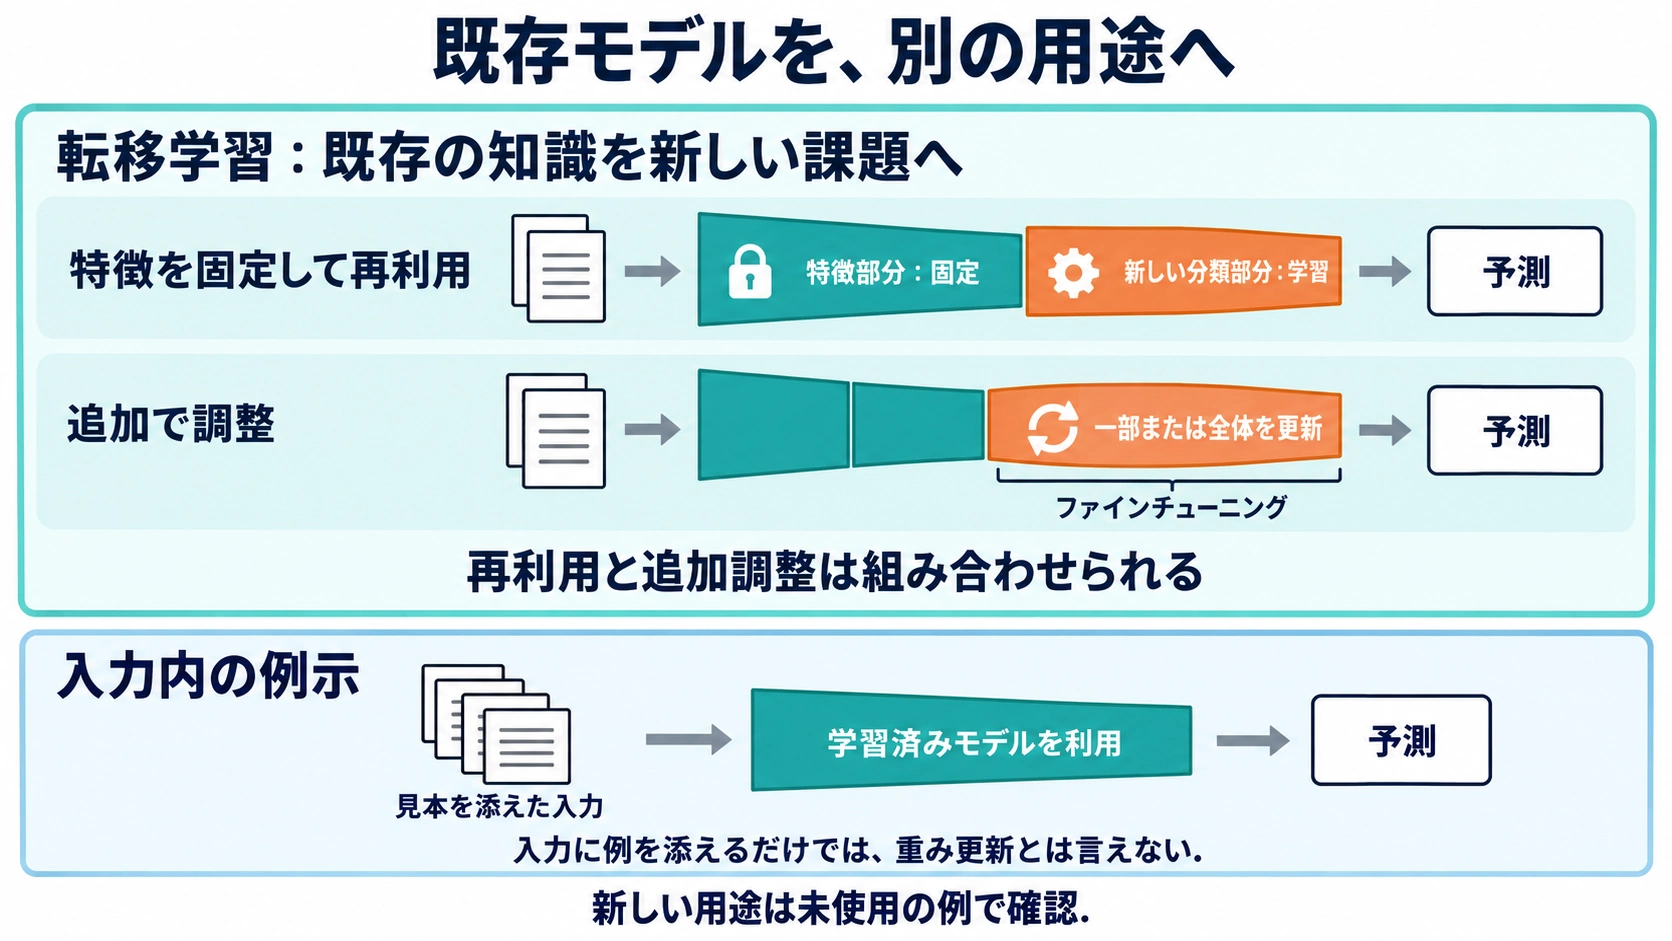 図を拡大する ↗
図の内容を文章で確認する
- 特徴を再利用する例
- 学習済みの特徴を取り出す部分は固定し、新しい分類部分を学習します。転移学習の一例です。
- 追加で調整する例
- 学習済みの一部または全体のパラメータを追加学習します。ファインチューニングの例です。
- 入力内の例示
- 入力に見本を添えて、学習済みのモデルを利用します。それだけで重み更新とは言えません。
追加で調整する方法も、既存の知識を新しい課題へ生かせます。これらを互いに排他的な分類とはせず、固定した部分・更新した部分・利用の処理を区別します。新しい用途での性能は、未使用の例で別途確かめます。
図の読み方と同じ情報を、下の文章でも確認できます。
別の場面で分ける:文章の分類
言葉の並びから、どんな言葉が現れやすいかを予測する仕組みが言語モデルです。学習済みの言語モデルへ分類例を入力して使う方法と、分類用データで一部のパラメータを追加学習する方法では、行う処理が違います。どちらでも、新しい文章に対して目的に合う分類ができるかは別途確認します。入力に例を付けたかだけでなく、実際にモデルのパラメータを更新したかを見ます。
ここで持ち帰ること
転移学習は学んだ特徴などを別の課題へ生かすこと。ファインチューニングは学習済みの値の追加調整。入力内の例示は、それだけで重み更新とは言えません。
条件を見て、自分で確かめる
言葉にしてみる (採点なし)
「分類例を入力に添えた」「分類用データで学習済みの一部の重みを更新した」。どちらが追加学習か、何の記録を見れば区別できるか、変更後に何を確認するか説明してください。
解説と考え方を読む
入力内の例示と、学習処理によるパラメータ更新を分けます。後者が追加学習の例です。入力内容だけでなく、学習を実行した記録、対象データ、更新部分を確認し、調整に使っていない例で新しい用途の性能を評価します。