教師ありファインチューニング
望ましい出力の組を用いて更新します。資料の例は、入力と望ましい出力の組です。
事前学習で広く学ぶこと、用途へ追加調整すること、人の評価を学習へ生かすことを区別します。データの品質や利用条件、規模の拡大で分かる範囲も確かめます。
2027年2月試験から適用のシラバスを対象にしています。学習と利用時の入力、調整の目的、データと評価の条件を読み分けます。確認問題は公式の過去問・模擬試験ではありません。
前に確認する:学習した例と別の例で確かめる / 文章と画像の生成技術を役割で読む
回答はこのページを開いている間だけ保持します。別ページへの移動や再読み込みで消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
この話で学ぶこと:入力の例を変えることと、モデルの数値を学習で更新することを同じにしない。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:引き。二人が横並びで一つの画面を見る。文章が長くて紙へ収まらない上のミオの希望に続き、下のハルが短い例を添えると提案する。
ミオ「しおりの案内、もう少し短くしたいな。」ハル「短い例も添えてみよう。」場面:肩越し。ハルが例を一つ入力した後の画面。短い出力と、架空デモの表示『追加学習なし/パラメータ固定』を一緒に見せる
ハル「出し方が変わった。もう学習し直したの?」場面:PC画面をビットにも向ける動作の寄り。ビットは表示を見た後に話す。
ビット「ここでは、今の入力の例を使っているよ。数値の更新はしていないんだ。」ミオ「出力の変化だけでは決められないね。」場面:紙と画面を並べた手元から二人の顔へ。ハル左/ミオ右へ戻る。ミオは紙の枠を指し、ハルは次に確かめる表示を見る
ハル「何を入力したかと、何を更新したかを分けて見よう。」例を見ながら人が案内文を直す場面から、入力を変えることとモデルの数値を更新することを分けます。漫画の人の記憶を、モデルの学習そのものへ対応させる比喩にはしません。
大規模言語モデル(LLM)は、大量の言語データなどから学んだモデルです。文章を処理するときはトークンという単位へ分け、各単位を番号や数値の表現で扱います。トークンは一文字や一単語と必ず一致するものではありません。
例えば『参加できます』を『参加』『でき』『ます』という三つの単位に分けると仮定します。これは単位の違いを見るための架空の分割例です。別の方式なら違う分け方もあり、特定のサービスで必ず3トークンになるとはいえません。文章の文字数や単語数だけからトークン数を決めないようにします。
根拠:Google ML Crash Course: What is a large language model?(別タブで開く) ↗
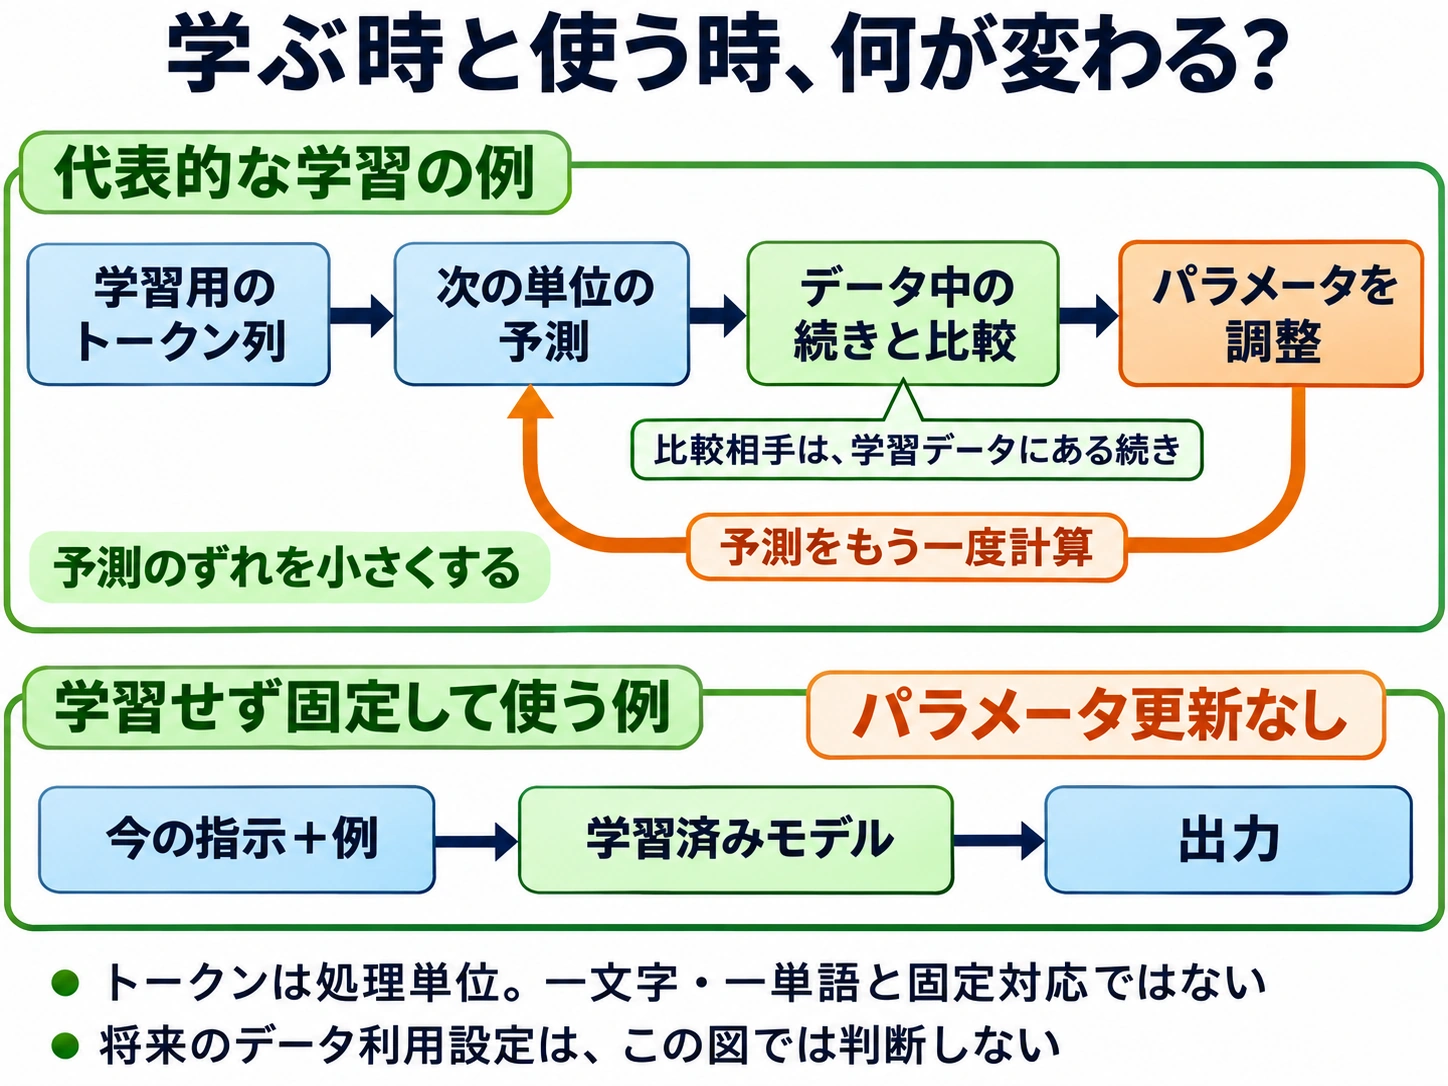
事前学習は、用途ごとの調整に先立って、広いデータから基礎となる表現や予測の傾向を学ぶ段階です。基本的な自己回帰の言語モデルでは、前にあるトークンから次のトークンを予測する次トークン予測を使います。学習データ中の続きと比べ、予測のずれを小さくする方向へパラメータを調整します。パラメータは、モデル内部で学習により調整される数値です。
例えば『入口で靴を』の後に続く単位には複数の候補があります。モデルは候補ごとの出やすさを数値で表します。この候補ごとの確率のまとまりが確率分布です。もっとも出やすい続きであることと、その施設の本当の利用規則であることは別です。言葉の続きの予測だけから、現実の事実を保証できません。
根拠:Google ML Crash Course: What is a large language model?(別タブで開く) ↗ / Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
利用時の推論は、学習済みのモデルを使って、今の入力に対する出力を求めることです。指示文や例を入力に加えれば出力は変わり得ますが、それだけで学習済みパラメータを更新したことにはなりません。ここでは、学習を別に実行せず、パラメータを固定して使う場合を考えます。
架空の文書整理ツールに『見出しは短く』と入力し、続いて好みの見出し例を一つ添えるのは、利用時の手掛かりを変える方法です。その入力を別途学習用データへ取り込んでパラメータを調整したなら、そこで追加の学習が行われたことになります。入力を保存したか、その入力を後の学習に使うか、今回の処理でモデル内部の数値(パラメータ)を更新したかは、それぞれ別に確認します。
この後の比較に使う二つの言葉を、先に押さえます。指示チューニングは、指示と望ましい回答の組などを使い、指示へ応答するようモデルのパラメータを学習で調整する方法です。利用時に指示を書き換えることとは別です。
報酬モデルは、人が回答候補を比較したデータなどから、回答の望ましさを評価値として予測するよう学ぶモデルです。回答文の見本を学んで文章を作る側の学習とは、使う資料と出す結果が異なります。今扱っている、パラメータを固定したまま入力例を利用する条件から、これらの学習が実行されたとはいえません。詳しい進め方は、次の二節で学びます。
根拠:Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗ / Wei et al.: Finetuned Language Models Are Zero-Shot Learners(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
 図を拡大する ↗
今の指示と例を学習済みモデルへ渡し、出力を得ます。この行はパラメータ更新なしという条件です。利用時に例を添えることだけで上段の学習が行われたとはいえません。
トークンは処理単位で、一文字・一単語と固定対応しません。将来のデータ利用設定は、この図では判断しません。
学習と固定推論を分けた代表例です。実製品のデータ利用設定や全学習手順を保証する図ではありません。
根拠:Google ML Crash Course: What is a large language model?(別タブで開く) ↗ / Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
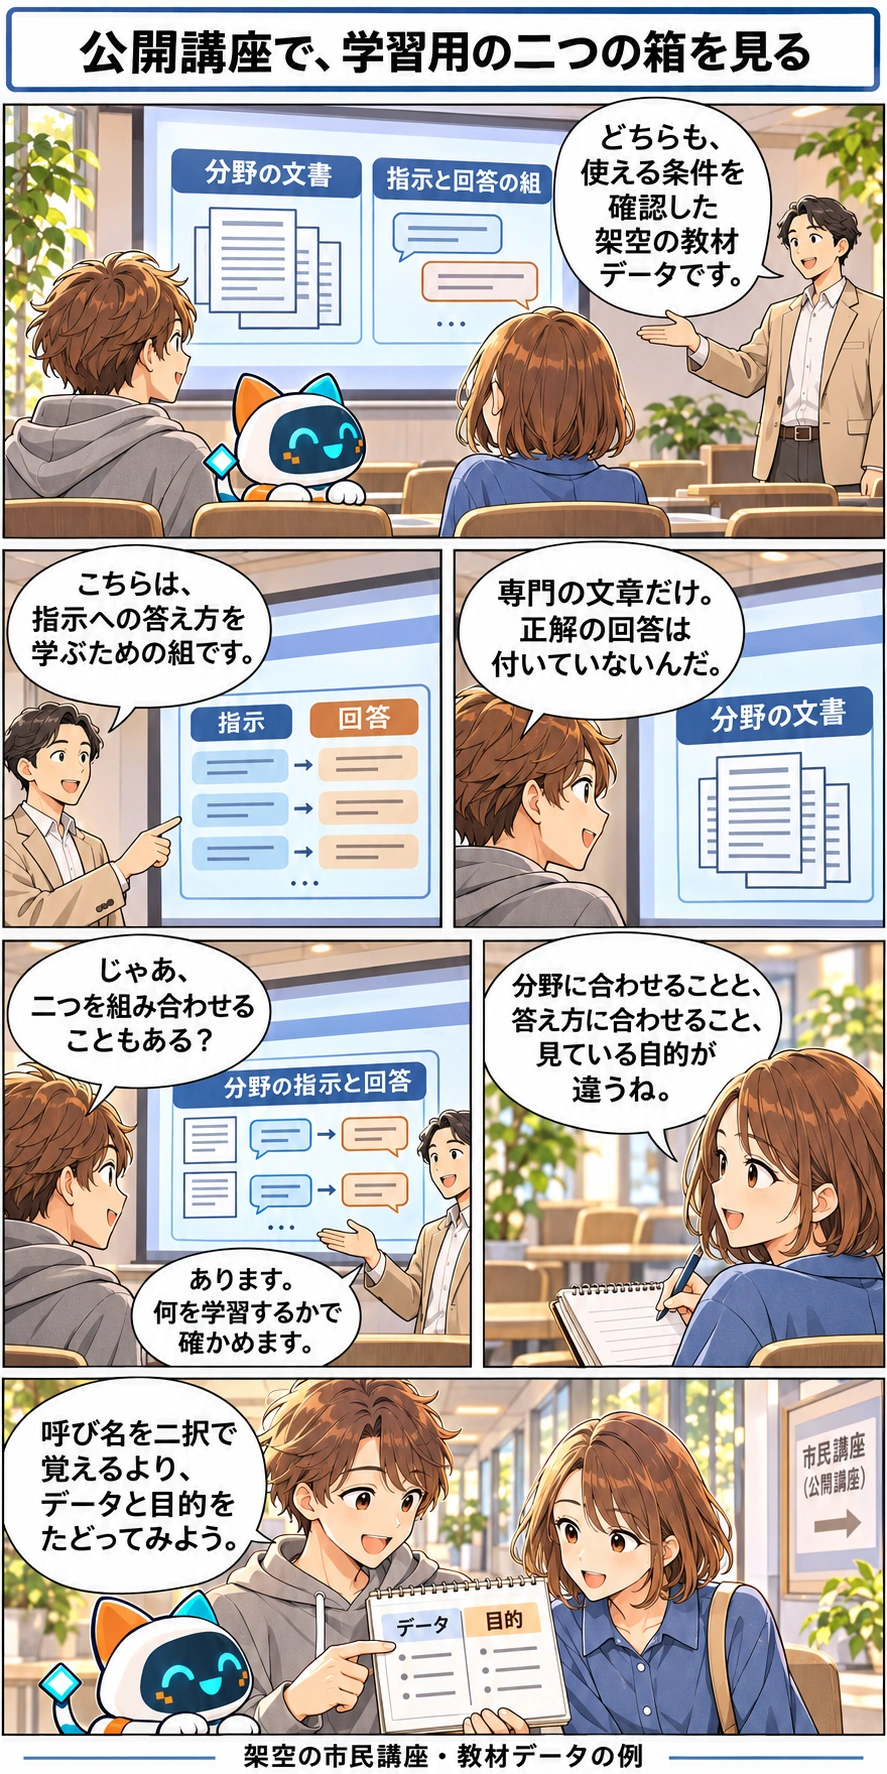
この話で学ぶこと:専門分野の文書と、指示/望ましい回答の組は目的が異なり、重なることもある。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:教室全景。講師が『分野の文書』『指示と回答の組』の二つを示す
講師「どちらも、使える条件を確認した架空の教材データです。」場面:文書群の寄り。質問/回答欄はなく本文だけ
ハル「専門の文章だけ。正解の回答は付いていないんだ。」場面:講師の手とスクリーンを同時に。指示/回答ペアに切替わる
講師「こちらは、指示への答え方を学ぶための組です。」場面:ミオの肩越しのノート。左右を機械的に入れ替えない
ミオ「分野に合わせることと、答え方に合わせること、見ている目的が違うね。」場面:講師が『分野の指示と回答』を重ねた第三の例を見せる
ハル「じゃあ、二つを組み合わせることもある?」講師「あります。何を学習するかで確かめます。」場面:帰り際の廊下。ハルがノートを左手で持ち、右手で二つの欄を指す。ビットは見せられたノートを見る
ハル「呼び名を二択で覚えるより、データと目的をたどってみよう。」職場で使う説明の直し方には、毎回の手掛かりを添える方法と、モデルを調整する方法があります。場面で決めた手順が、そのままモデルの学習工程だとは扱いません。
ファインチューニングは、事前学習したモデルに追加のデータで学習を行い、用途に合うよう調整することです。追加学習という広い言い方でも、利用時に資料を添えるだけの処理と、学習によるパラメータの更新を分けます。方法によって、元の全パラメータを更新する場合と、一部の調整用パラメータなどを学習する場合があります。
教師ありファインチューニングでは、入力と望ましい出力の組を使って調整します。例えば架空の申請文と、担当者が確認した適切な処理先の組です。組の正しさ、対象となる業務、学習に使わない別の評価例をそろえて確かめます。例を覚えたことだけで、未知の文にも正しく答えられるとは認定しません。
根拠:Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗ / Google ML Crash Course: Dividing the original dataset(別タブで開く) ↗
指示チューニング(Instruction Tuning)は、要約や言い換えなど、自然言語で書かれた指示と、その指示に沿う回答例を用いた調整です。指示にどう応えるかを学ぶための学習で、利用者が一回の依頼文を詳しく書くことと区別します。
教師ありは望ましい出力の例を使う学び方、指示チューニングは指示に従うためのデータや目的に注目した呼び方です。指示と回答を組にした教師ありの調整であれば、両方の呼び方に当てはまることがあります。互いに重ならない二択へ無理に分けません。
根拠:Wei et al.: Finetuned Language Models Are Zero-Shot Learners(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
ドメインは、扱う分野や、データが使われる範囲です。ドメイン適応は、対象となる分野のデータや特徴へモデルを合わせる考え方です。例えば、利用できることを確認した専門分野の文書で、既存の言語モデルに追加の事前学習を行う方法があります。必ず全ての文書へ人が正解の回答を書き足す方法だけではありません。
分野へ適応させる目的と、指示への応答を学ぶ目的は、別の軸です。特定分野の指示と回答を使うなど、組み合わせる場合もあります。新しい規則を一件参照したいだけなら、まず最新資料を入力に与える方法等も比較し、毎回の追加学習が必須とは考えません。どの方法でも、利用できるデータと、出力を確かめる基準が必要です。
根拠:Gururangan et al.: Don’t Stop Pretraining: Adapt Language Models to Domains and Tasks(別タブで開く) ↗ / Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗
 図を拡大する ↗
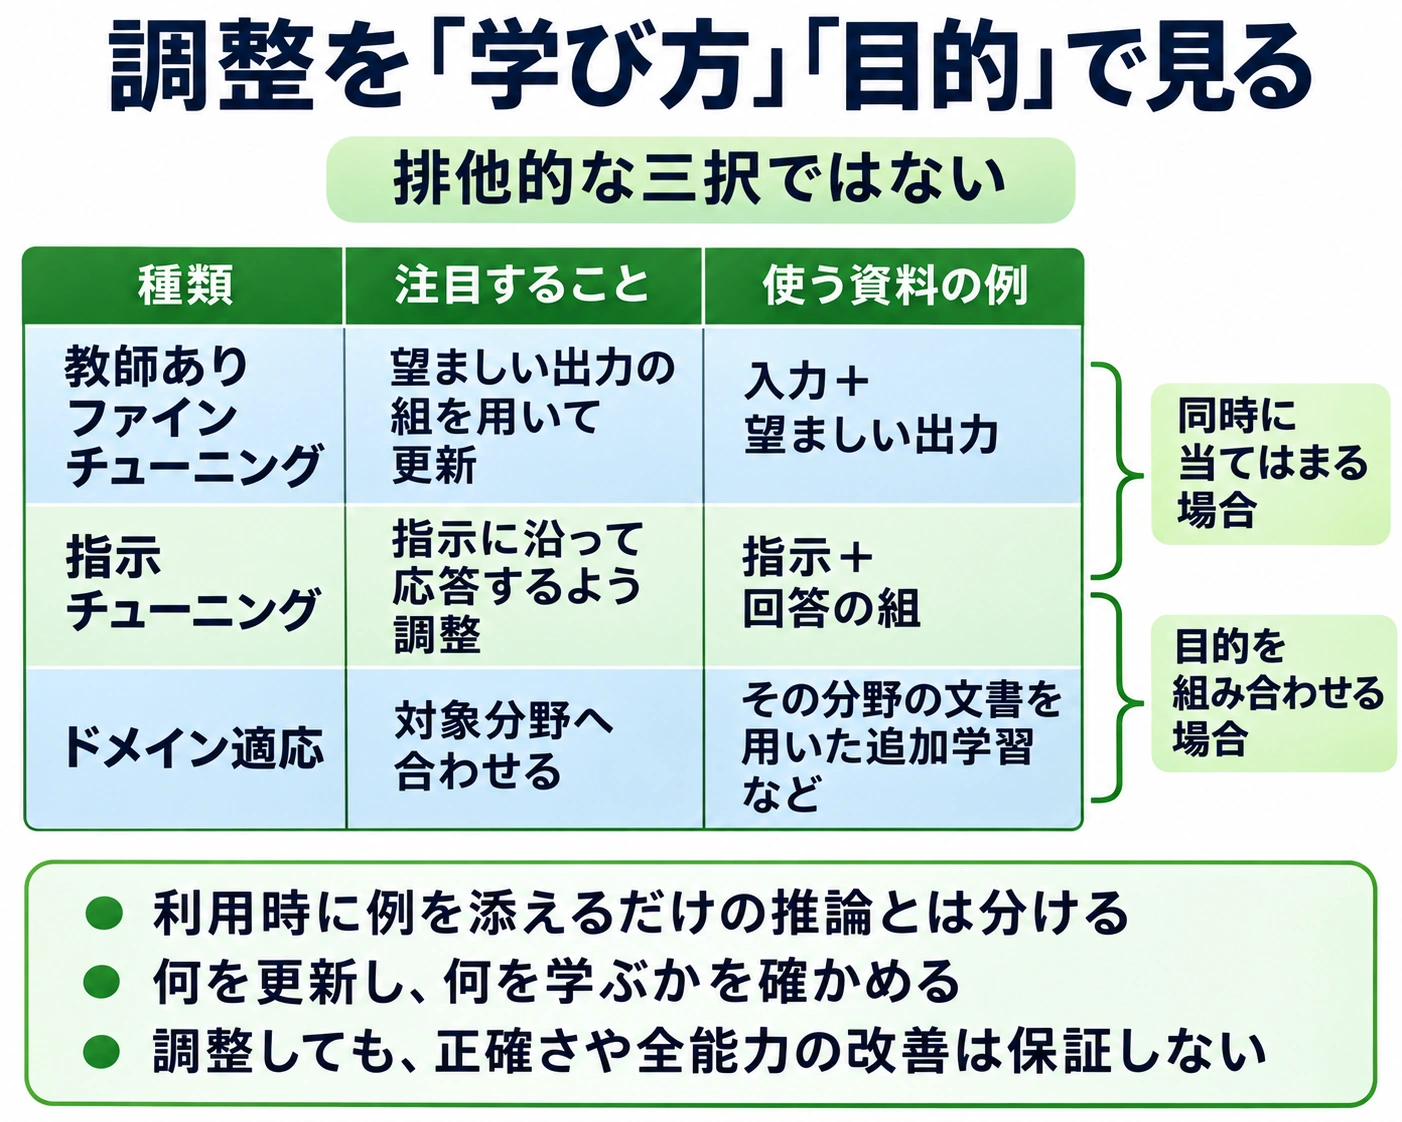
排他的な三択ではありません。学び方と目的という異なる見方を整理します。
望ましい出力の組を用いて更新します。資料の例は、入力と望ましい出力の組です。
指示に沿って応答するよう調整します。資料の例は、指示と回答の組です。
対象分野へ合わせます。その分野の文書を用いた追加学習などがあります。
教師ありと指示チューニングが同時に当てはまる場合や、分野への適応と指示に応じる目的を組み合わせる場合があります。括弧は重なりの基本例で、全関係を定義した厳密な集合図ではありません。
利用時に例を添えるだけの推論とは分け、何を更新し何を学ぶかを確かめます。調整しても、正確さや全能力の改善は保証しません。
分類名だけで目的・学習データ・更新対象を決めず、組合せと条件を確認します。
根拠:Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗ / Wei et al.: Finetuned Language Models Are Zero-Shot Learners(別タブで開く) ↗ / Gururangan et al.: Don’t Stop Pretraining: Adapt Language Models to Domains and Tasks(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
この話で学ぶこと:好みに合う評価と、現実の事実の確認を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:停留所の引き。架空の案内文を見比べる紙に『読み比べの練習』とある
ハル「こっちの文、短くて分かりやすいね。」場面:ミオが紙の『臨時停留所は確認中』と、短い候補文の『臨時停留所へ』を見比べる
ミオ「でも、行き先はまだ確認中って書いてあるよ。」場面:ハルが紙とスマホをビットへ見せた後の三者。基準の位置を保つ
ビット「読みやすさの評価と、本当に決まったかは別だね。」ハル「好きな方を選ぶだけじゃ足りないんだ。」場面:公的に掲示された連絡先を確かめる二人。『確認中』を消して架空の確定情報にしない
ミオ「まず案内元で確かめよう。その後で、伝え方を比べたいな。」二つの案内を比べる人の行動を入口にします。本文では、比較データを使う評価モデルと、評価を手掛かりに更新する回答モデルを区別します。漫画は特定製品の実験結果ではありません。
人間の評価では、回答が依頼に沿うか、読みやすいか、有害な内容を含まないかなどを、決めた基準で調べます。人が望ましい回答の見本を書くことと、複数の候補を比較して順位を付けることは、違う種類の学習資料になります。
架空の利用案内への二つの回答を、『必要な条件があるか』『資料にないことを加えていないか』で比較するとします。比較者ごとに基準が違うと評価も変わり得るため、誰が何の基準で比べたかを確認します。人気があるという評価と、原資料で確かめた事実は同じものではありません。
根拠:Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗ / Google ML Crash Course: Numerical data — Scrubbing(別タブで開く) ↗
報酬は、ここでは回答の望ましさを表す点数(評価値)で、モデルの学習に使います。報酬モデルは、人の比較などのデータから、どの回答が望ましいと評価されそうかを予測します。たとえば、回答を作る側は文章の小さな単位(トークン)をつないで「受付は9時からです」という案内文を出します。報酬モデルは依頼とその案内文を受け取り、調整の手掛かりになる点数を返します。
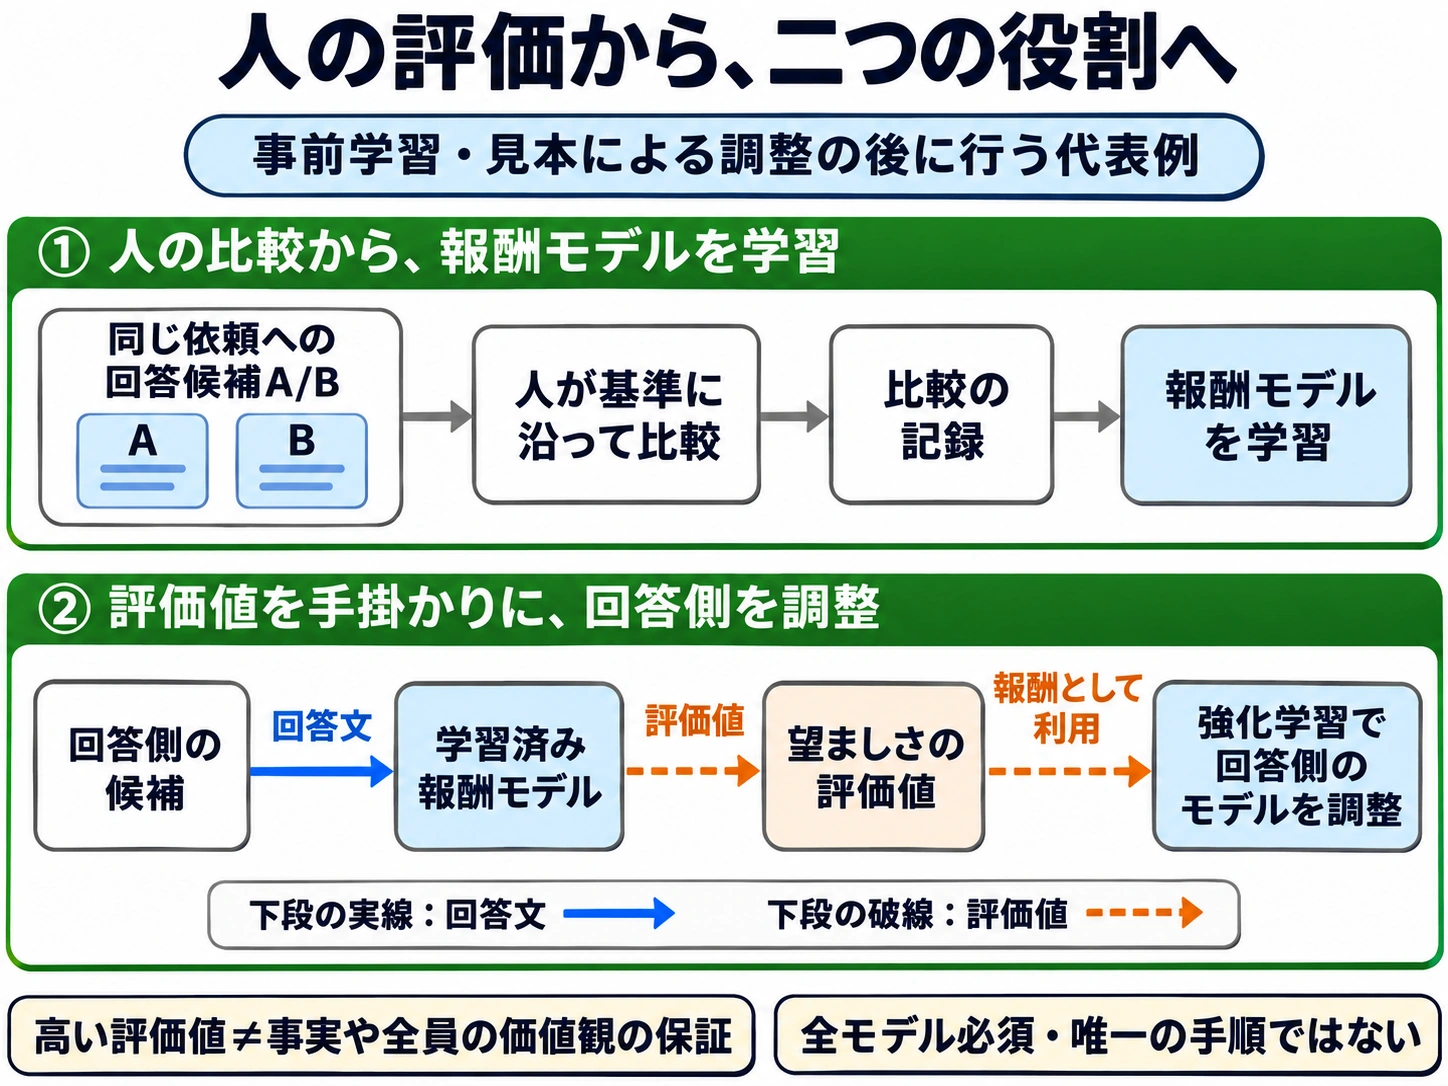
RLHF(Reinforcement Learning from Human Feedback:人間のフィードバックによる強化学習)では、人の評価を手掛かりにモデルを調整します。代表的な流れは、人の比較で報酬モデルを学習し、その評価値を報酬として、回答を作るモデルを強化学習で更新するものです。単に回答の表示順位を変えるだけの処理ではありません。
根拠:Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
この教材では、公式範囲に沿って事前学習、ファインチューニング、RLHFという代表的な整理で学びます。ただし、全てのモデルがこの三つを必ず一度ずつ同じ順で行う、という意味ではありません。人の比較やモデルの調整を繰り返す構成もあります。
調整後も、事実に合わない回答や偏りは残り得ます。どの人の評価へ合わせたか、評価していない利用者や課題でも成立するかを別に調べます。高い報酬の回答であっても、現実の開催日や料金は一次資料で確かめる必要があります。
根拠:GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
 図を拡大する ↗
事前学習・見本による調整の後に行う代表的なRLHFの例です。全モデルに必須の唯一の手順ではありません。
高い評価値は、事実や全員の価値観への適合を保証しません。人の比較記録・評価値・回答文は別の役割です。
二つの学習対象と、回答文/評価値の線種を分けた概念図です。実際の特定サービスの内部方式を認定しません。
根拠:Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
この話で学ぶこと:資料の量、重複や誤記、使える条件を別々に確かめる。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:束のある机の引き。主催者が架空の準備データの一覧を見せる
主催者「案内の練習用に、資料候補を集めたんです。」ハル「たくさんあれば安心かな?」場面:同じ番号の二枚が重なる手元。主催者の右手で一枚ずつずらす
ミオ「この二枚、同じ記録みたい。」場面:主催者が「同じ記録/分類欄は1つ」のカードを示す。同一記録の一つの分類欄を同じ基準で比べ、AとBが食い違っている。ハルは横から見ている。
主催者「こっちは、同じ基準なのに分類が違っている。」場面:ミオが一枚の利用条件欄を指す。架空の文書で実在作品の画面をコピーしない
ミオ「内容の整理と、使ってよい条件も別に確認したいね。」場面:ハルが『重複/分類基準/利用条件』の短いメモを自分で作る。左手ノート/右手ペンで持ち物を固定
ハル「増やす前に、何が入っているかを確かめよう。」資料を整理する場面で、重複や誤記、使える条件を別々に調べます。架空の表の点検を、実在する学習用データ全体が安全だという評価にはしません。
学習データは、モデルのパラメータを調整するために使う資料です。データの品質は、目的に合うか、誤記や欠損がないか、同じ例の重複や、入力と正解ラベルの取り違えがないかなどで確かめます。保存容量や行数が大きいことだけを品質としません。
架空の問い合わせデータに同じ文が繰り返し登録され、別の担当者が異なる正解ラベルを付けていたら、行数をそのまま実例の多様さと数えられません。重複の由来とラベルの基準を調べ、誤りなら修正し、利用目的に合う資料をそろえます。評価用の正解を学習へ混ぜて高得点にする方法とは分けます。
根拠:Google ML Crash Course: Numerical data — Scrubbing(別タブで開く) ↗ / Google ML Crash Course: Dividing the original dataset(別タブで開く) ↗
バイアスは偏りのことです。ある地域や言い方の資料だけに偏ると、別の条件でうまく扱えない場合があります。収集対象、正解の付け方、人の評価の基準、学習方法なども確認し、人が評価したから偏りがなくなったとは考えません。
ハルシネーションは、事実や与えた根拠に合わない内容を、もっともらしく生成する現象です。単なる量の追加や一つの調整手法で必ずなくなるとはいえません。例えば資料にない貸出条件を自然な文で補ってしまったら、元の案内と照合し、根拠のある部分と推測を分けます。詳しい生成の仕組みと確認は次の教材でも扱います。
根拠:Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗ / Google ML Crash Course: Fine-tuning, distillation, and prompt engineering(別タブで開く) ↗ / Google ML Crash Course: Numerical data — Scrubbing(別タブで開く) ↗
著作権は、文章や画像などの創作的な表現に関わる権利です。公開されていて読めることと、どんな学習・再配布・出力にも自由に使えることを同じにしません。学習の目的や行為、利用する資料、適用される法の条件、契約やライセンスによる許諾の範囲を確認します。ライセンスは、利用を認める条件のことです。
日本の著作権法には、表現を鑑賞するなどの享受を目的としない情報解析について、必要な限度で許諾なく利用できる場合があります。一方、享受目的が併存する場合や、著作権者の利益を不当に害する場合などは、同じ規定を適用できません。『AI学習用だから何でも自由』とも『学習は例外なく毎回許諾が必要』ともまとめず、判断できない資料は採用前に条件を確認します。
根拠:文化庁:AIと著作権に関する考え方について 概要(2024-04)(別タブで開く) ↗ / 文化庁:AIと著作権に関するチェックリスト&ガイダンス(2024-07-31)(別タブで開く) ↗
 図を拡大する ↗
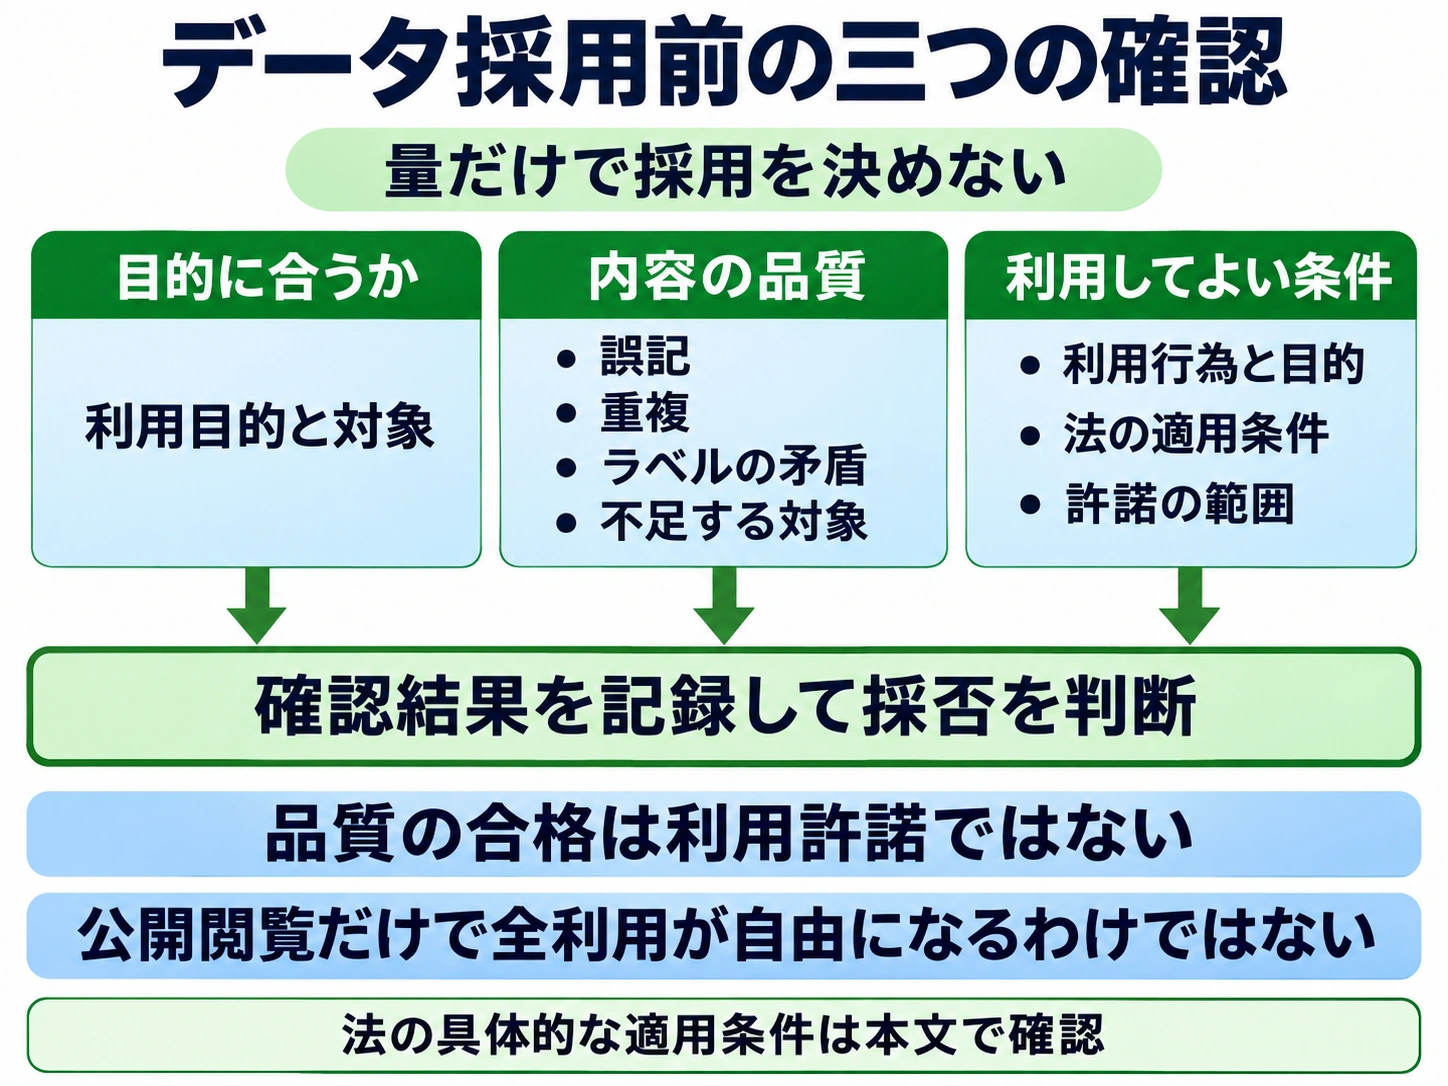
量だけで採用を決めず、次の三つを並列に確認します。
利用目的と対象を確認します。
誤記、重複、ラベルの矛盾、不足する対象を確認します。
利用行為と目的、法の適用条件、許諾の範囲を確認します。
三つの確認結果を記録して採否を判断します。品質の合格は利用許諾ではなく、公開閲覧だけで全利用が自由になるわけではありません。法の具体的な適用条件は上の本文で確認します。
個別データの法務確認済みを示す印ではありません。享受目的や利益を不当に害する場合などを含む本文の条件を合わせて読みます。
根拠:Google ML Crash Course: Numerical data — Scrubbing(別タブで開く) ↗ / Google ML Crash Course: Dividing the original dataset(別タブで開く) ↗ / 文化庁:AIと著作権に関するチェックリスト&ガイダンス(2024-07-31)(別タブで開く) ↗ / 文化庁:AIと著作権に関する考え方について 概要(2024-04)(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
この話で学ぶこと:規模による観測と測り方を分け、全課題の保証へ広げない。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:屋外ブース全景。モデル群の比較画面を見る
ハル「ここから急に、できることが増えたの?」場面:説明員の手元。画面のタブ『全体一致だけ』『一部も見る』を切り替える動作
説明員「同じ出力を、別の基準でも見てみましょう。」場面:ハルの顔と表示の近景。タブ名を見て前との違いを知る
ハル「あれ。こっちだと、少しずつ変わって見える。」場面:説明員の肩越し。基準画面の左右と実際の立ち位置を区別
説明員「何ができたかに加えて、どう採点したかも確認します。」場面:ハルが画面の『このデモの条件』を指す。ビットはその画面を同時に見られる位置
ハル「大きくしたら全部できる、とは決められないんだね。」ビット「課題と条件も、一緒に読もう。」場面:ブースを離れる引き。ハルは持ち帰り用メモを左手、右手は空で、追加のスマホを急に持たせない
ハル「次は、自分が確かめたい課題で比べてみたいな。」科学フェアの説明用デモで、同じ出力を「全体一致だけ」「一部も見る」という別の基準で採点します。この場面を入口に、本文で課題・モデルの規模・データや計算条件・性能の測り方を分けて確認します。漫画の架空デモを実在モデルの実測結果や、全課題の性能保証にはしません。
スケーリング則(Scaling Laws)は、モデルのパラメータ数、学習データ量、学習に使う計算量などの規模と、損失などの性能指標の間に見られる傾向です。損失は、予測と学習上の目標とのずれを表す評価値です。研究では、条件をそろえた範囲で規模と損失の関係を調べます。
この関係は、全ての種類の問題で、モデルを二倍にすれば正答率が二倍になるという規則ではありません。何を測ったか、どのデータや計算条件か、調べた範囲の外へ広げていないかを確認します。ある実験の平均的な改善を、一件の事実の正しさへ読み替えません。
根拠:Kaplan et al.: Scaling Laws for Neural Language Models(別タブで開く) ↗
創発的能力は、規模の小さいモデルでは見られなかった能力が、より大きいモデルで現れるとされる現象を指します。小さいモデルの結果を単純に延ばしただけでは予想しにくい能力として研究されました。意識や意図を持った、という意味の言葉ではありません。
能力が急に現れたように見えるかは、測り方にも左右されます。完全一致だけを正解とする評価と、部分的な進歩も数える評価では、同じ出力でも変化の見え方が違う場合があります。そのため、創発はどんなモデルにも必ず起こるとも、全て測定上の錯覚だとも断定しません。課題と評価基準を確かめます。
根拠:Wei et al.: Emergent Abilities of Large Language Models(別タブで開く) ↗ / Schaeffer et al.: Are Emergent Abilities of Large Language Models a Mirage?(別タブで開く) ↗
架空の試験で、モデル小とモデル大を同じ未学習の説明文で比べるとします。問題や採点基準が別なら、数値の差が何によるものかを切り分けられません。データと条件をそろえ、平均点だけでなく、苦手な場面や誤りの内容も見ます。
学習方法の整理へ戻ると、広く学ぶ、用途に調整する、人の評価を使うという各段階で、目的と資料と評価を確認します。規模の拡大はその中の一つの工夫です。目的に合うか、根拠に合うか、利用してよいかは別々に確かめます。
根拠:Kaplan et al.: Scaling Laws for Neural Language Models(別タブで開く) ↗ / Schaeffer et al.: Are Emergent Abilities of Large Language Models a Mirage?(別タブで開く) ↗ / Google ML Crash Course: Dividing the original dataset(別タブで開く) ↗ / GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別タブで開く) ↗ / Ouyang et al.: Training language models to follow instructions with human feedback(別タブで開く) ↗ / 文化庁:AIと著作権に関するチェックリスト&ガイダンス(2024-07-31)(別タブで開く) ↗
 図を拡大する ↗
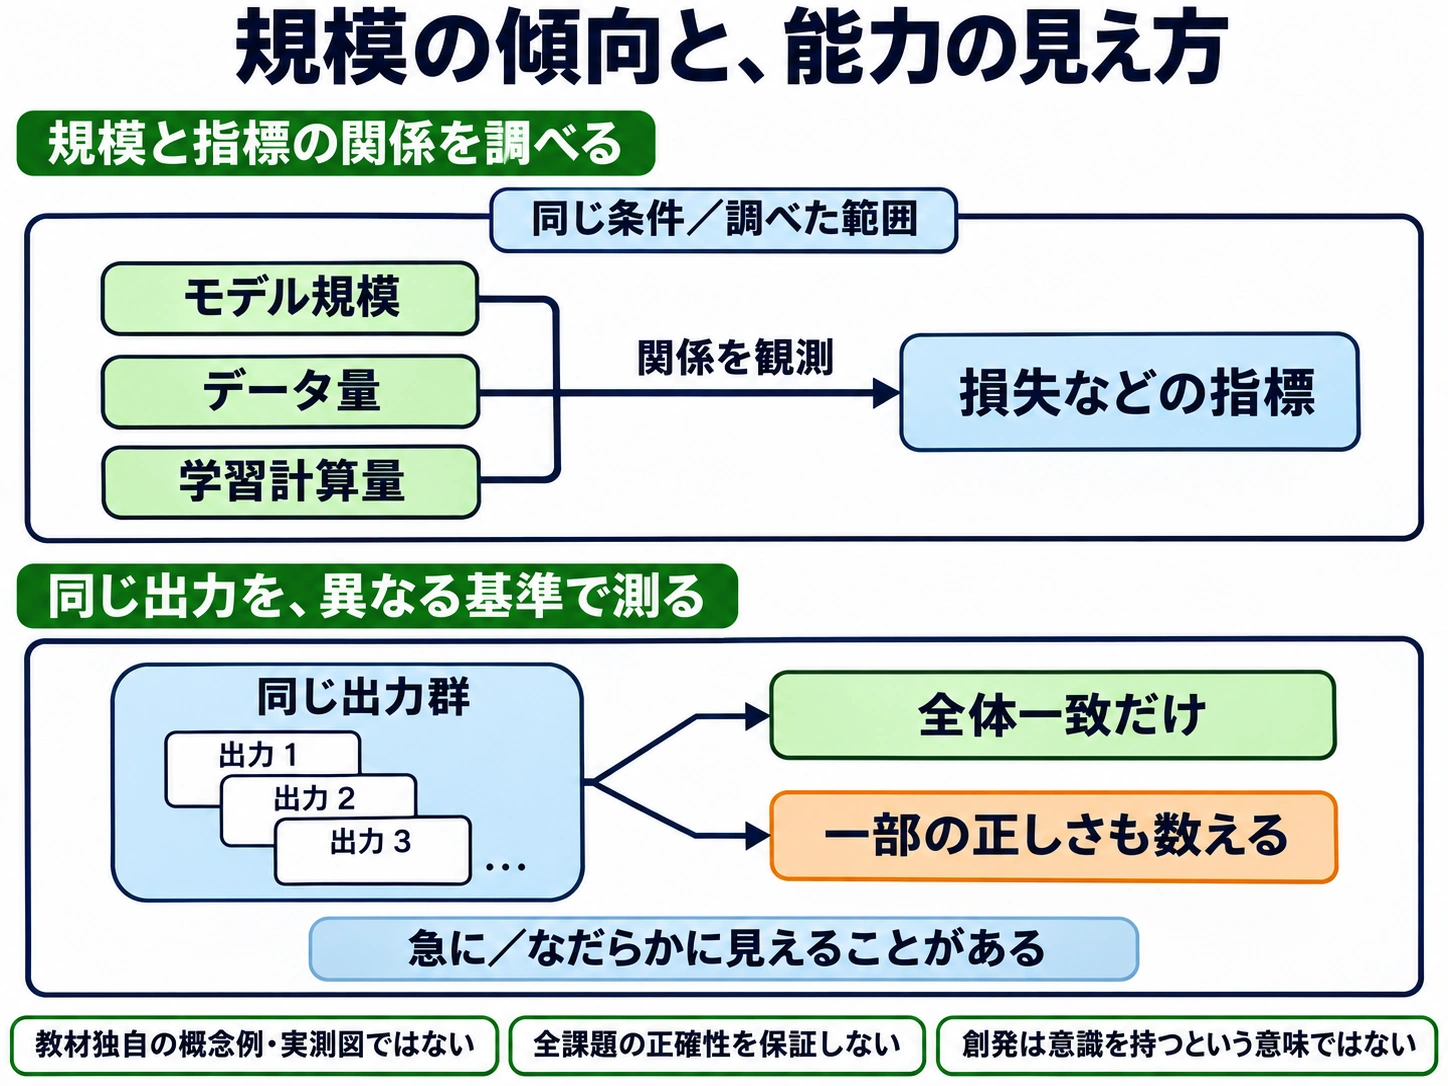
同じ条件・調べた範囲の中で、モデル規模、データ量、学習計算量と、損失などの指標の関係を観測します。未測定領域で無限に向上する万能グラフではありません。
一つの同じ出力群から、「全体一致だけ」と「一部の正しさも数える」という二つの採点枠へ分岐します。別の出力へ替えず、同じ出力の測り方を変える関係です。急に、またはなだらかに見えることがあります。
教材独自の概念例で、創発を実証・反証する実測図ではありません。全課題の正確性を保証せず、創発は意識を持つという意味ではありません。
出力1/2/3は模式的な識別です。線長や箱面積はモデル性能・測定数・計算量の実数を表しません。
根拠:Kaplan et al.: Scaling Laws for Neural Language Models(別タブで開く) ↗ / Wei et al.: Emergent Abilities of Large Language Models(別タブで開く) ↗ / Schaeffer et al.: Are Emergent Abilities of Large Language Models a Mirage?(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。