この教材の目次を開く
回答はこのページを開いている間だけ保持します。別ページへの移動や再読み込みで消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
1文章を区切り、番号と数値の表現へ変える
AIに渡した文章は、そのまま文字の形で計算されるのでしょうか。
- トークン化・ID・埋め込みの役割を順に説明する
- 表現の近さと事実の一致を分ける
同じ見出しでも、条件は同じ?
この話で学ぶこと:同じ見出しの案内でも、対象条件の違いまで読む。
コマは上から下へ、横に並んだコマは右から左へ読みます。
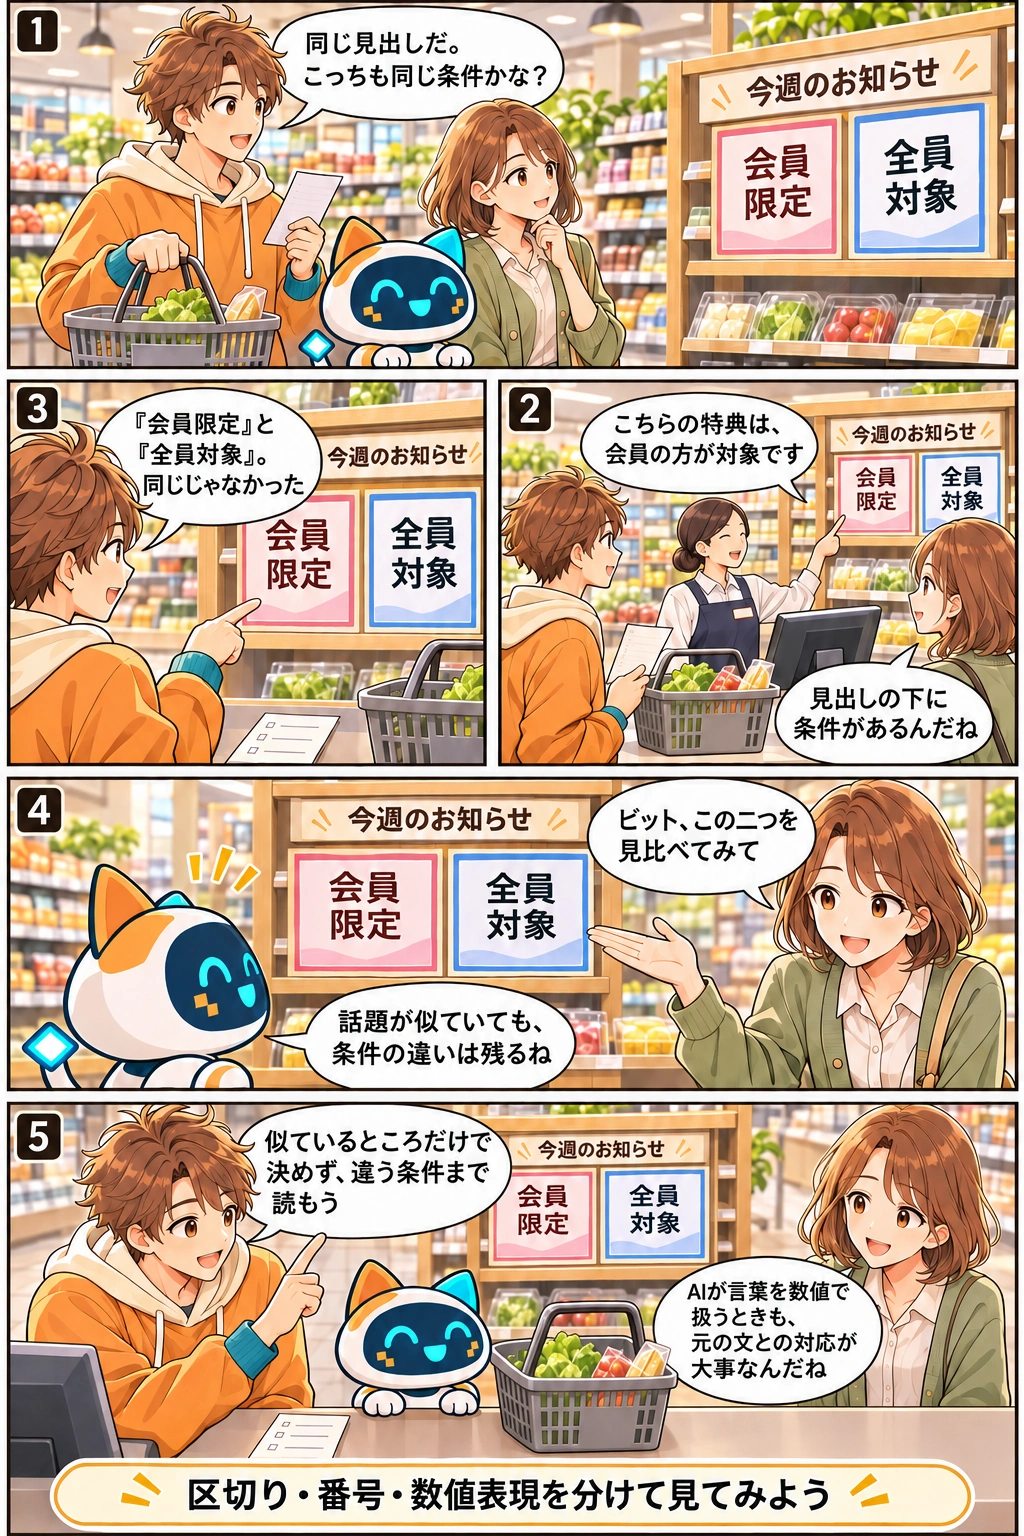
会話を文章で読む
場面:スーパーの棚に、同じ見出しの下で「会員限定」と「全員対象」が別枠に並ぶ。ハルはかごとメモを持ち、ミオとビットも近くにいる。
ハル「同じ見出しだ。こっちも同じ条件かな?」場面:会計係が棚の条件を示す。かごは台上にあり、二人は客側から説明を聞く。
店員「こちらの特典は、会員の方が対象です」 ミオ「見出しの下に条件があるんだね」場面:ハルの肩越しに二つの条件カードを比べる。メモは台上へ置かれ、空いた手で違いを示す。
ハル「『会員限定』と『全員対象』。同じじゃなかった」場面:ミオが二つのカードをビットへ示す。両方を見てから、ビットが条件の違いについて話す。
ミオ「ビット、この二つを見比べてみて」 ビット「話題が似ていても、条件の違いは残るね」場面:ハルとミオが元の文まで確かめる。かごは二人の内側の台上に残る。欄外の案内は「区切り・番号・数値表現を分けて見てみよう」。
ハル「似ているところだけで決めず、違う条件まで読もう」 ミオ「AIが言葉を数値で扱うときも、元の文との対応が大事なんだね」
スーパーで見つけた二つの案内は、話題が似ていても対象条件が違いました。人が案内の違いを読む場面を入口に、AIが文字列を処理単位と数値へ変える工程を見ていきます。値札の番号そのものをAIの埋め込みと同一視する話ではありません。
区切る工程と、番号を付ける工程を分ける
言語モデルは文章を数値で処理します。まず文章をトークンという処理単位へ分ける工程がトークン化です。単語をより小さな部分へ分けるサブワードも使われ、一文字・一単語と一トークンが常に一致するわけではありません。使う方式によって区切り方は違います。
次に、その方式の語彙表に対応する番号、トークンIDへ変換します。例えば、架空の方式で「春が来た」を「春/が/来た」と区切り、ID「18/7/42」を付けたとします。区切ることと番号へ変えることは別の工程です。このIDは教材用で、実サービスの出力ではありません。IDが隣同士でも、意味が似ることを表す番号ではありません。
識別する番号から、計算に使うベクトルへ
埋め込み(Embedding)は、情報を複数の数値の並びで表す方法です。この数値の並びをベクトルと呼びます。トークンIDで識別した単位を埋め込みへ変換すると、モデルは数値どうしの関係を計算できます。IDという一つの識別番号と、情報を表す数値の並びを区別しましょう。
学習した表現では、似た使われ方や特徴を持つ情報が近い位置に表されることがあります。ただし、ベクトルの各数値に人が読める意味が一つずつ付いているとは限りません。文脈を加味して表現を変えるモデルもあり、同じ語なら最終的な表現まで必ず同じとはしません。
根拠:Embedding space — Machine Learning Crash Course(別タブで開く) ↗ / Tokenizers — LLM Course(別タブで開く) ↗ / Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗
数値の近さは、条件や真偽の一致ではない
例えば「予約が必要です」と「予約は不要です」は、同じ話題の語を多く含みます。仮に二つの文の表現が近かったとしても、利用条件は反対です。表現の近さは、内容が同一であることや、現実に正しいことの証明ではありません。違いが重要な場面では、元の文の否定や条件まで読みます。
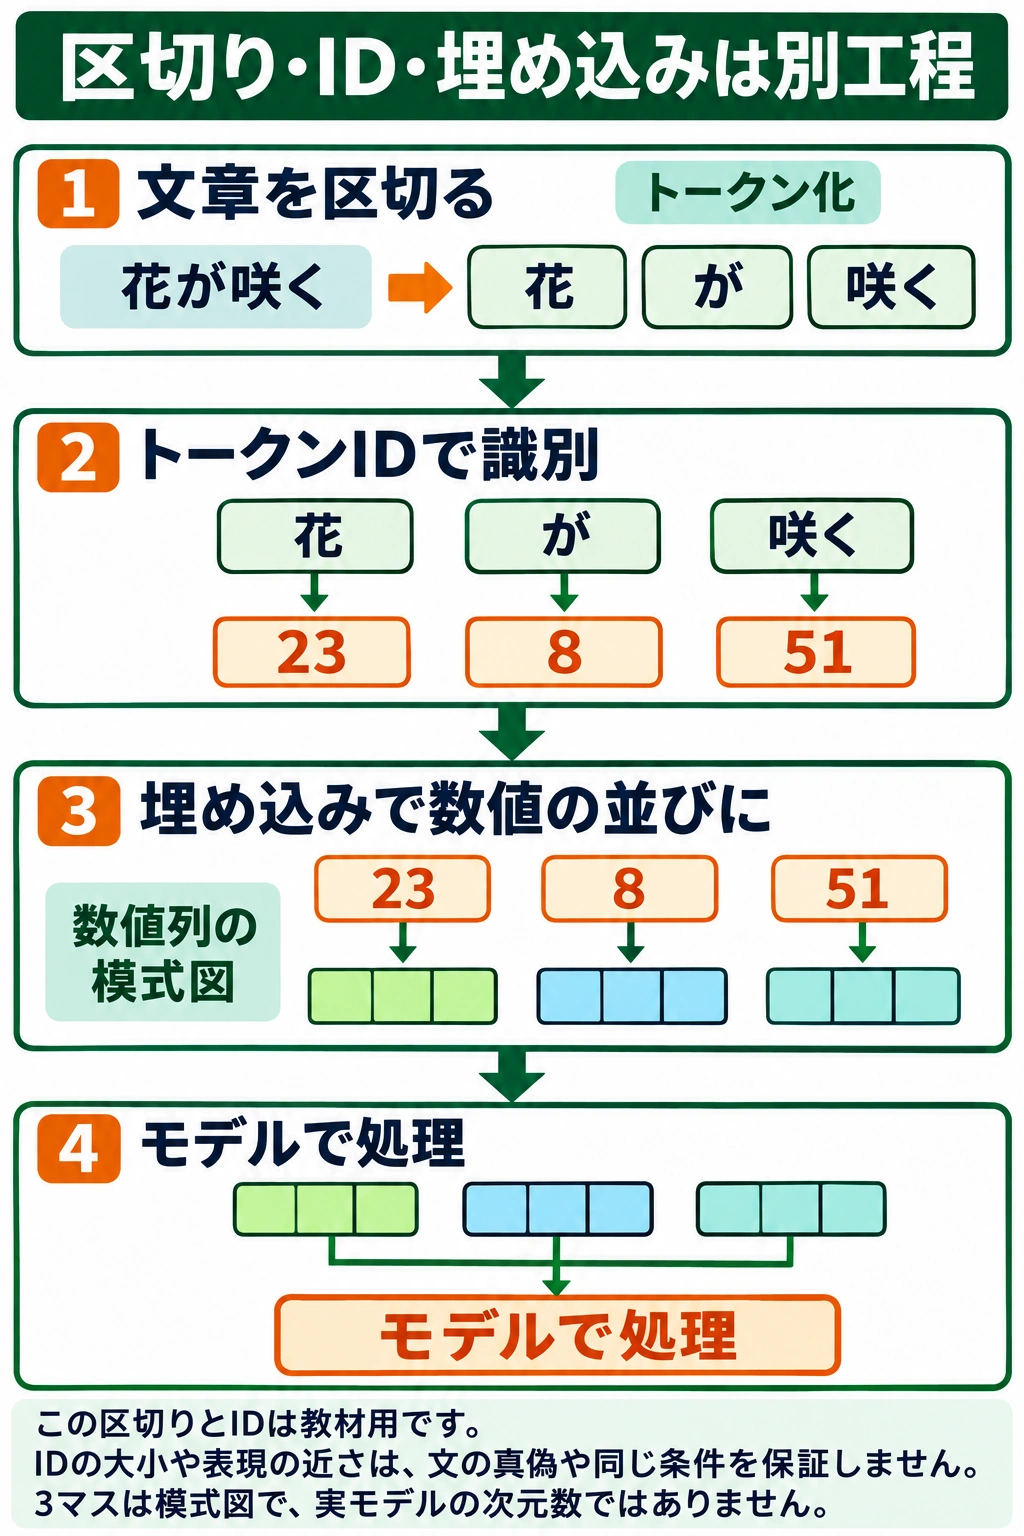
入力の工程は「文章を区切る→IDで識別する→埋め込みの数値表現へ変える→モデルで処理する」と整理できます。似た文を探す手掛かりになることと、どの条件が実際に適用されるかは別です。番号や距離だけで判断を終えず、元の文章との対応を確認します。
根拠:Embedding space — Machine Learning Crash Course(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗ / Tokenizers — LLM Course(別タブで開く) ↗
 図を拡大する ↗
図の内容を文章で確認する
- 文章を区切る(トークン化):架空の例「花が咲く」を「花/が/咲く」へ分けます。
- トークンIDで識別:教材用のID「23/8/51」へ対応させます。
- 埋め込みで数値の並びに:それぞれの単位を数値の並びによる表現へ変えます。
- モデルで処理:その数値表現を処理します。矢印は変換・処理の順序です。
この区切りとIDは教材用です。三つの無数値セルは数値列の模式図で、実モデルの埋め込み次元数を三次元と教える図ではありません。セルごとに固定の意味を割り当てていません。
IDの大小や表現の近さは、文の真偽や同じ条件を保証しません。
教材用の架空の区切り・IDと数値列の模式図です。処理の順序を、事実確認の完了を表す矢印とは読みません。
根拠:Tokenizers — LLM Course(別タブで開く) ↗ / Embedding space — Machine Learning Crash Course(別タブで開く) ↗ / Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
2続きの候補と、選び方の設定を分ける
出やすい言葉を選べば、必ず正しい文章になるのでしょうか。
- 次の候補の確率と事実の確かさを区別する
- TemperatureとTop-pの役割を比較する
同じ依頼なのに、言い回しが変わる
この話で学ぶこと:同じ依頼の出力を比べ、選び方と事実確認を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
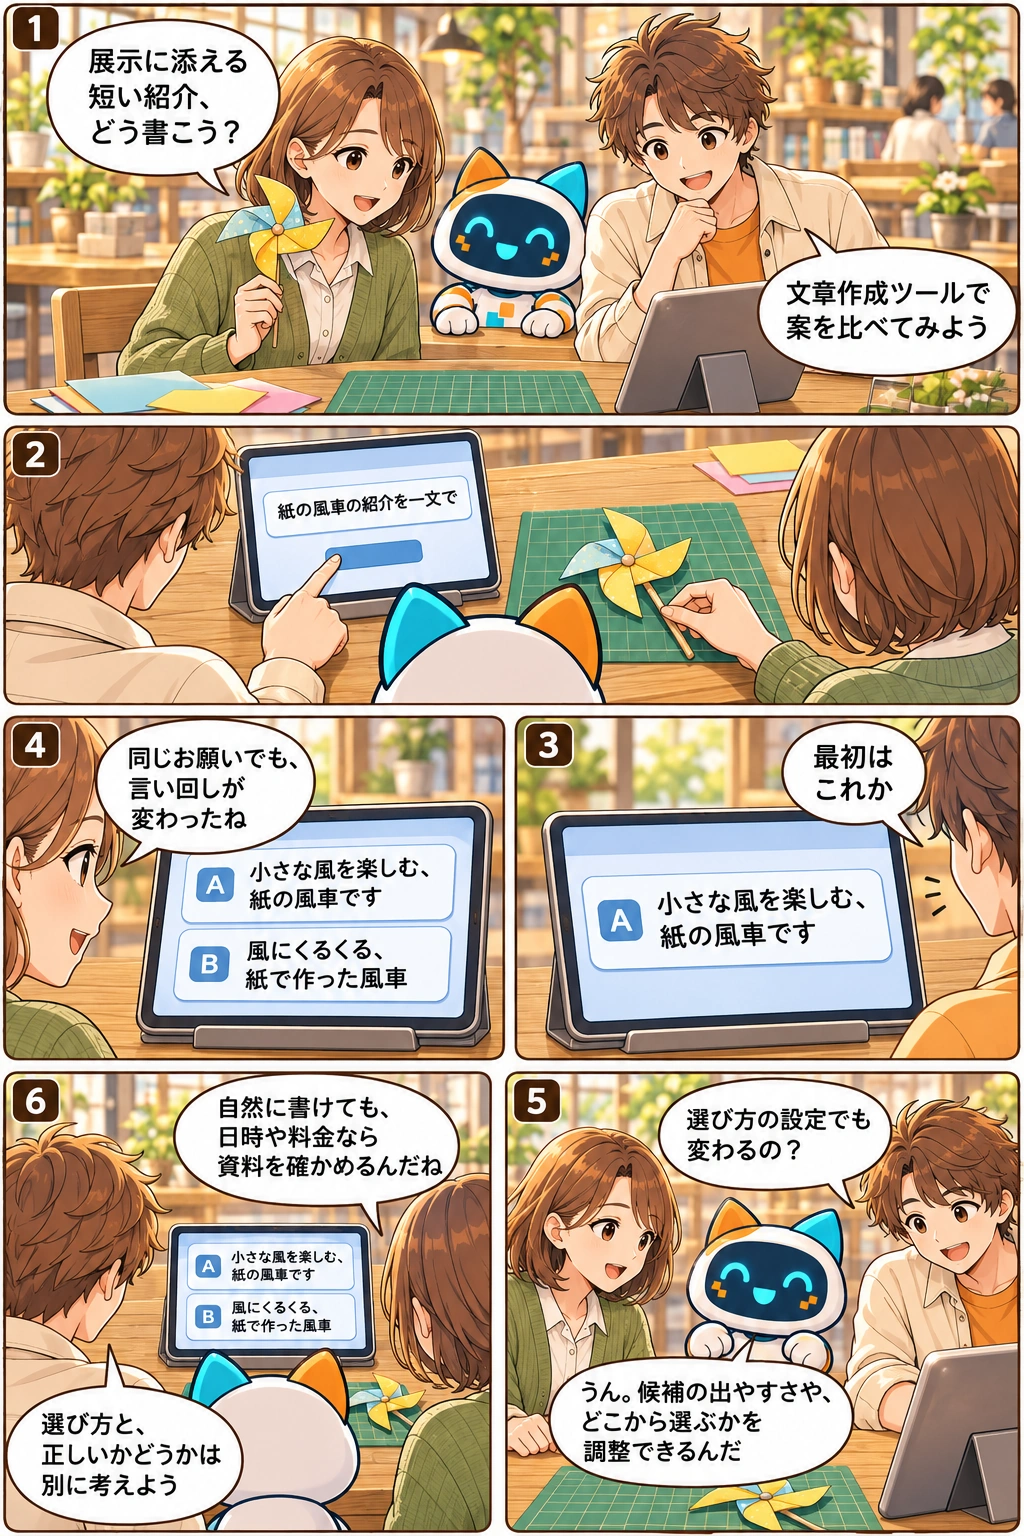
会話を文章で読む
場面:工作室で、ミオが完成した紙風車を持つ。正面ではミオが左、ハルが右。タブレットは机上の固定スタンドにある。
ミオ「展示に添える短い紹介、どう書こう?」 ハル「文章作成ツールで案を比べてみよう」場面:二人の肩越しから、ハルが「紙の風車の紹介を一文で」と入力する。画面上ではハルが左、ミオが右に見え、風車を机へ下ろす手元も見える。
場面:固定画面に案A「小さな風を楽しむ、紙の風車です」が表示され、ハルが読む。
ハル「最初はこれか」場面:同じ画面に案Aを残し、案B「風にくるくる、紙で作った風車」を並べる。ミオが二つを見比べる。
ミオ「同じお願いでも、言い回しが変わったね」場面:正面へ戻り、ハルの問いにビットが答える。風車は机のマット上、タブレットはスタンド上にある。
ハル「選び方の設定でも変わるの?」 ビット「うん。候補の出やすさや、どこから選ぶかを調整できるんだ」場面:再び二人の肩越しに、残った案A/Bを確認する。日時や料金なら根拠資料で確かめると話す。
ミオ「自然に書けても、日時や料金なら資料を確かめるんだね」 ハル「選び方と、正しいかどうかは別に考えよう」
工作室で展示紹介の文案を比べると、同じ依頼でも言い回しが変わりました。候補の出やすさと選択の設定を考える入口ですが、人が言葉を選ぶ行動そのものをAIの確率計算として扱うわけではありません。
次を選び、その結果を加えて、また次を考える
基本的な自己回帰型の言語モデルは、それまでの入力や生成済みの文を手掛かりに、次のトークンの候補ごとに確率を求めます。候補ごとの確率のまとまりが確率分布です。選んだトークンを文へ加え、更新した文に続く次の候補を求める処理を繰り返して文章を生成します。
この確率は「今の文に続いて出やすい候補」の見込みです。例えば、架空の施設への案内で自然な時刻が出たとしても、モデルが公式時刻表を確認した証明にはなりません。出やすさ、読みやすさ、現実の事実との一致は分けて評価します。
根拠:Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗
生成設定は、学習済みの数値を更新することではない
生成パラメータは、利用時に候補の選び方や出力の長さなどを調整する設定です。学習でモデル内部の値を変えるパラメータ更新とは別です。例えば、学習済みモデルを固定したまま生成設定を変えれば、同じ入力でも出力の傾向が変わり得ます。設定を変えたことだけで追加学習をしたとはいいません。
Temperature(温度)は、候補の確率の偏りを調整する代表的な生成設定です。他の条件を同じにして確率から候補を選ぶ場合、一般に低くすると高確率の候補へ寄りやすく、高くすると候補の確率の差が小さくなります。低くしても事実の保証にはなりません。使える値や選択方式はサービスによって異なり、全製品で「0なら常に同じ正答になる」とはしません。
根拠:Generation — Transformers GenerationConfig(別タブで開く) ↗ / Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗ / Machine Learning Glossary(別タブで開く) ↗
Top-pは固定個数ではなく、確率の合計で絞る
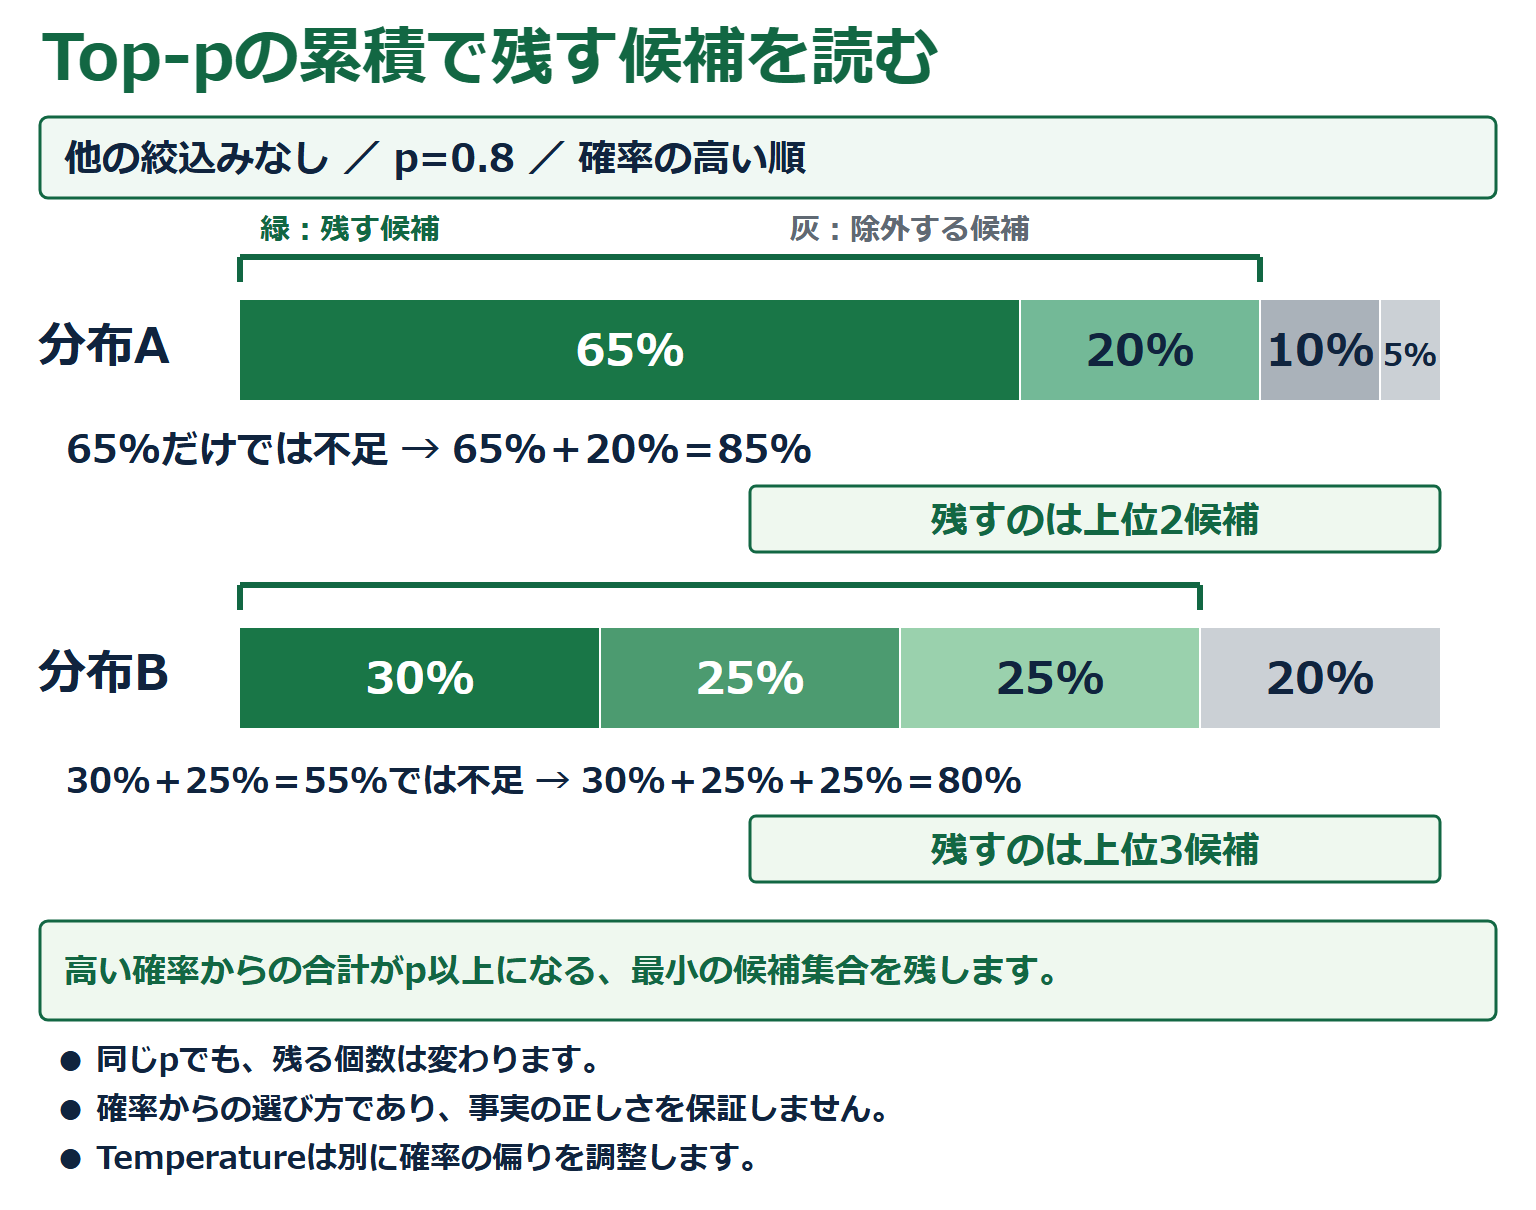
Top-pは、確率の高い候補から順に足し、合計が指定値p以上になる最小の候補集合を残す方法です。その集合の中から候補を選びます。例えば他の絞込みを使わず、確率が55%・25%・15%・5%なら、p=0.75では55%だけで届かず、55%+25%=80%となる上位二つを残します。
同じpでも、確率が一つへ集中しているか分散しているかで残る個数は変わります。「上位p個を残す」設定ではありません。Temperatureは確率の偏り、Top-pは累積確率で候補を絞るという役割の違いで捉えましょう。どちらも候補選びの設定で、根拠資料の正しさを点検する機能ではありません。
根拠:Generation — Transformers GenerationConfig(別タブで開く) ↗ / The Curious Case of Neural Text Degeneration(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗
 図を拡大する ↗
図の内容を文章で確認する
条件:他の絞込みなし、p=0.8、確率の高い順。同じ全幅の確率帯で比較し、緑は残す候補、灰は除外する候補を示します。
- 分布A:65%・20%・10%・5%
- 65%だけでは不足します。65%+20%=85%となる、上位二つを残します。
- 分布B:30%・25%・25%・20%
- 30%+25%=55%では不足します。30%+25%+25%=80%となる、上位三つを残します。
Top-pは、高い確率からの合計がp以上になる最小の候補集合を残します。同じpでも残る個数は変わり、固定個数を選ぶ設定ではありません。
確率からの選び方であり、事実の正しさを保証しません。Temperatureは別に確率の偏りを調整する設定です。
この図は架空の確率分布の比較です。帯の幅は表示の割合へ一致させています。実サービスの既定値・速度・品質を比較したものではありません。
根拠:Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗ / Generation — Transformers GenerationConfig(別タブで開く) ↗ / Machine Learning Glossary(別タブで開く) ↗ / The Curious Case of Neural Text Degeneration(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
3自然に読める回答も、根拠と照らして確かめる
回答に資料名が書かれていたら、その内容は確認済みでしょうか。
- ハルシネーションを事実としての誤りと捉える
- 検索資料と回答の対応、日時や対象を確かめる
引用先もある。でも受付時刻が違う
この話で学ぶこと:引用表示だけで決めず、元の資料の対象と時刻を比べる。
コマは上から下へ、横に並んだコマは右から左へ読みます。
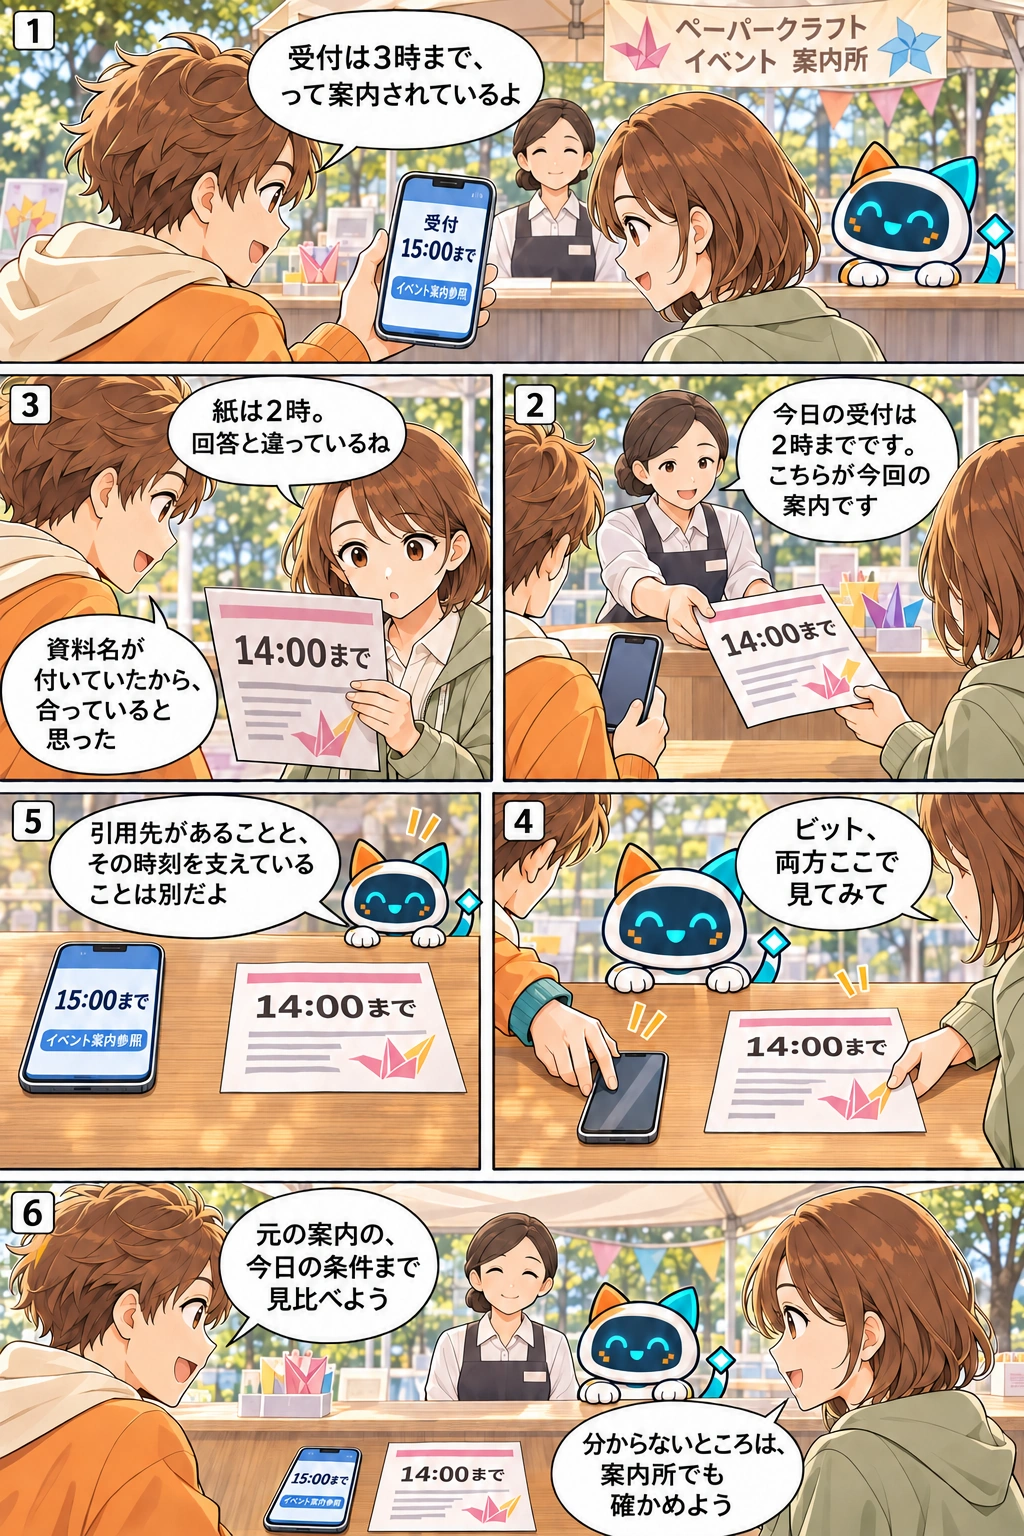
会話を文章で読む
場面:屋外の工作イベント案内所。ハルはスマートフォンの「15:00まで」「イベント案内参照」をミオへ見せる。案内係は台の奥にいる。
ハル「受付は3時まで、って案内されているよ」場面:案内係が「14:00まで」の紙をミオへ渡す。ハルのスマートフォンと、ミオが受け取る紙は別々に見える。
スタッフ「今日の受付は2時までです。こちらが今回の案内です」場面:ミオとハルが紙の14:00を読み、回答の時刻と食い違うことに気づく。
ミオ「紙は2時。回答と違っているね」 ハル「資料名が付いていたから、合っていると思った」場面:二人が紙とスマートフォンを台上へ並べ、ビットへ示す。端末は左、紙は右に置かれる。
ミオ「ビット、両方ここで見てみて」場面:台上の左のスマートフォンは15:00、右の紙は14:00。ビットは台の奥側から両方を見る。
ビット「引用先があることと、その時刻を支えていることは別だよ」場面:元の案内と今日の条件を確かめる。案内係もうなずき、不明な点を案内所で確認することを話す。
ハル「元の案内の、今日の条件まで見比べよう」 ミオ「分からないところは、案内所でも確かめよう」
地域の催しの受付で、AIの案内と配られた紙の時刻が食い違いました。同じ案内を全員で見比べ、資料の実在、対象の日、回答との対応を一つずつ確かめます。AIの内部で何が起きたかを、この場面から断定はしません。
読みやすくても、事実や入力と食い違うことがある
ハルシネーションは、事実や与えた情報と合わない内容を、もっともらしい回答として生成する問題です。存在しない資料を引用したり、入力にない根拠を作ったりする場合もあります。自然な続きを生成する仕組みが、個々の事実を確認する仕組みと同じではないため、言い切った文でも確認が要ります。
例えば、入力の開催案内が「受付は午後2時まで」なのに、回答が「午後3時まで」となれば、案内との不一致です。なぜその誤りが生じたかを回答だけから断定せず、まず食い違う箇所を特定します。一方、「架空の町のお話を作る」と明示した創作で架空の店を登場させることは、現実の店だと偽って案内することとは区別します。
根拠:Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗ / Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗
外部資料を検索して渡しても、適用条件は確認する
RAG(Retrieval-Augmented Generation、検索拡張生成)は、外部の資料を検索し、得た情報を生成時の参照情報として使う方法です。学習後に更新された案内などを参照させる手段になります。資料をその場で渡すことと、その資料でモデルの学習済みパラメータを更新することは別です。検索の具体的な構成は後の教材で扱います。
検索で見つかった資料も、旧版、別会場、別の対象者向けかもしれません。発行元、更新日、適用される日時・対象を確認し、現在の質問に合う資料かを判断します。資料を渡しただけで誤りが必ずなくなるわけではなく、回答が資料を正しく使ったかも別に確認します。
根拠:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(別タブで開く) ↗ / Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗
引用先があることと、その主張を支えることは違う
根拠確認は、①参照先が実在するか、②発行元や版が質問に合うか、③回答の日時・数量・条件がその箇所に書かれているか、を分けて行います。資料名やURLが付いただけでは、回答の全てを支えたことになりません。引用先の本文と、回答が主張する内容を一つずつ対応させます。
架空の講習案内では、5月10日発行の旧版は「全日9時受付」、5月17日発行の改訂版は「6月の土曜日は10時受付」とします。6月土曜日の質問なら、その日を対象にした改訂版の条件を読みます。単に新しい日付だから他の対象へも使えるとはせず、例外を含む適用範囲まで確かめ、確認できない情報は断定を保留します。
根拠:Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗ / Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(別タブで開く) ↗
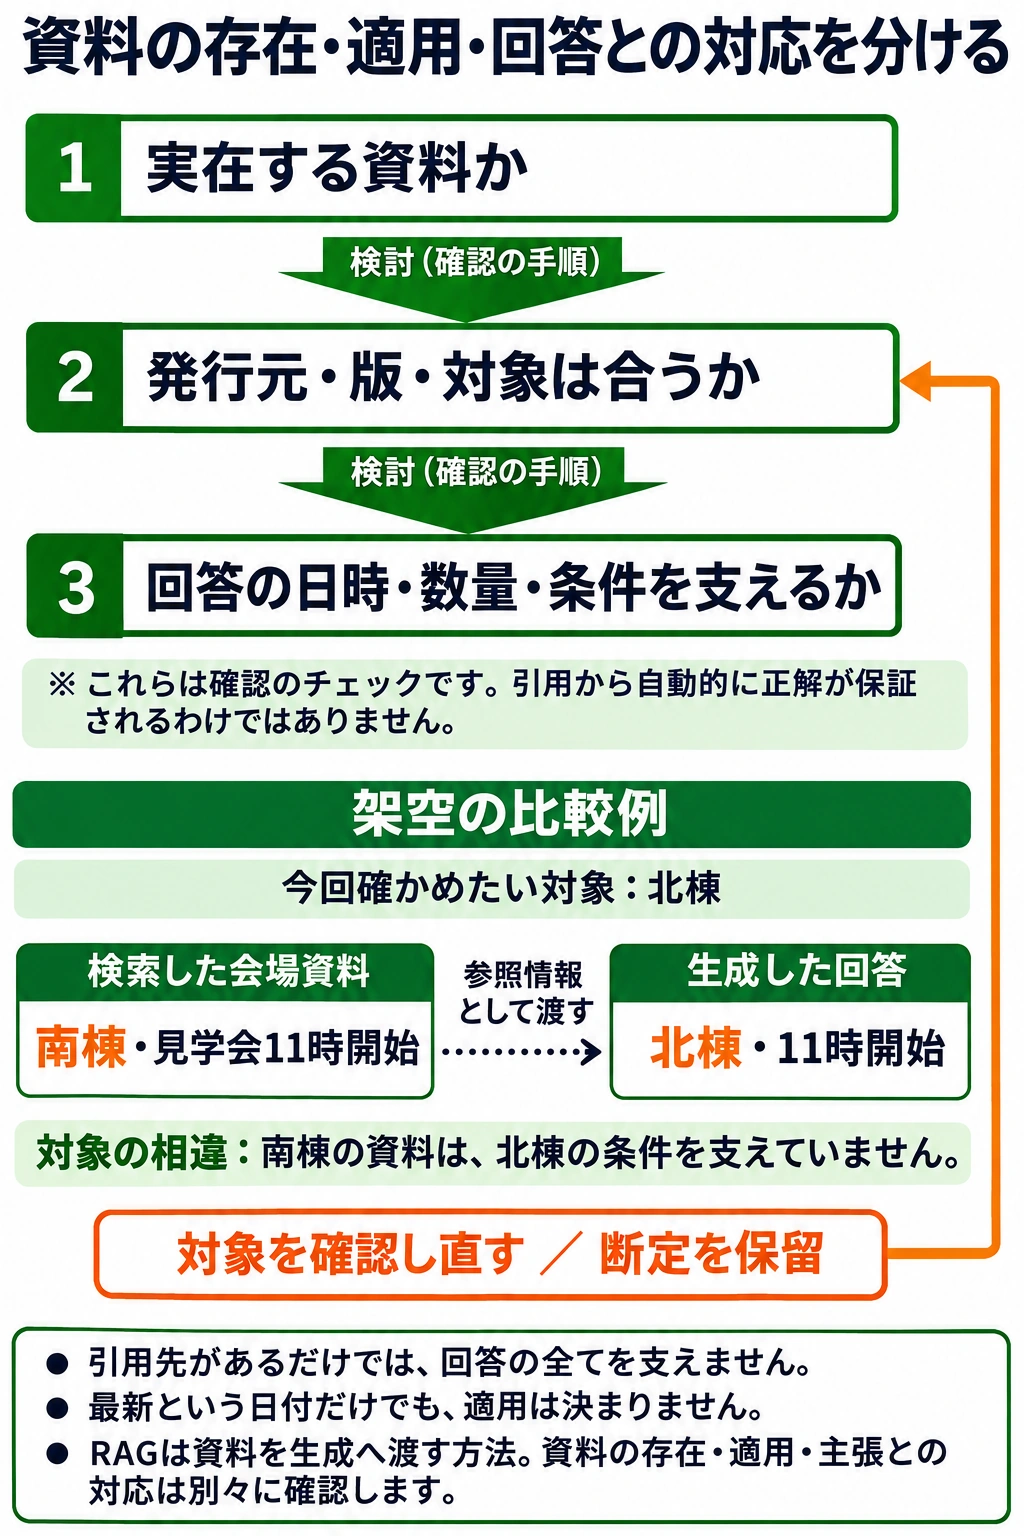 図を拡大する ↗
図の内容を文章で確認する
- 実在する資料かを確認します。
- 発行元・版・対象は合うかを確認します。
- 回答の日時・数量・条件を支えるかを確認します。
これらは確認のチェックです。引用から自動的に正解が保証されるわけではありません。
架空の比較例で、今回確かめたい対象は北棟です。検索した資料は「南棟・見学会11時開始」、生成した回答は「北棟・11時開始」となっています。点線は資料を参照情報として渡す関係です。南棟の資料は、北棟の条件を支えていません。対象を確認し直し、確認できない断定は保留します。
RAGは検索資料を生成へ渡す方法ですが、資料の存在・質問への適用・回答の主張との対応は別々に確認します。引用先があるだけでは回答の全てを支えず、最新という日付だけでも適用は決まりません。
実在施設の時刻ではなく学習用の架空例です。点線は参照情報、確認手順の矢印は検討の順序であり、正確さの保証ではありません。
根拠:Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗ / Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(別タブで開く) ↗ / Large language models / Transformers — Machine Learning Crash Course(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
4扱える文脈量と、大切な条件の残し方を考える
長い相談なら、これまでの文章を全て足せば安心でしょうか。
- 文脈の上限とモデルの学習済み知識を分ける
- 明示された入出力予算を計算し、必要な条件を残す
短くしたら、予約の例外まで消えた
この話で学ぶこと:短い要約にも、元の大切な例外条件を残す。
コマは上から下へ、横に並んだコマは右から左へ読みます。
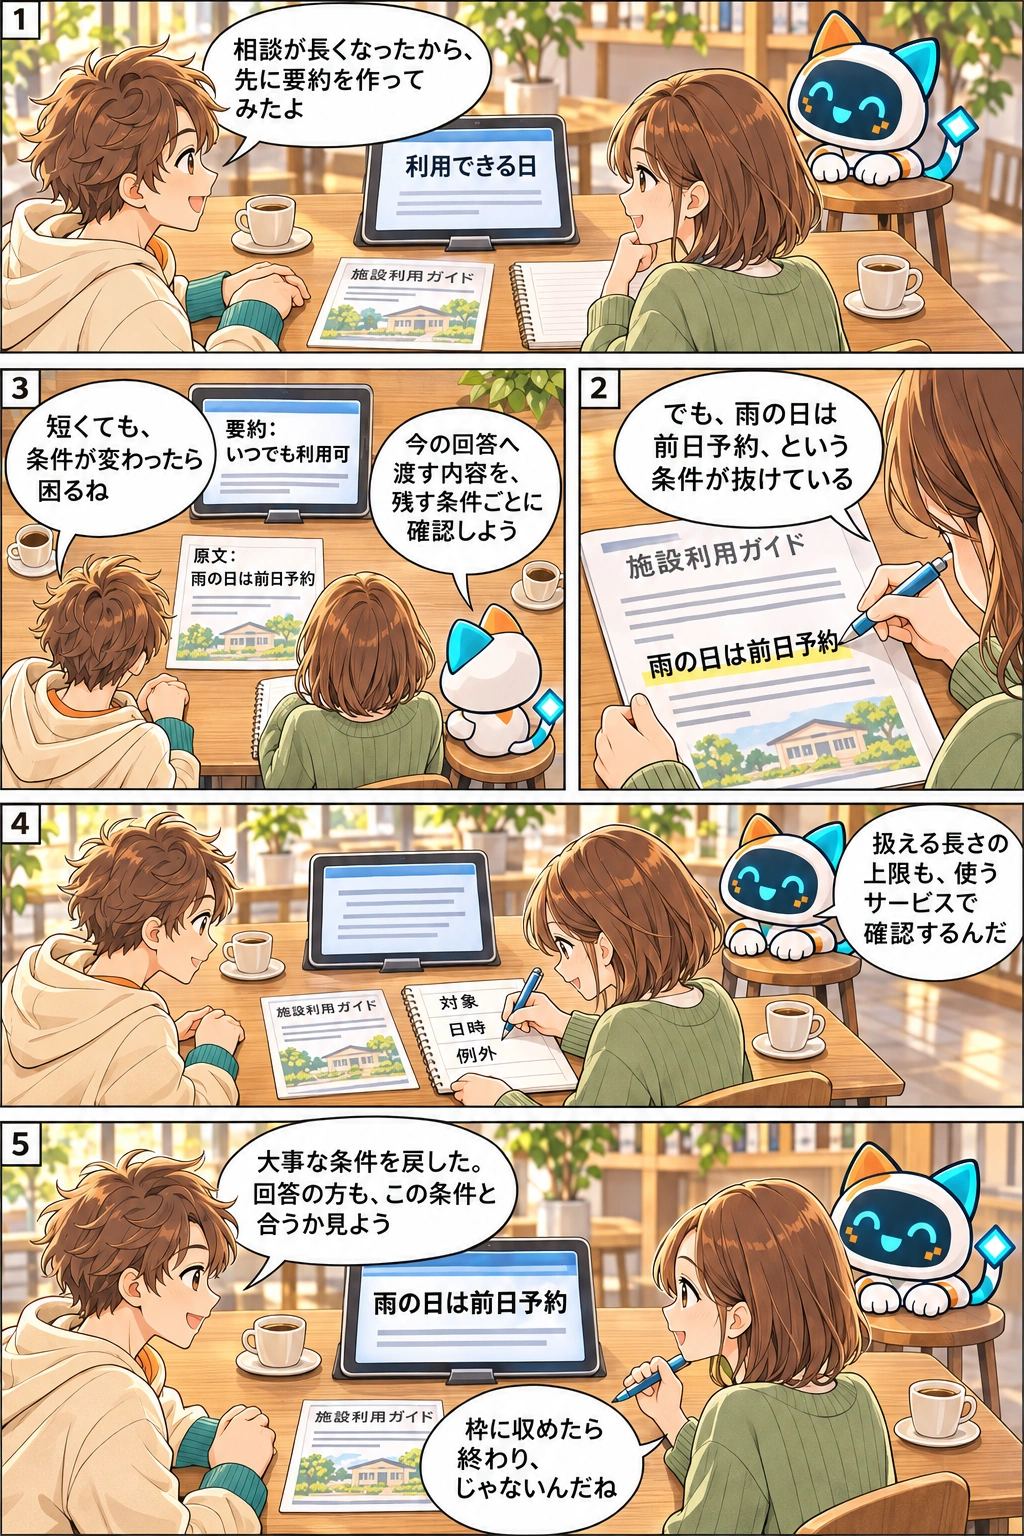
会話を文章で読む
場面:室内のテーブルで外出計画を整理する。ハルは左、ミオは右。タブレットは固定スタンドにあり、施設利用ガイドとノートが机上に並ぶ。
ハル「相談が長くなったから、先に要約を作ってみたよ」場面:ミオが右手のペンで原文の「雨の日は前日予約」を示す。紙は左手で支えている。
ミオ「でも、雨の日は前日予約、という条件が抜けている」場面:俯瞰で、画面の「要約:いつでも利用可」と紙の「原文:雨の日は前日予約」を同時に比べる。ビットも表示側を向く。
ハル「短くても、条件が変わったら困るね」 ビット「今の回答へ渡す内容を、残す条件ごとに確認しよう」場面:ミオが右手のペンでノートへ「対象・日時・例外」を記す。左手はノートの端にあり、原文の紙が隣に置かれている。
ビット「扱える長さの上限も、使うサービスで確認するんだ」場面:修正した画面の「雨の日は前日予約」と原文を照合する。短く収めるだけでなく、回答が条件に合うかも確かめる。
ハル「大事な条件を戻した。回答の方も、この条件と合うか見よう」 ミオ「枠に収めたら終わり、じゃないんだね」
自宅で外出計画を整理すると、短い要約から「雨の日は前日予約」という条件が抜けていました。人の記憶をAIと同一視せず、今の処理へ渡す資料の範囲と、要約で残す条件を分けて考える入口です。
一回の処理に渡す文脈には範囲がある
コンテキストは、今の回答を作るためにモデルへ与える文脈です。指示、今回の質問、渡された会話履歴や参照資料などを含みます。コンテキストウィンドウは一度に扱える文脈量の範囲を表し、トークン数などで示されます。学習によって獲得したモデル内部の数値そのものの容量とは違います。
画面に昔の会話が残っていても、それを毎回全てモデルへ渡すとは限りません。サービスが履歴を削ったり要約したりする場合もあります。入力と生成出力をどの上限で扱うか、長さを超えたときの処理はサービスごとに確認します。この教材では、計算するときに使う上限と数え方を明示します。
根拠:Context windows(別タブで開く) ↗ / Machine Learning Glossary(別タブで開く) ↗ / Generation — Transformers GenerationConfig(別タブで開く) ↗
入出力を共有するという条件で、残る枠を計算する
架空の自己回帰型モデルで、入力と生成出力の合計上限が8,000トークンだとします。必要な指示や履歴等を含む入力が5,100、出力用に1,500を確保するなら、追加できる入力は8,000
この計算は、入出力を同じ予算で数えると明示した架空の条件です。別々の上限や製品固有の内部処理を持つ場合へ、そのまま当てはめません。また上限内であることは、計算上収まるという意味です。文章の途中にある大事な条件まで、モデルが必ず正しく利用することの保証ではありません。
根拠:Context windows(別タブで開く) ↗ / Generation — Transformers GenerationConfig(別タブで開く) ↗ / Lost in the Middle: How Language Models Use Long Contexts(別タブで開く) ↗
短くするなら、誰の・いつの・どの例外かを残す
長い文脈を整理するときは、今の依頼、変更後の条件、対象者、日時、例外、参照資料の出所を先に分けます。要約を使う場合は、残すべき条件が落ちていないか原文と照合します。「全日利用可。ただし祝日は予約制」の後半を消すと、短くなっても別の条件へ変わってしまいます。
重要な指示を分かりやすい位置へまとめ、不要な重複を減らすことは、確認しやすくする工夫です。ただし、位置を変えれば必ず誤りがなくなるとはしません。長い入力で情報の位置が成績へ影響した研究もありますが、特定のモデル・課題の観測であり、全モデルに同じ結果を約束するものではありません。必要な条件と回答を最後まで照合します。
根拠:Context windows(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗ / Lost in the Middle: How Language Models Use Long Contexts(別タブで開く) ↗
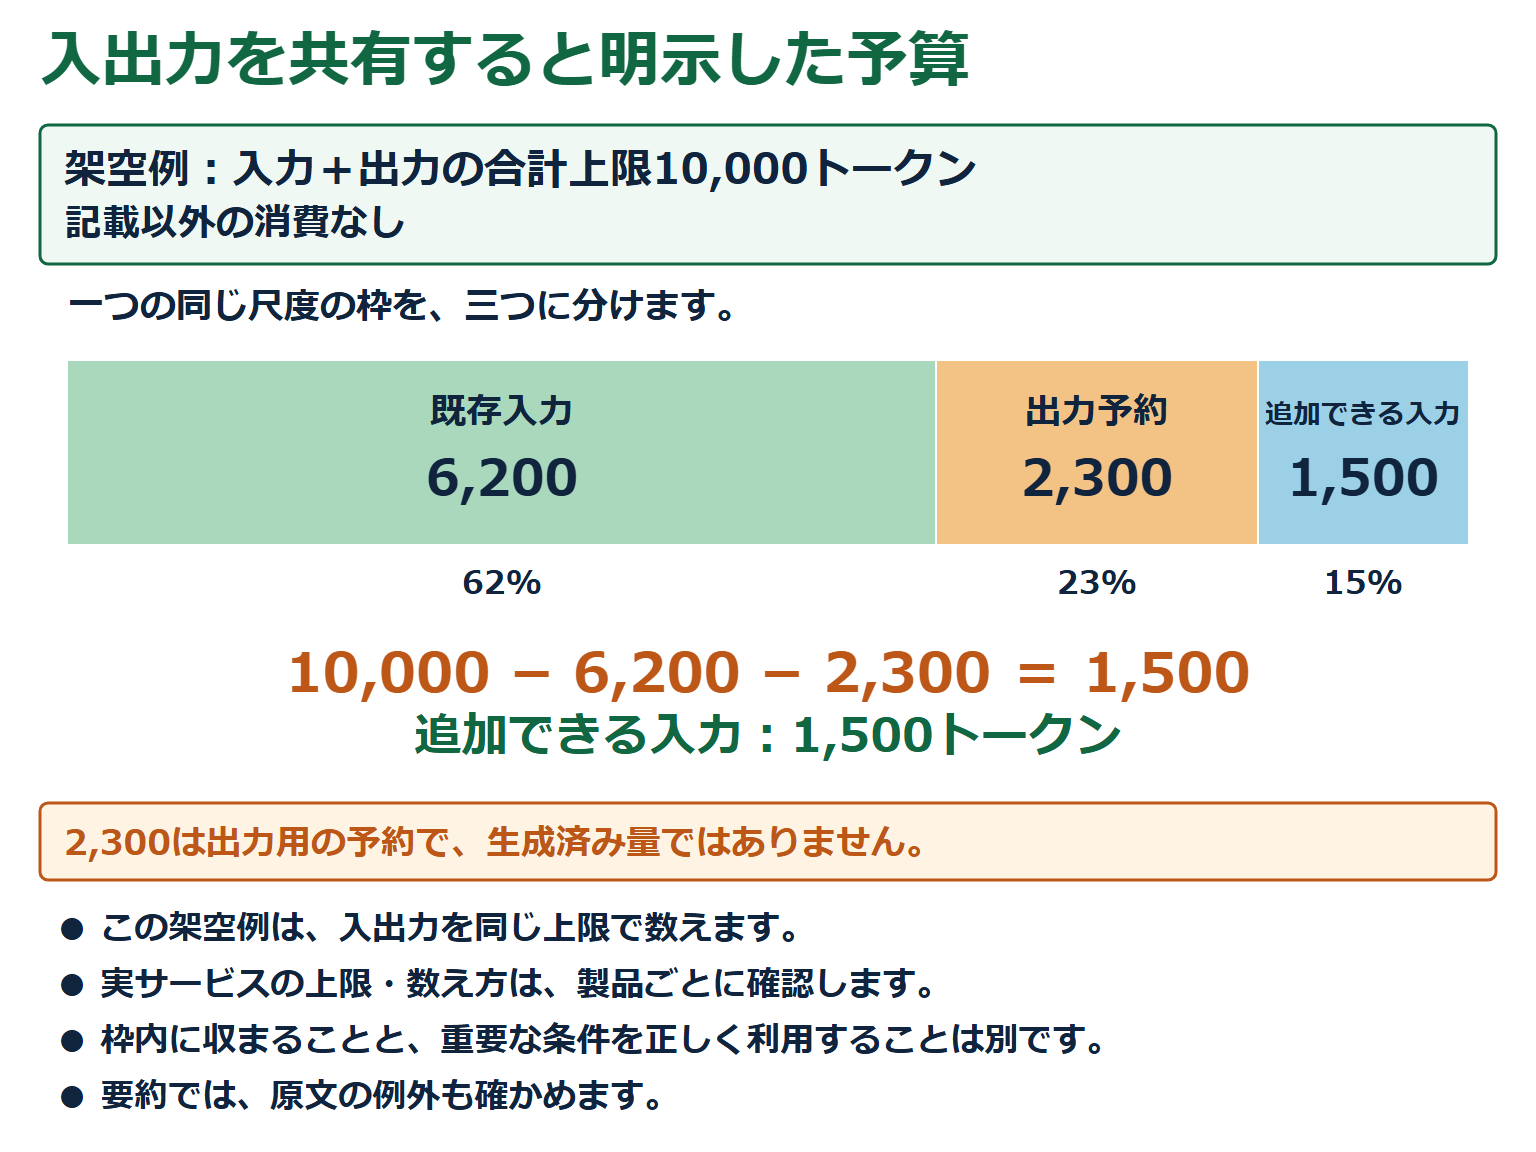 図を拡大する ↗
図の内容を文章で確認する
架空例:入力と生成出力の合計上限10,000トークン。記載以外の消費はありません。この例では入出力を同じ上限で数えます。
- 既存入力:6,200トークン(62%)
- 既に入力へ含める量です。
- 出力予約:2,300トークン(23%)
- 出力のために確保する量で、生成済みの量ではありません。
- 追加できる入力:1,500トークン(15%)
- 10,000
−6,200 −2,300 =1,500トークンです。
一つの同じ尺度の帯を、62%・23%・15%に分けています。全サービスへこの数え方を一般化せず、製品の上限・数え方を確認します。
枠内に収まることと、重要な条件を正しく利用することは別です。要約では原文の例外も確かめます。
入出力共有と明示した架空の予算です。製品固有の内部処理・別々の上限へ、そのまま適用しません。
根拠:Context windows(別タブで開く) ↗ / Generation — Transformers GenerationConfig(別タブで開く) ↗ / Machine Learning Glossary(別タブで開く) ↗ / Lost in the Middle: How Language Models Use Long Contexts(別タブで開く) ↗ / Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile — NIST AI 600-1(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。