複数形式・基盤
多様で大量の文章・画像などを学習し、複数の用途へ利用する土台となる架空モデルです。
同じ画面で使えても、モデルの構造、学習の目的、生成する手順、扱う情報形式は同じ意味ではありません。自己注意、エンコーダ/デコーダ、拡散、基盤/マルチモーダルという四つの視点で、何をしているかを分けて読みます。
2027年2月試験から適用のシラバスを対象にしています。行列の計算や最新製品の仕様暗記ではなく、部品の役割と条件の読み分けを学びます。
前に確認する:CNN・RNNからVAE・GANまで / AIの歩みと技術名の軸
回答はこのページを開いている間だけ保持します。別ページへの移動や再読み込みで消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
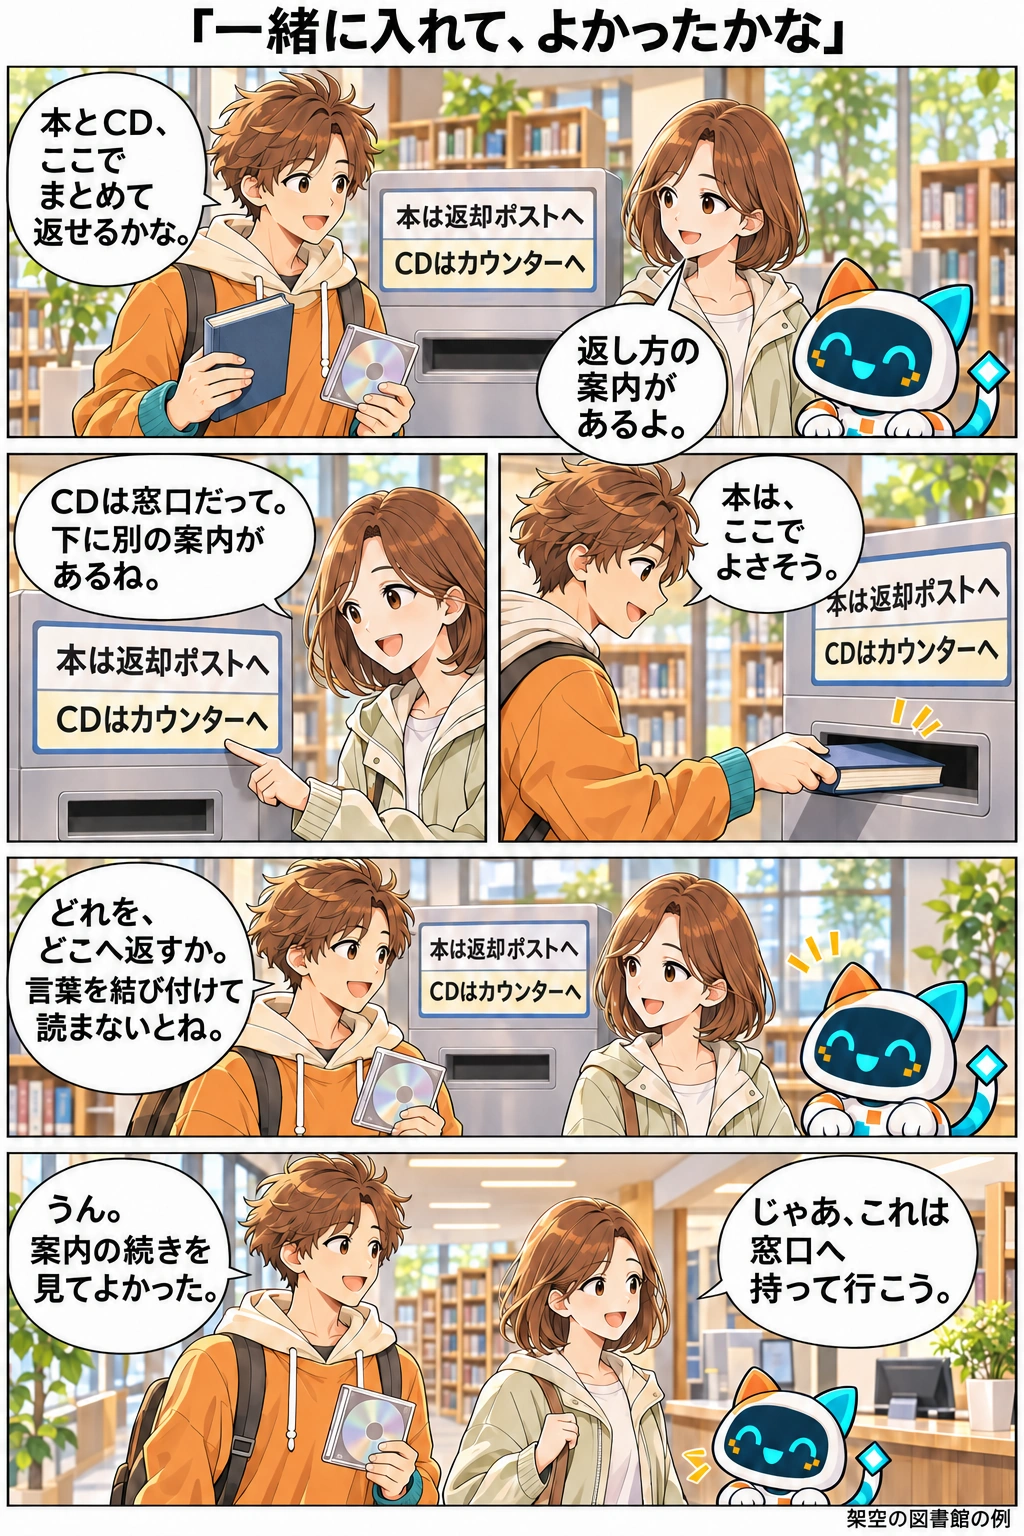
見るポイント 本とCDの返し方が別の場所に書かれています。何をどこへ返すか、案内を読み比べてみましょう。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:横長の引き。建物の返却口と二人、ハルが本とCDを取り出す。
ハル「本とCD、ここでまとめて返せるかな。」 ミオ「返し方の案内があるよ。」場面:右の寄りコマ。ハルが掲示の上部「本は返却ポストへ」を読み、本を口へ近づける。
ハル「本は、ここでよさそう。」場面:同段左の掲示寄り。ミオが下部「CDはカウンターへ」を指す。
ミオ「CDは窓口だって。下に別の案内があるね。」場面:全幅の手元。本を返した後、ハルは左手のCDケースを残す。
ハル「どれを、どこへ返すか。言葉を結び付けて読まないとね。」場面:下の全幅。二人がCDを持って館内カウンターへ向かう。
ミオ「じゃあ、これは窓口へ持って行こう。」 ハル「うん。案内の続きを見てよかった。」人が掲示を読み分けた場面であって、自己注意の内部計算そのものではありません。本文では、同じ並びの数値表現どうしの関係を計算する仕組みへ進みます。
自然言語処理は、日本語や英語など、人が使う言葉をコンピューターで解析したり生成したりする分野です。文を扱うときは、処理する単位へ分け、各単位を数値のまとまりで表します。この単位をトークン、数値のまとまりをベクトルと呼びます。トークンは必ず一単語と一致するわけではありません。詳しい分け方は後の教材で扱い、ここでは複数の位置に数値表現があると考えます。
Self-Attention(自己注意機構)は、同じ並びにある別の位置の情報を参照し、その関係を取り込んだ表現を作る仕組みです。例えば『青い箱を倉庫へ移した。赤い袋は受付に残した。箱は翌朝に発送する』という架空の文では、最後の『箱』を読むとき、離れた前の記述も関係します。自己注意は内部の数値を組み合わせる処理で、人が意味を自覚して読み返す行動そのものではありません。
根拠:Raffel et al.: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer(別タブで開く) ↗ / Vaswani et al.: Attention Is All You Need(別タブで開く) ↗
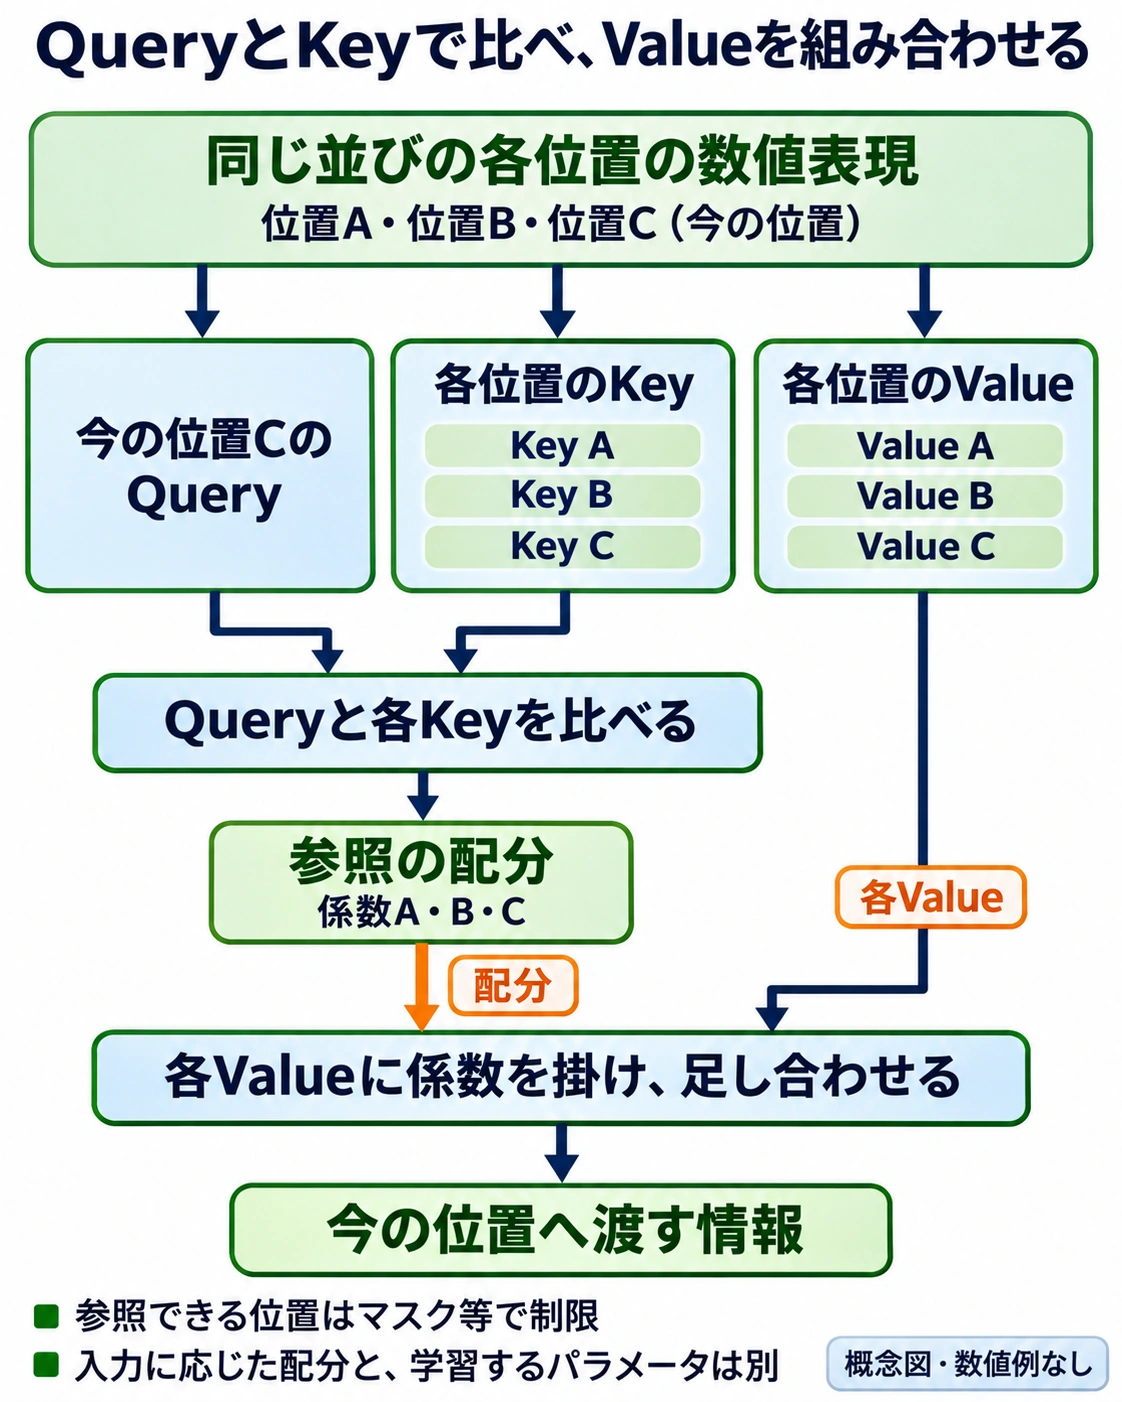
基本的な自己注意では、各位置の表現からQuery(クエリ)、Key(キー)、Value(バリュー)という三種類のベクトルを計算します。Queryは今の位置からの参照を求める側、Keyは参照候補との対応を比べる側、Valueは実際に組み合わせて受け取る情報です。同じ並びの表現から作りますが、役割が違います。Queryは利用者が書いた質問文そのもの、Keyは辞書の見出し文字、Valueは完成した回答文、という対応ではありません。
Queryと各Keyを数値として比べ、各Valueをどの程度組み合わせるかという係数を求めます。係数を掛けたValueを足し合わせて、今の位置へ渡す情報を作ります。複数の位置の情報を混ぜられるため、最大の係数の語を一つ選んでコピーするだけの処理ではありません。参照の係数は今の入力に応じて計算される値であり、係数が変わっただけで学習済みパラメータを更新したことにもなりません。
 図を拡大する ↗
参照できる位置はマスク等で制限します。入力に応じた配分の計算と、学習済みパラメータの更新は別です。この図には実モデルの係数や性能の実測値はありません。
基本的な自己注意の概念図です。利用者の質問文をQueryそのものとする比喩ではありません。
根拠:Vaswani et al.: Attention Is All You Need(別タブで開く) ↗
Transformerは、自己注意などを組み合わせたニューラルネットワークの構造です。離れた位置どうしの関係を必要とすることを長距離依存と呼びます。自己注意は、RNNの状態を隣へ順に渡す経路だけに頼らず、参照が許された離れた位置を結び付けられます。ただし、それだけで長い文の条件を必ず正しく使えるとはいえません。Transformerでは語順を区別する位置情報も加えます。また、見てよい位置を制限する仕組みをマスクと呼びます。
並列処理は、複数の計算を同時に進めることです。学習用の並びが与えられていれば、Transformerは複数位置の表現をまとめて計算できます。自己回帰型の文章生成では、既にある入力と生成済みの部分から次の単位を決め、それを次の予測へ使うので、まだ決めていない後の単位を答えとして参照しません。学習時も、未来の正解を見て予測しないようマスクを使います。並列化できる部分があることと、一度に完成文全てを決められることを分けましょう。
計算量は、必要となる計算の多さを表す考え方です。実際の待ち時間は、並びの長さ、機器、実装などにも左右されます。『並列だから、どんな長文でも必ず速く正確』とは判断しません。例えば荷物の説明から発送条件を取り出す課題なら、長い別の説明文でも条件を取り違えないかを確かめます。
根拠:Vaswani et al.: Attention Is All You Need(別タブで開く) ↗ / Raffel et al.: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
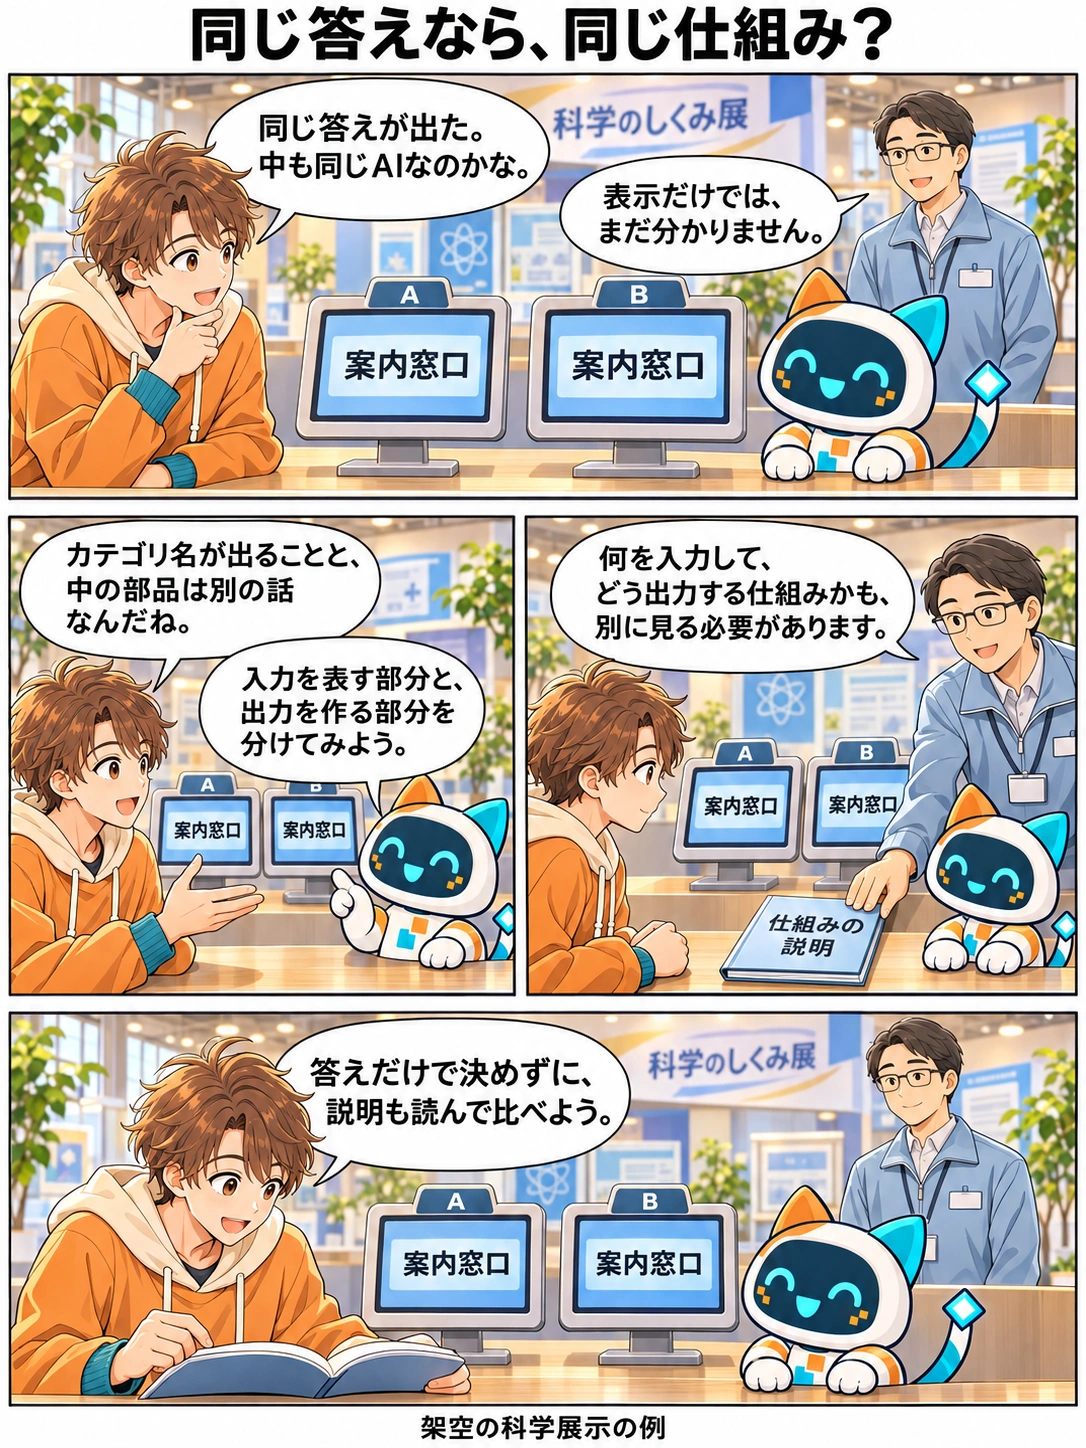
この話で学ぶこと:画面に出た文字と、内部の構成を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:上の大きいコマ。二つの端末に同じ「案内窓口」の結果。
ハル「同じ答えが出た。中も同じAIなのかな。」 案内係「表示だけでは、まだ分かりません。」場面:右コマ、ハル側の斜め寄り。案内係が説明カードを置く。
案内係「何を入力して、どう出力する仕組みかも、別に見る必要があります。」場面:同段左、ハルとビットの目線。
ハル「カテゴリ名が出ることと、中の部品は別の話なんだね。」 ビット「入力を表す部分と、出力を作る部分を分けてみよう。」場面:下の全幅。ハルがカードの表紙を開き、次の展示説明へ。
ハル「答えだけで決めずに、説明も読んで比べよう。」同じ表示から構造を推測し過ぎないための架空展示です。本文のBERT/T5等の歴史例を、その展示の実装だとは示していません。
エンコーダは入力を内部の表現へ写す部分、デコーダはその情報などを使って出力を作る部分です。2017年のTransformer論文の翻訳モデルは、入力文を扱うエンコーダと、出力文を順に作るデコーダを組み合わせました。出力側は、エンコーダから渡る情報と、既に作った出力を利用します。
例えば『提出は金曜までです』という架空の案内を別の言語へ訳すなら、入力を表す部分と、訳文の続きを作る部分を分けられます。二つの役割があることから、必ず別会社の製品や、別々に操作する二つのアプリだとはいえません。VAEでもエンコーダ/デコーダという名前を使いましたが、同じ役割名であることと、内部の計算構造が同一であることは別です。
根拠:Vaswani et al.: Attention Is All You Need(別タブで開く) ↗ / Raffel et al.: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer(別タブで開く) ↗ / Rombach et al.: High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗
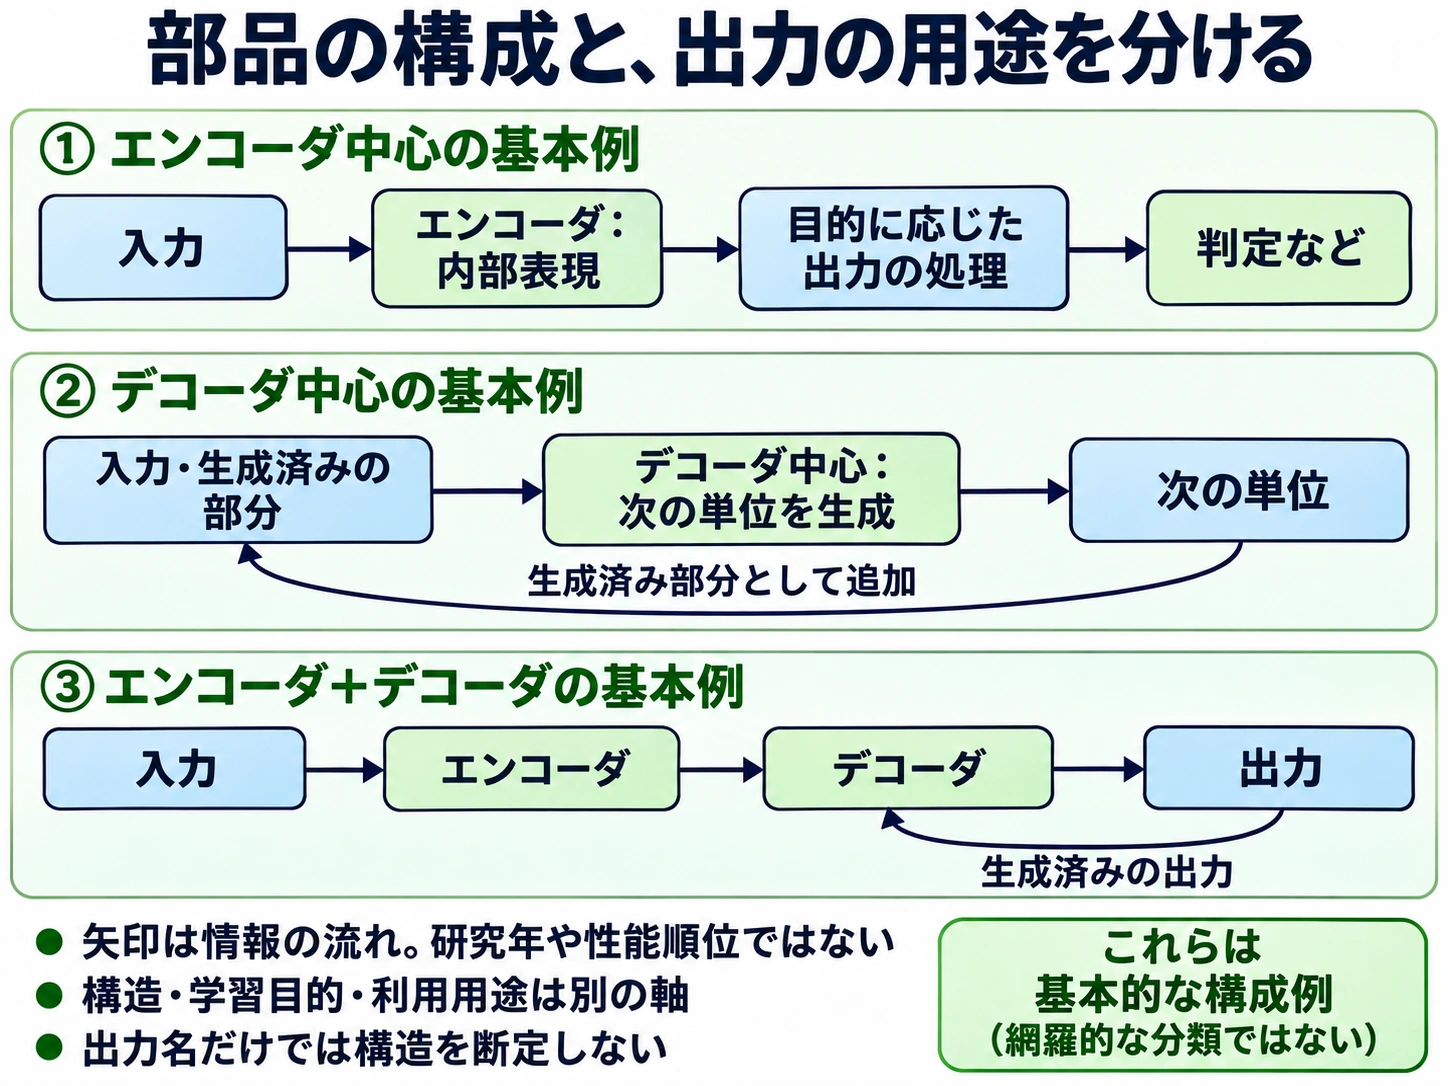
Transformerの発展には、エンコーダを中心に入力の表現を作る構成、デコーダを中心に続きを生成する構成、エンコーダとデコーダを組み合わせる構成があります。エンコーダを使う歴史例のBERTは、入力の左右の文脈を使った表現を学び、分類などの課題へ調整して利用します。入力の表現を作る部分と、目的に応じた判定を出す部分を区別します。
基本的な自己回帰のデコーダ中心モデルは、与えられた文と生成済みの部分を使い、次の単位を順に生成します。一方、T5は、入力も出力も文章の形で扱うエンコーダ/デコーダ型の歴史例です。翻訳や要約だけでなく、分類先のラベルを文章として出すようにも設計できます。どの構成でも同じ目的しか扱えない、とは決めません。
根拠:Devlin et al.: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(別タブで開く) ↗ / Raffel et al.: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer(別タブで開く) ↗
 図を拡大する ↗
矢印は情報の流れで、研究年の順や性能順位ではありません。構造・学習目的・利用用途は別の軸です。例えばカテゴリ名を文章として生成する設計もあり、出力名だけでは内部の構造を断定しません。三つは基本例で、全てのモデルを網羅する分類ではありません。
役割名が同じでも、VAEの部品とTransformerの部品の内部構造が同一とは限りません。
根拠:Vaswani et al.: Attention Is All You Need(別タブで開く) ↗ / Raffel et al.: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer(別タブで開く) ↗ / Devlin et al.: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(別タブで開く) ↗
モデルの構造は、どの部品をどう組んだかという軸です。学習の目的は、何を予測できるようパラメータを調整したかという軸です。使い道は、利用時に何を入力し、どんな結果が欲しいかという軸です。例えば窓口への問い合わせ先を選ぶという同じ使い道でも、分類用の出力を付けたモデルと、部署名を文章として生成するモデルが考えられます。
返ってきた結果が『会計担当』というカテゴリ名だけでも、その画面からエンコーダ型かデコーダ型かを断定できません。構造は仕様を、適切な利用かは評価結果と条件を確かめます。新しいモデルが登場した順番だけで、古い構成の用途が全てなくなったと考える必要もありません。
根拠:Raffel et al.: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer(別タブで開く) ↗ / Devlin et al.: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
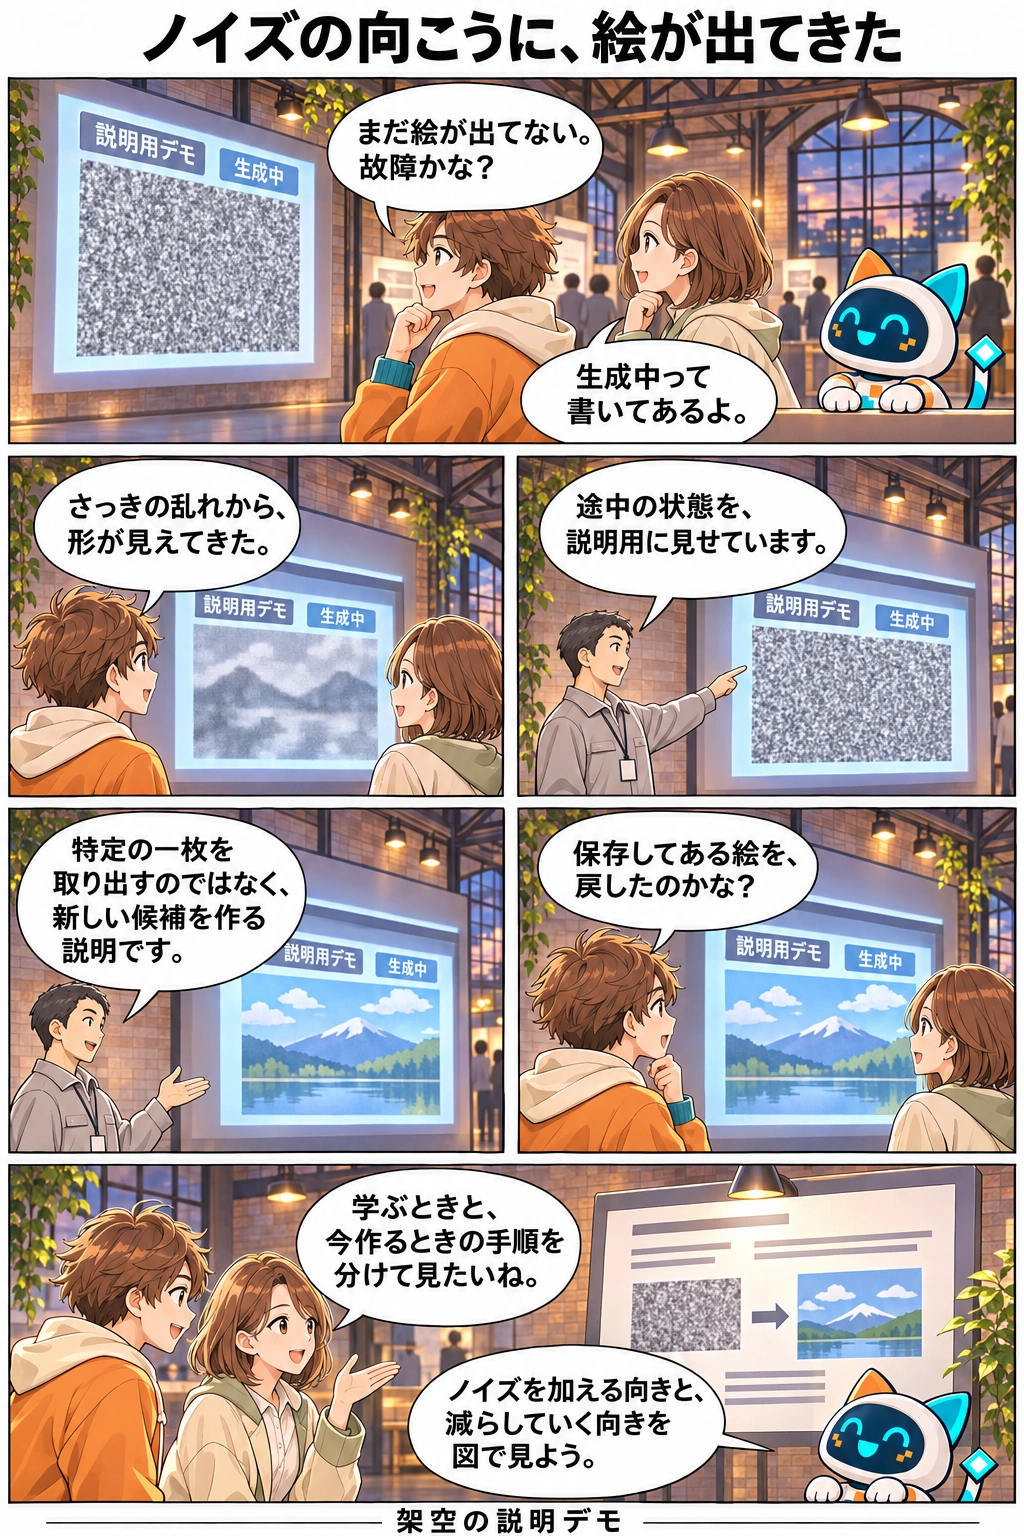
この話で学ぶこと:生成途中の状態と、保存済みの絵を取り出すことを分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:上の引き。作品展の入口、壁に「説明用デモ」「生成中」とノイズの模式画面。
ハル「まだ絵が出てない。故障かな?」 ミオ「生成中って書いてあるよ。」場面:右コマ。スタッフが壁を示す。
スタッフ「途中の状態を、説明用に見せています。」場面:同段左。壁に淡い形が現れ、二人が同じ方向を見る。
ハル「さっきの乱れから、形が見えてきた。」場面:次段右。新しい架空の風景候補。
ハル「保存してある絵を、戻したのかな?」場面:同段左。スタッフの返答。
スタッフ「特定の一枚を取り出すのではなく、新しい候補を作る説明です。」場面:下の横長。作品脇の説明へ向かう三人。
ミオ「学ぶときと、今作るときの手順を分けて見たいね。」 ビット「ノイズを加える向きと、減らしていく向きを図で見よう。」投影は架空の説明デモです。壁の見た目だけから方式を特定せず、本文で基本的なDDPMと潜在拡散の工程を分けます。途中の画像が実モデルの実験結果だとも扱いません。
ノイズは、ここでは数値に加えるランダムな乱れです。基本的な画像用の拡散モデル(Diffusion Model)を考えます。学習用画像へ段階に応じたノイズを加え、画像の情報をだんだん分かりにくくする方向が拡散過程です。撮影時に偶然生じた汚れを探す処理とは区別します。
学習では、ノイズを加えた状態とその段階などを手掛かりに、ノイズを減らす方向の処理をモデルが学びます。例えば、拡散モデルの基本方式の一つであるDDPM(Denoising Diffusion Probabilistic Model:ノイズ除去拡散確率モデル)では、加えたノイズを予測するようにパラメータを調整する方法があります。全ての段階の画像を必ず順番に一枚ずつ見せて学ぶ、という意味ではありません。学習方法には実装ごとの違いがあります。
根拠:Ho, Jain, Abbeel: Denoising Diffusion Probabilistic Models(別タブで開く) ↗
生成するときは、基本例では新しく用意したランダムなノイズから出発し、学習済みモデルを使って段階的に画像の状態を更新します。ノイズを減らして画像を作る方向が逆拡散過程です。学習で使った特定の一枚を、その元の画素どおり必ず復元する処理ではありません。新しい候補を作ることと、保存済みの元画像を読み出すことを分けます。
文章を条件として与える画像生成では、その条件に対応する画像を作るよう処理を導く構成もあります。条件があることは、文字で指定した事実が現実に存在する保証ではありません。生成中の更新を繰り返すことと、そのたびにモデルのパラメータを学習し直すことも別です。
根拠:Ho, Jain, Abbeel: Denoising Diffusion Probabilistic Models(別タブで開く) ↗ / Rombach et al.: High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗
 図を拡大する ↗
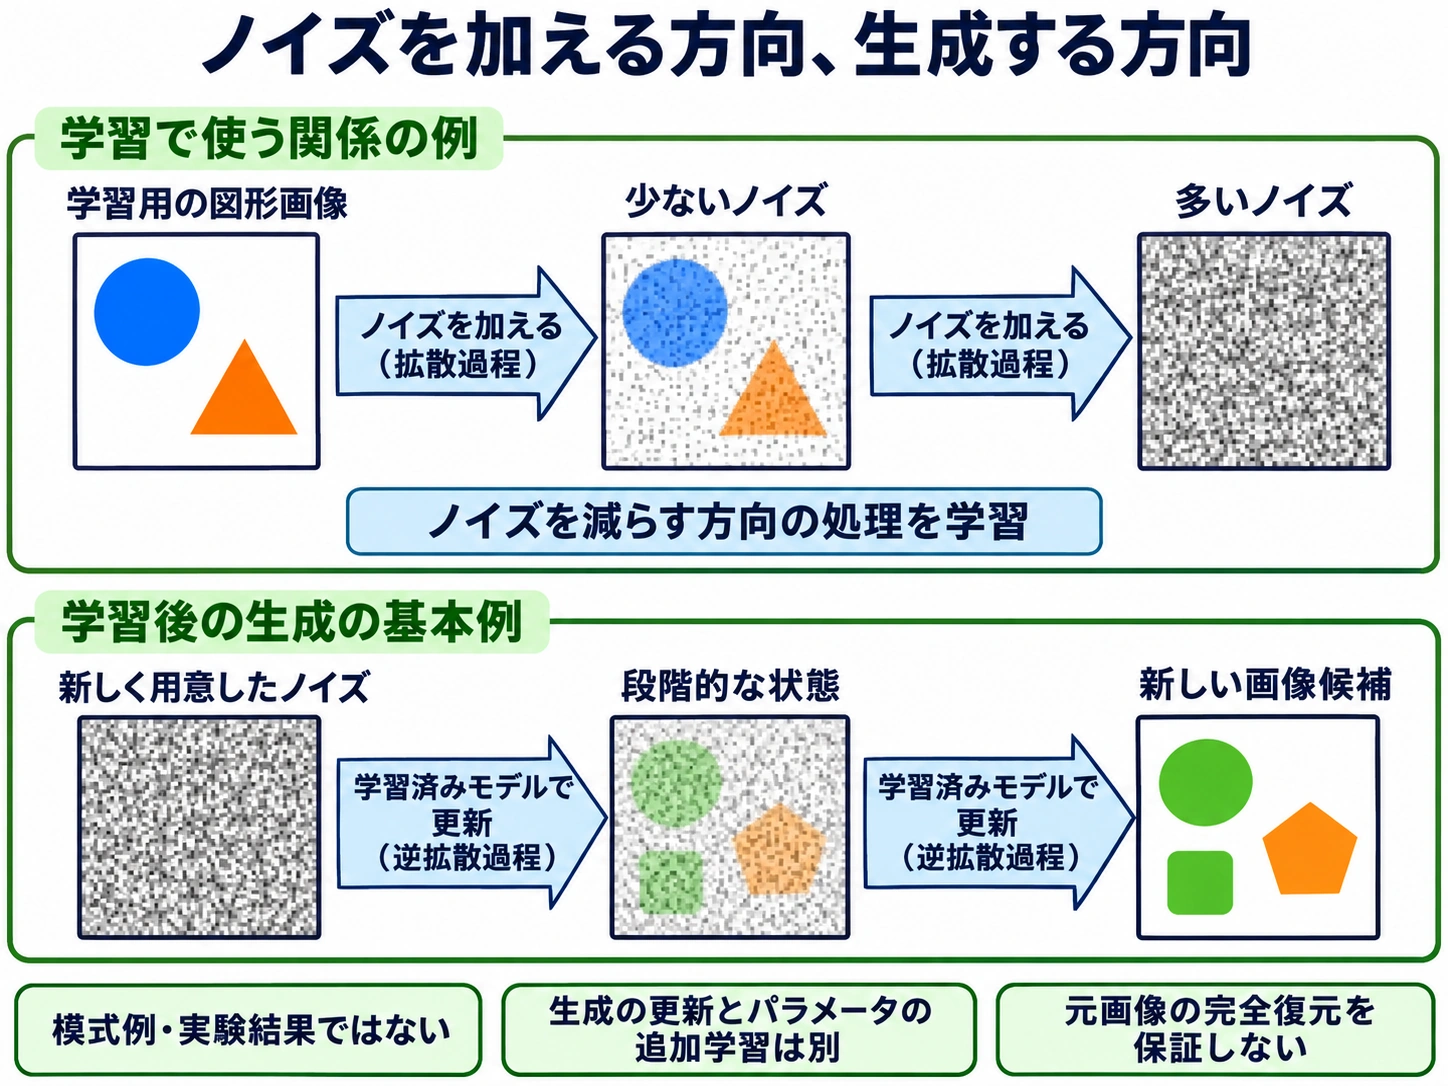
学習で使う関係の例:学習用の図形画像へ段階に応じてノイズを加える方向が拡散過程です。モデルはノイズを減らす方向の処理を学習します。全ての中間画像を必ず順番に一枚ずつ学ぶ操作手順を示したものではありません。
学習後の生成の基本例:新しく用意したノイズから、学習済みモデルで状態を段階的に更新し、新しい画像候補を作ります。こちらは逆拡散過程の向きです。上段の特定の一枚を、元の全画素どおり必ず復元する処理ではありません。
上下の図形は独自の模式例で、実験結果ではありません。生成の状態更新と、パラメータの追加学習は別です。途中の見た目が必ず単調に鮮明になることを保証しません。
上下とも左から右へ読みますが、上段はノイズを加え、下段は学習した仕組みで生成する別の関係です。
根拠:Ho, Jain, Abbeel: Denoising Diffusion Probabilistic Models(別タブで開く) ↗
潜在表現は、画像の内容などをモデル内部の数値で表したものでした。潜在拡散モデル(Latent Diffusion Model)は、画像を圧縮して表した潜在空間で拡散モデルを動かす構成です。学習用の画像をエンコーダで内部表現へ写し、その表現にノイズを加え、ノイズを減らす関係を学ぶ方法があります。画素そのものの上で拡散を行う方法と、計算する場所が違います。
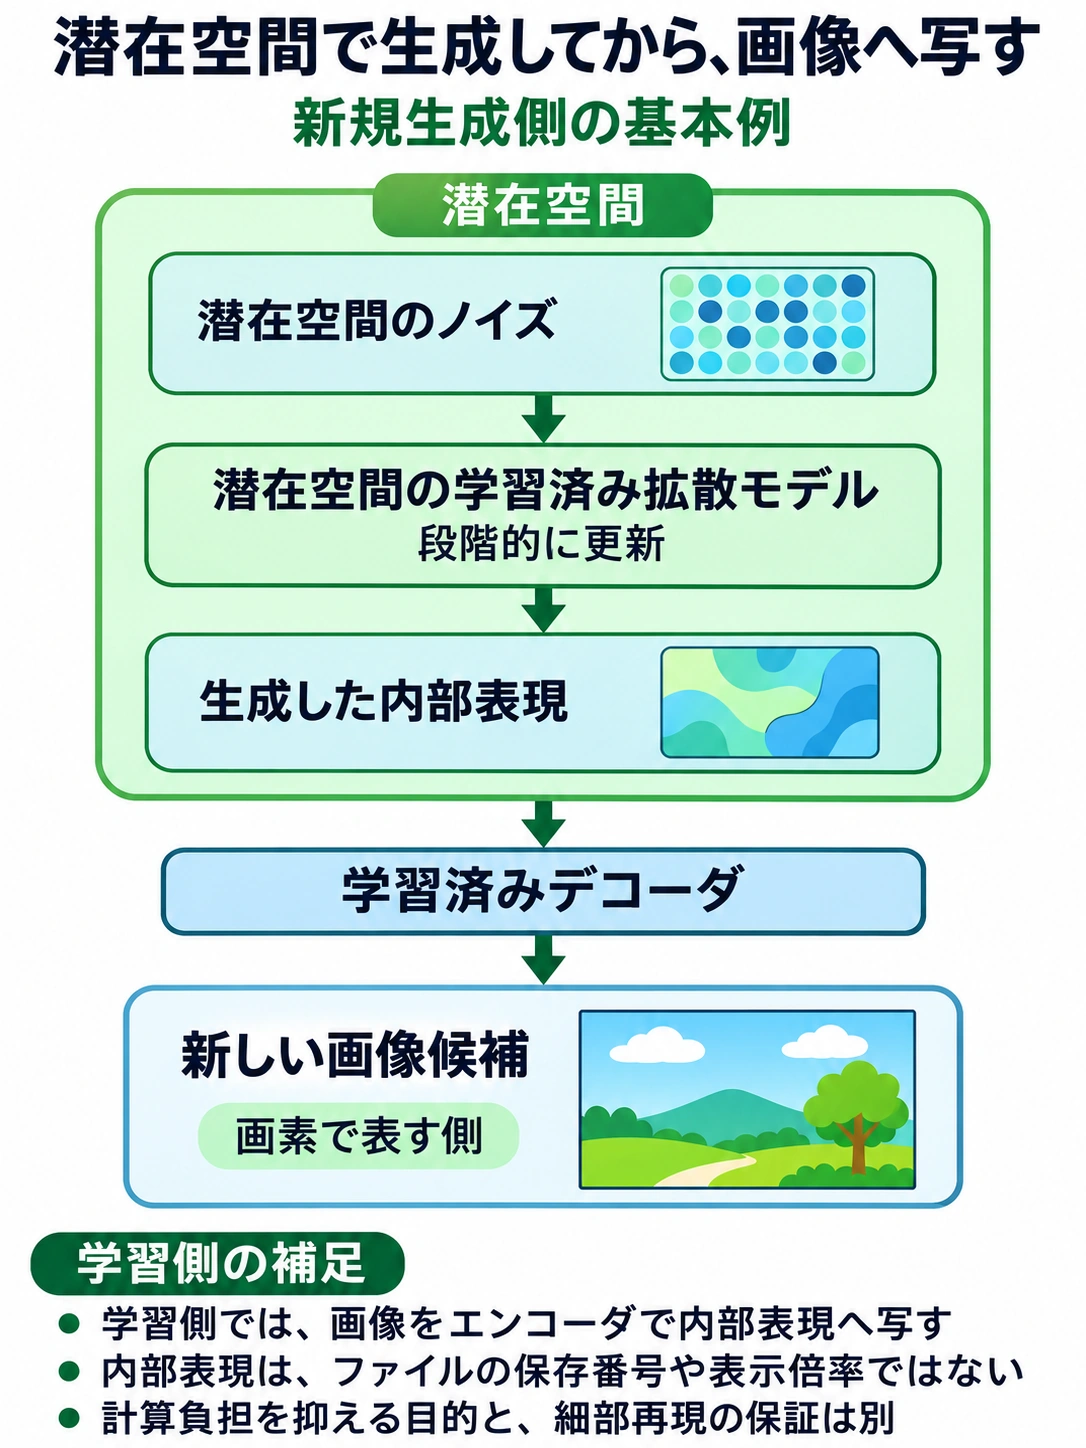
新しい画像を作るときは、潜在空間のノイズから内部表現を段階的に作り、最後に学習済みデコーダで画像へ写します。内部表現は元画像の保存場所を指す番号ではなく、画像を一度小さく表示し、表示倍率だけを戻す話でもありません。内部表現を使うことで計算の負担を抑えられますが、全ての細部が完全に戻る保証はありません。どの圧縮モデル、段階数、条件を使うかは構成により異なります。
ここでは、Transformerという構造の話と、ノイズを減らして生成する拡散の話を、同じ分類の二択にしません。文章の条件を扱う部分などへTransformerを組み合わせる潜在拡散の例もあります。『文章入力だから文章専用モデル』『画像出力だから必ずGAN』とは、入力/出力の見た目だけで判断しないことが大切です。
根拠:Rombach et al.: High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗
 図を拡大する ↗
学習側では画像をエンコーダで内部表現へ写す工程があります。内部表現は、ファイルの保存番号や表示倍率ではありません。計算負担を抑える目的と、細部再現の保証は別です。圧縮モデルの学習と拡散モデルの学習を、同じ瞬間の一操作とする図ではありません。
主図は新規生成側だけを示す基本例です。構成ごとの条件・段階数・圧縮モデルの違いはあります。
根拠:Rombach et al.: High-Resolution Image Synthesis with Latent Diffusion Models(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
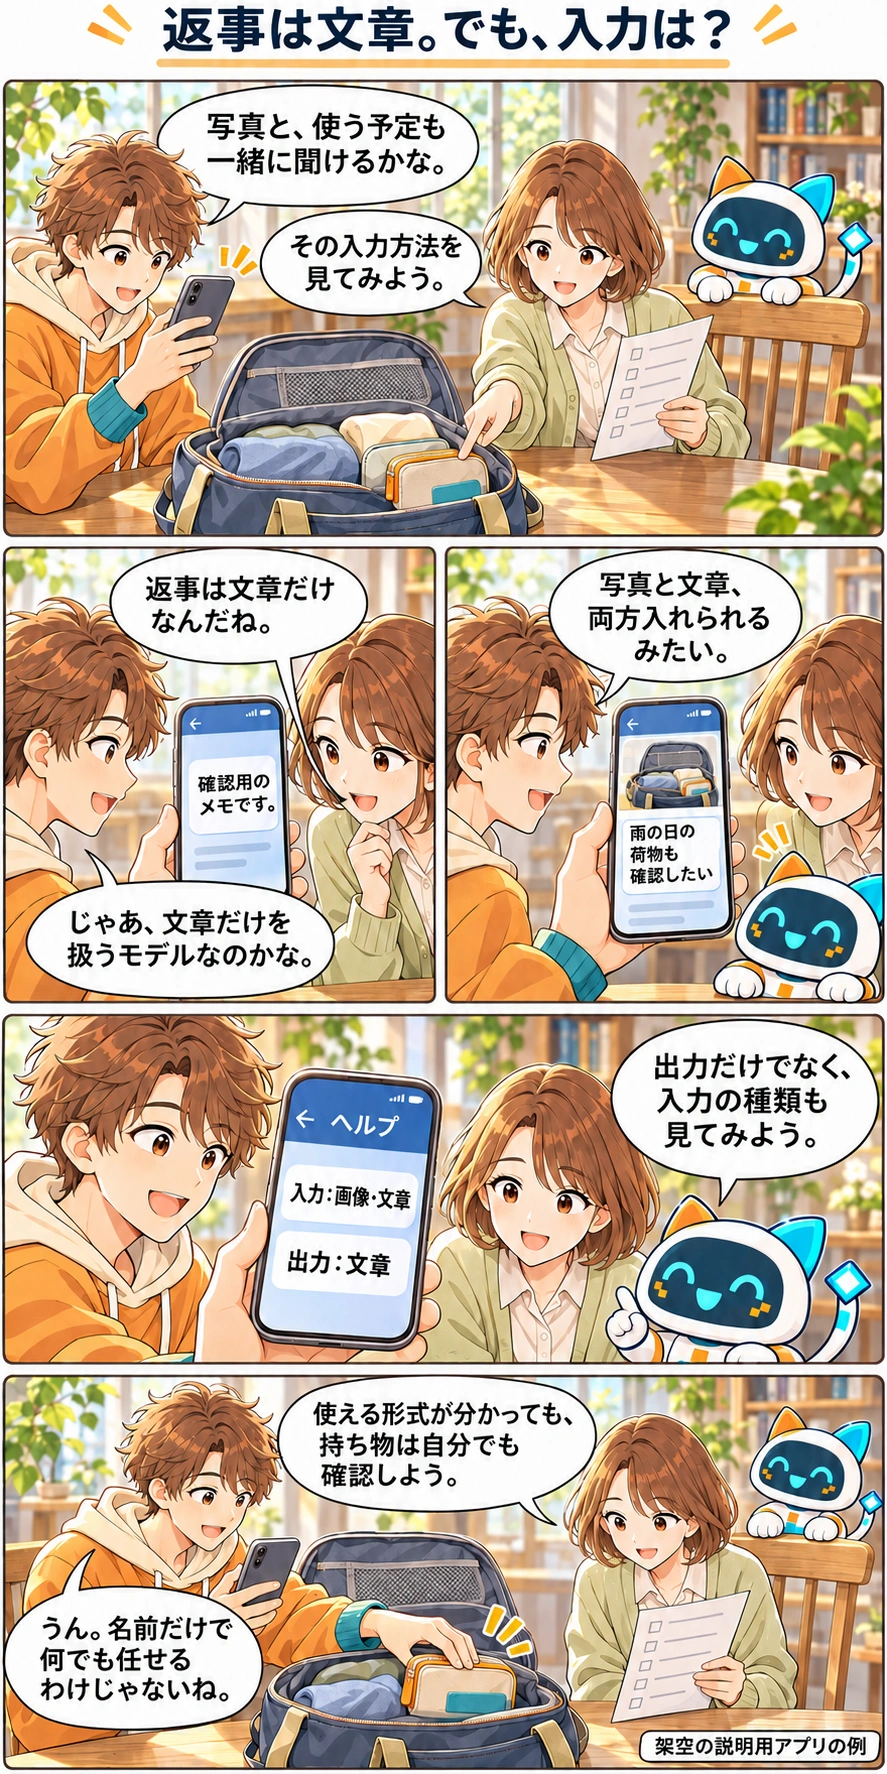
この話で学ぶこと:出力形式だけで、扱う入力形式を数えない。
コマは上から下へ、横に並んだコマは右から左へ読みます。
場面:上の引き。鞄と小袋、紙リスト。ハルが鞄を撮ろうとする。
ハル「写真と、使う予定も一緒に聞けるかな。」 ミオ「その入力方法を見てみよう。」場面:右コマ、全員に向けた画面の寄り。写真サムネイルと「雨の日の荷物も確認したい」という短い架空の依頼、入力中の状態。
ハル「写真と文章、両方入れられるみたい。」場面:同段左。説明用の文章結果が出た画面。
ミオ「返事は文章だけなんだね。」 ハル「じゃあ、文章だけを扱うモデルなのかな。」場面:横長、ヘルプの短い表示「入力:画像・文章/出力:文章」をハルが二人にも向ける。
ビット「出力だけでなく、入力の種類も見てみよう。」場面:下の横長。ミオが紙リストと鞄を見比べ、ハルが小袋を置く。
ミオ「使える形式が分かっても、持ち物は自分でも確認しよう。」 ハル「うん。名前だけで何でも任せるわけじゃないね。」入力の形式と出力の形式を分けた架空アプリの例です。基盤モデルかどうかや、結果が正しいかという確認は、別の軸で行います。
基盤モデル(Foundation Model)は、広く多様なデータを大規模に学び、さまざまな用途へ利用/適応する土台となるモデルです。一つの決まった課題だけのために最初から作る専用モデルとは、位置付けが異なります。使いたい用途に合わせて追加学習などで調整する方法もありますが、利用できることと、どの場面でも正しく答えることは別です。
例えば、多様で大量の文章を学び、要約や翻訳など複数の用途へ使う架空のモデルは、文章のみでも基盤モデルとなり得ます。『基盤』という名前から、必ず画像・動画・音声の全てを入出力できると読み取りません。対象の言語や内容に合うか、評価する条件、利用を認める条件も確認します。
根拠:Bommasani et al.: On the Opportunities and Risks of Foundation Models(別タブで開く) ↗ / Google Developers: Machine Learning Glossary — foundation model(別タブで開く) ↗
モダリティは、文章、画像、音声などの情報の種類/形式を表す言葉です。複数のモダリティを入力、出力、またはその両方で扱う性質をマルチモーダルと呼び、そのようなモデルをマルチモーダルモデルと呼びます。例えば写真と文章の指示を入力し、文章だけで答えるモデルも当てはまります。出力にも必ず二種類以上が必要、という意味ではありません。
写真がJPEGとPNGという別のファイル形式で二枚あっても、ここでは両方とも画像のモダリティです。また、画像を外部の文字認識で文章に変えてから文章専用モデルへ渡すシステムでは、その文章専用モデル自体が画像を直接扱うとまではいえません。システム全体と、今見ているモデルの入力/出力を分けて確かめます。
根拠:Google Developers: Machine Learning Glossary — modality / multimodal model(別タブで開く) ↗ / Google Cloud: Multimodal AI(別タブで開く) ↗
基盤モデルかどうかは、広い学習とさまざまな用途への土台という軸です。マルチモーダルかどうかは、扱う情報の種類の軸です。二つの言葉は同義ではありません。写真と短文の組が合うかを決める一つの専用課題のモデルなら、複数形式を扱っても、その事実だけで基盤モデルと確定しません。広い用途と複数形式の両方を備える構成もあります。
自分の用途では、必要な入力/出力に対応しているか、求める結果が実際に出るかを、それぞれ確認します。仕様で画像を扱えると分かっても、画像中の小さな文字や事実関係を必ず正しく読めるとは限りません。送ってよい資料か、出力をどう確かめるかという注意は、後の安全・権利の教材でも扱います。
根拠:Bommasani et al.: On the Opportunities and Risks of Foundation Models(別タブで開く) ↗ / Google Developers: Machine Learning Glossary — modality / multimodal model(別タブで開く) ↗ / Google Cloud: Multimodal AI(別タブで開く) ↗
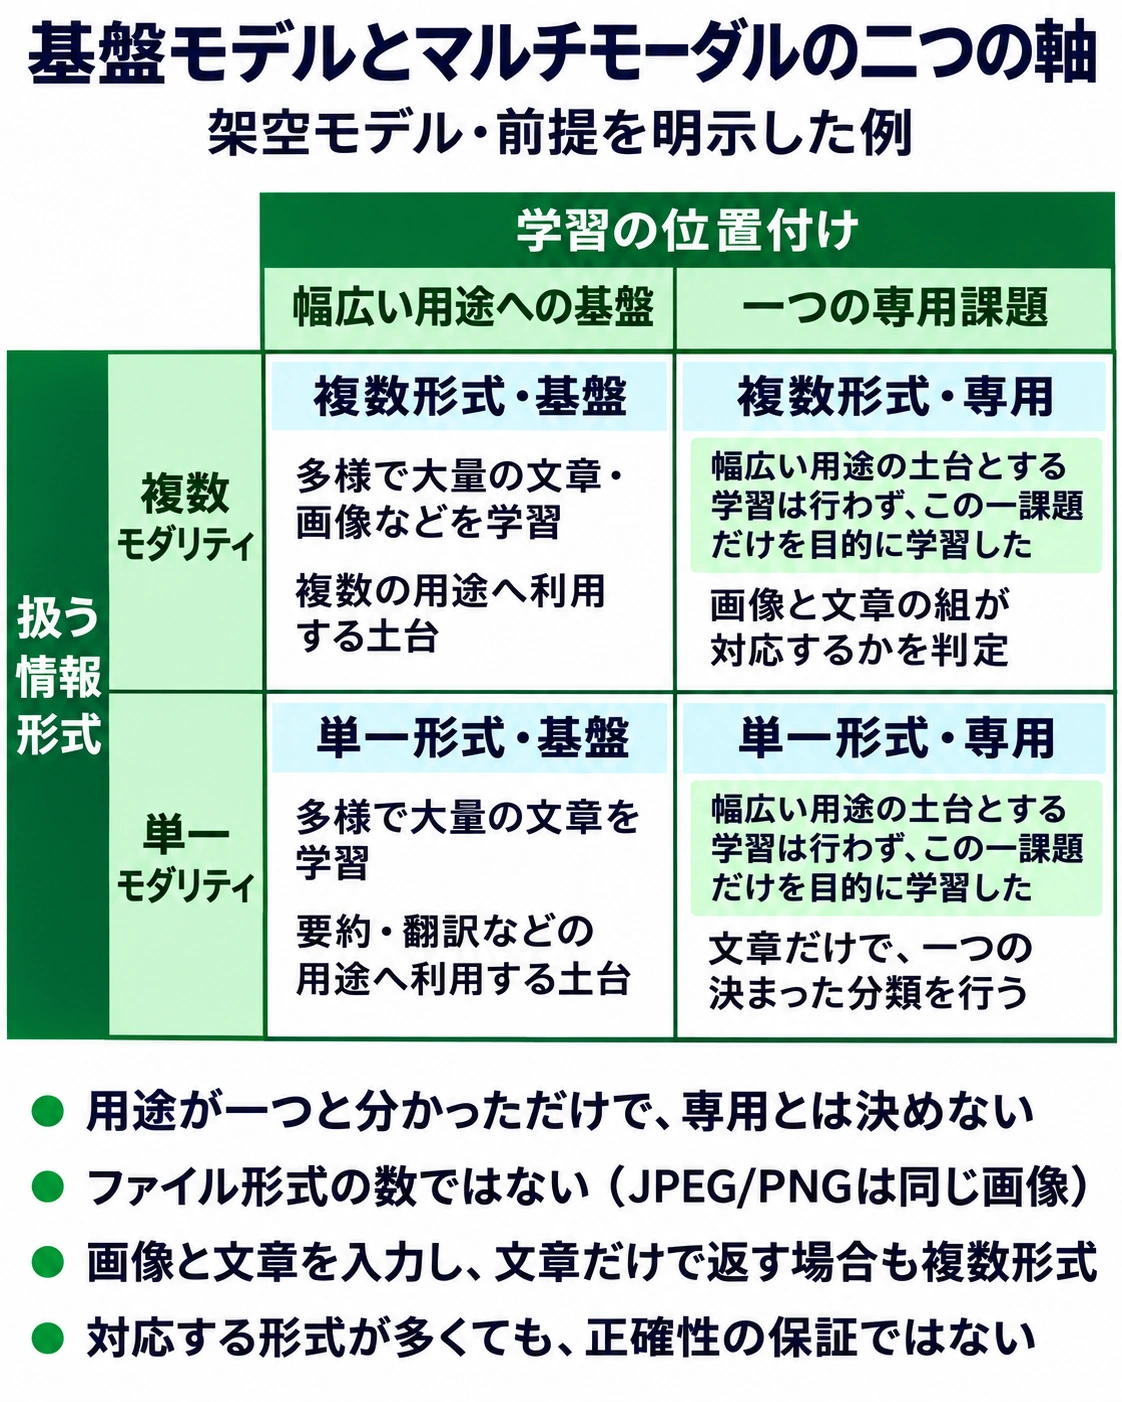 図を拡大する ↗
学習の位置付け(幅広い用途への基盤/一つの専用課題)と、扱う情報形式(単一/複数モダリティ)は、別の二つの軸です。次の四つは前提を明記した架空例です。
多様で大量の文章・画像などを学習し、複数の用途へ利用する土台となる架空モデルです。
幅広い用途の土台とする学習は行わず、この一課題だけを目的に学習した架空モデルです。画像と文章の組が対応するかを判定します。
多様で大量の文章を学習し、要約・翻訳などの用途へ利用する土台となる架空モデルです。
幅広い用途の土台とする学習は行わず、この一課題だけを目的に学習した架空モデルです。文章だけで一つの決まった分類を行います。
表示された用途が一つと分かっただけでは、専用と決めません。広く学習した基盤モデルを一課題へ調整した可能性もあります。JPEGとPNGはどちらも画像で、ファイル形式の数とモダリティの数は別です。画像と文章を入力し文章だけで返す場合も、複数形式を扱えます。対応形式が多いことは正確性の保証ではありません。
四例は優劣や進化の順序を表していません。仕様と利用条件を、実際の用途で別に確認します。
根拠:Bommasani et al.: On the Opportunities and Risks of Foundation Models(別タブで開く) ↗ / Google Developers: Machine Learning Glossary — foundation model(別タブで開く) ↗ / Google Developers: Machine Learning Glossary — modality / multimodal model(別タブで開く) ↗ / Google Cloud: Multimodal AI(別タブで開く) ↗
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。