この教材の目次を開く
回答はこのページを開いている間だけ保持します。別ページへの移動や再読み込みで消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
1写真のどこを使って見分ける? CNNの畳み込み
画像の小さな形を、全体の判断へどうつなぐのでしょうか。
この節で使う言葉:CNN・畳み込み・コンピュータビジョン
この節の学習目標:畳み込みの役割と分類の役割を分け、画像内の位置と時間の順番を区別する。
運河沿いで旅の記録に入れる橋の写真を選ぶ二人。「橋の候補」にトンネルの入口も混ざっています。選んだ石橋の写真を、今見た実物の石橋と見比べ、アーチと川が写っていることを確かめて、その一枚を旅の記録に加えます。写真候補の検索方式は、漫画からは分かりません。
橋とトンネルの写真では、同じような弧の形が見えても、周りの川や道路との関係が違います。人が見比べる場面から問いを作り、ここからはコンピューターが画像の数値を扱う仕組みを見ていきます。
似ている形、違う場所
この話で学ぶこと:写真の一部が似ていても、全体の判断は同じとは限りません。CNNは小さな範囲の特徴を組み合わせる方法の一つです。
コマは上から下へ、横に並んだコマは右から左へ読みます。
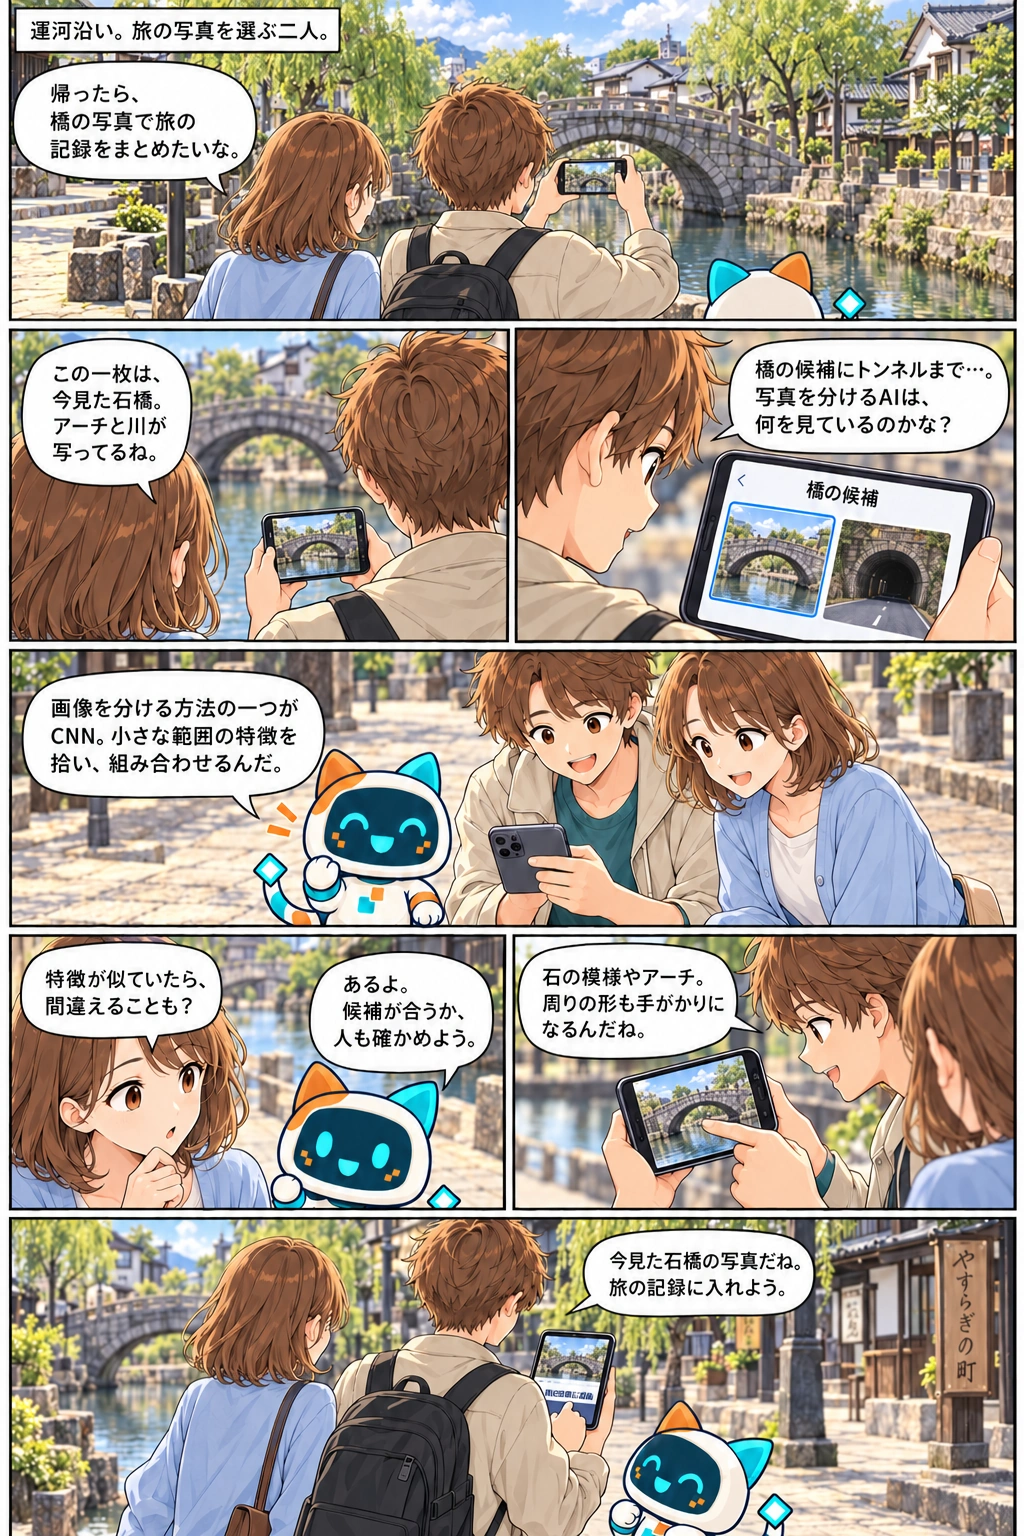
会話を文章で読む
場面:運河の石橋を背後から撮る二人。ミオは読者左、ハルは読者右。ハルの両手が同じスマートフォンを横向きに支える。ビットは背面で水色の耳が左・オレンジが右。
場面説明「運河沿い。旅の写真を選ぶ二人。」
ミオ「帰ったら、橋の写真で旅の記録をまとめたいな。」場面:右コマ。ハルが同じスマートフォンの橋候補を見る。石橋と道路トンネルの2枚が並ぶ。画面はハルへ向き、肩越しに読者にも見える。
ハル「橋の候補にトンネルまで…。写真を分けるAIは、何を見ているのかな?」場面:左コマ。背面のミオが左、ハルが右。スマートフォンの石橋写真と実物の石橋を見比べる。
ミオ「この一枚は、今見た石橋。アーチと川が写ってるね。」場面:前から見たハルが左・ミオが右。ハルがスマートフォンを自分たちへ向ける。正面のビットが小さな範囲を使う方法を説明する。
ビット「画像を分ける方法の一つがCNN。小さな範囲の特徴を拾い、組み合わせるんだ。」場面:右コマ。ハルが横向きのスマートフォンを片手で支え、別の手の人差し指で写真のアーチ付近を示す。ミオが同じ側から見ている。
ハル「石の模様やアーチ。周りの形も手がかりになるんだね。」場面:左コマ。ミオが手を顎へ添えて尋ね、正面のビットが候補の確認を勧める。
ミオ「特徴が似ていたら、間違えることも?」
ビット「あるよ。候補が合うか、人も確かめよう。」場面:背後から見たミオが左・ハルが右。ハルは選んだ石橋写真を旅の記録へ追加しようとする。確認した写真一枚についての行動で、他の候補も全て確認済みとはしていない。
ハル「今見た石橋の写真だね。旅の記録に入れよう。」
形と周りを、何のために見比べる?
橋とトンネルには、どちらも弧のような形が見えることがあります。形の一部が似ていても、川の上にあるのか、山の中へ道が続くのかで、人の判断は変わります。漫画は一部分の形と周囲の関係を比べるための場面です。人の見方と、これから説明するモデルの計算が同じ、という意味ではありません。
CNN(畳み込みニューラルネットワーク)は、畳み込みという計算を使う層を持つニューラルネットワークです。ニューラルネットワークは、値を受け渡しながら計算するモデルでした。CNNは画像認識でよく使われ、画像の近くにある点どうしの関係を扱いやすい構造を持ちます。アプリに写真を渡せるという事実だけでは、その内部にCNNがあるかは分かりません。
根拠:GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別のタブで開く) ↗ / Google Developers: Machine Learning Glossary(別のタブで開く) ↗ / TensorFlow: Convolutional Neural Network (CNN)(別のタブで開く) ↗
畳み込みは、小さな範囲で同じ計算を使う
画像は画素という小さな点が並んだもので、点ごとの明るさや色を数値で表せます。畳み込みでは、小さな範囲の数値へ重みを掛けて足し合わせます。重みは、入力の影響を調整する数値です。この重みの小さなまとまりをフィルタ、またはカーネルと呼びます。
一つのフィルタを画像内の別の位置にも当て、同じ重みを繰り返し使うのが特徴です。場所ごとに別の写真を覚える処理でも、そこに「橋」という文字があるかを探す処理でもありません。複数のフィルタを使うと、線の向きや明暗の境目など、異なる特徴への反応を数値で表せます。分類のために学習するCNNでは、これらの重みもデータに合わせて調整します。
層を重ねると、小さな範囲から得た特徴を組み合わせ、より広い範囲の形や配置を判断へ使えるようになります。橋の分類なら、弧に似た形だけでなく、周囲の特徴も手掛かりにする構成が考えられます。ただし、どの層が何を表すかを、いつも人が名付けた部品へ一対一に対応させられるわけではありません。
画像の小さな範囲から特徴を取り出すことと、最後にカテゴリを選ぶことは別の役割です。畳み込みの結果をさらに計算し、「橋・トンネル」などの種類を選ぶ部分へつなぐことで、画像全体を分類するモデルを作れます。
根拠:Keras: Conv2D layer(別のタブで開く) ↗ / TensorFlow: Convolutional Neural Network (CNN)(別のタブで開く) ↗ / Google Developers: Machine Learning Glossary(別のタブで開く) ↗
コンピュータビジョンは分野、CNNは構造
コンピュータビジョンは、画像や動画から対象や状態などの情報を読み取る分野です。写真全体の種類を選ぶ画像分類のほか、どこに対象があるかを求める物体検出などを含みます。CNNは、そのために使われる構造の一つです。分野の名前と、モデルの構造の名前を分けましょう。
一枚の写真にある上下左右の並びは、画像内の位置です。撮影した順番や時間の経過とは違います。また、写真を種類へ分ける処理と、新しい写真を作る処理では、求める出力が違います。画像を入力したことだけで、生成する仕事とは判断できません。
画像の位置や照明が変わっても同じ物を見分けたい場合は、学習に使っていない写真で確かめます。小さな範囲に同じ重みを使えることが、どんな位置・角度でも正しく分類できる保証になるわけではありません。
根拠:Google Cloud: Vision AI — What is computer vision?(別のタブで開く) ↗ / Keras: Conv2D layer(別のタブで開く) ↗ / TensorFlow: Convolutional Neural Network (CNN)(別のタブで開く) ↗
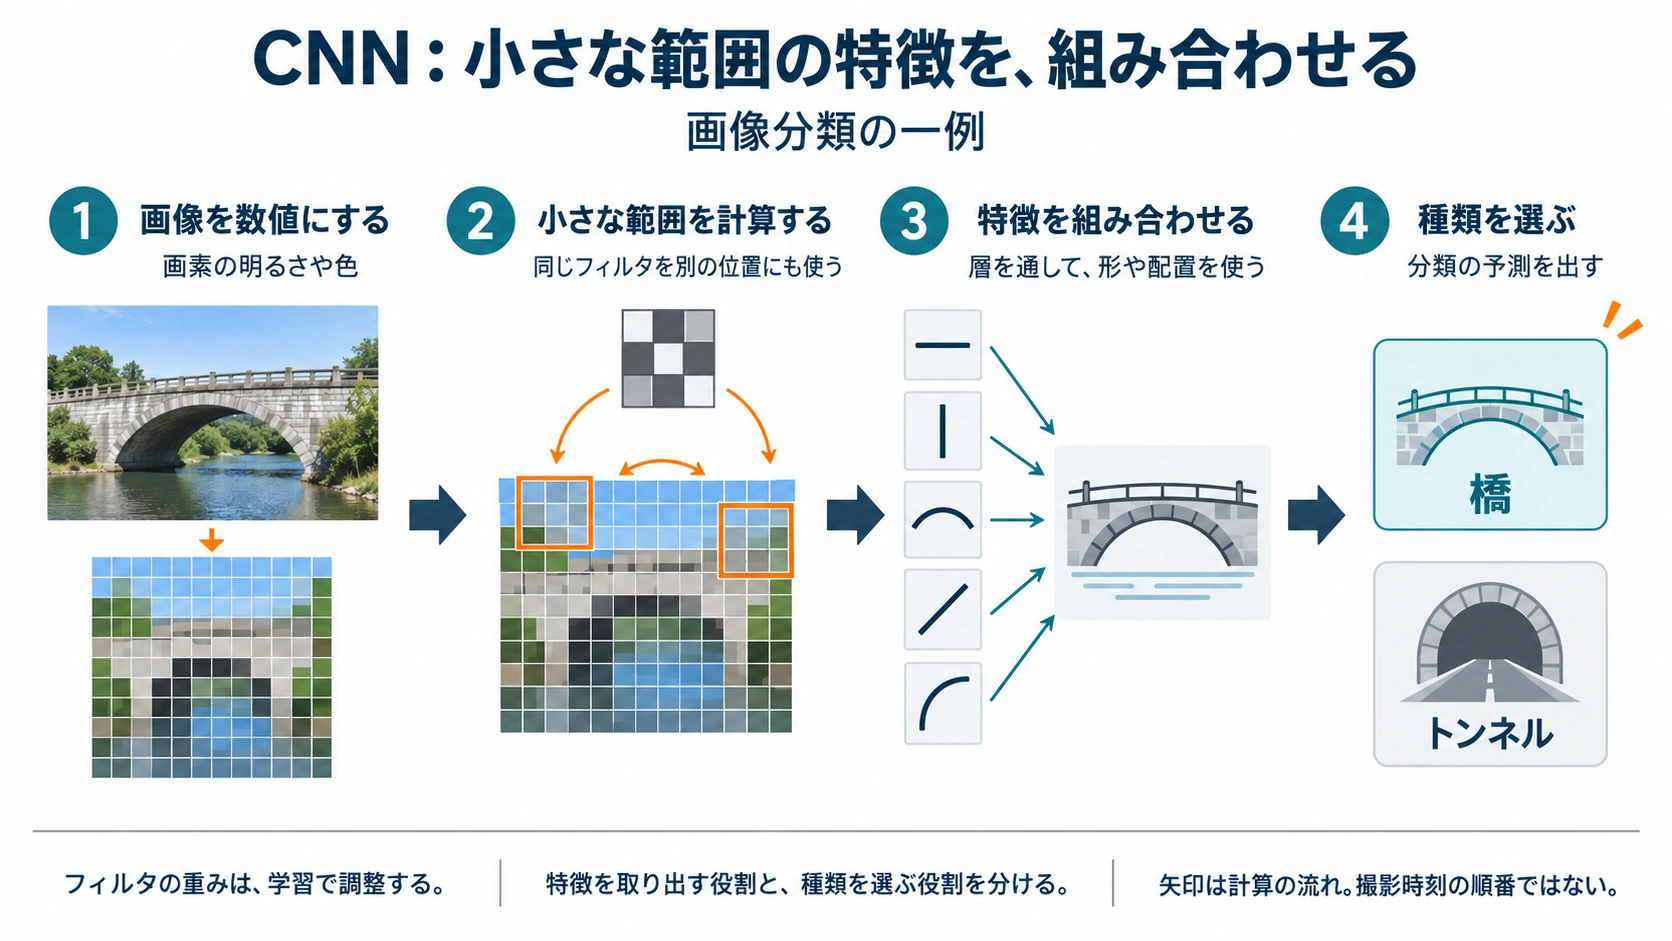 図を拡大する ↗
図の内容を文章で確認する
- 画像を数値にする:画素の明るさや色を受け取る。
- 小さな範囲を計算する:同じフィルタの重みを、画像内の複数の位置へ当てる。複数のフィルタで特徴への反応を取り出す。
- 特徴を組み合わせる:層を通して、より広い範囲の形や配置を判断へ使う。
- カテゴリを選ぶ:分類用の計算へつなぎ、用意した種類から結果を出す。
図は役割を分けた説明です。線や弧を人と同じように理解してから答える、という意味ではありません。
図では画像分類用CNNの一例を示します。矢印は計算結果を次へ渡す向きで、撮影時刻の順番ではありません。 線や弧の記号と橋の絵は、特徴を組み合わせる働きの模式表現です。各層が橋の部品を一対一に理解したり、新しい橋の画像を生成したりする意味ではありません。
別場面:作業台の部品写真を分類する
工場で、作業台の写真を「歯車・ねじ・その他」に分ける架空の課題を考えます。入力は一枚の写真、出力は部品のカテゴリです。CNNを使うなら、小さな範囲の線や明暗への反応を組み合わせ、種類を選ぶ計算へつなげます。
歯車に似た輪郭のねじ頭もあるかもしれません。一つの形への反応だけを答えにせず、ほかの特徴も組み合わせ、別の背景や角度の写真で確かめます。これは画像分類であり、新しい部品写真を作る課題ではありません。
別の場面で確かめる
全て独自作成の問題です。答える前に、本文の考え方を条件に当てはめてみましょう。
言葉にしてみる (採点なし)
畳み込みで特徴を取り出す役割と、最後に部品の種類を選ぶ役割を、自分の言葉で分けて説明してください。
2同じ言葉でも順番が違う。RNNの状態
前に受け取った情報を、次の入力にどう生かすのでしょうか。
この節で使う言葉:RNN(再帰型ニューラルネットワーク)・シーケンスデータ・状態
この節の学習目標:順序に意味があるデータを見分け、前の状態と現在の入力から新しい状態を作る流れを説明する。
駅前で、駅から港へ歩く案内を探す二人。地名だけを聞いて使えると思いましたが、三人で音声を聞き直すと「港から、市場を通って、駅へ向かいます」と分かりました。今いる駅とは逆方向の案内なので、駅から港への案内を選び直します。録音案内がRNNを使っているかは、この場面からは分かりません。
駅・市場・港という名前が同じでも、駅から港へ行く案内と、港から駅へ行く案内では向きが逆です。聞き直す場面から、要素の一覧だけでは残せない順番の情報を考えます。
同じ地名でも、行き先は逆
この話で学ぶこと:同じ地名が出ても順番が違えば、案内の向きは変わります。RNNは前の情報を次の入力へ受け渡す方法の一つです。
コマは上から下へ、横に並んだコマは右から左へ読みます。
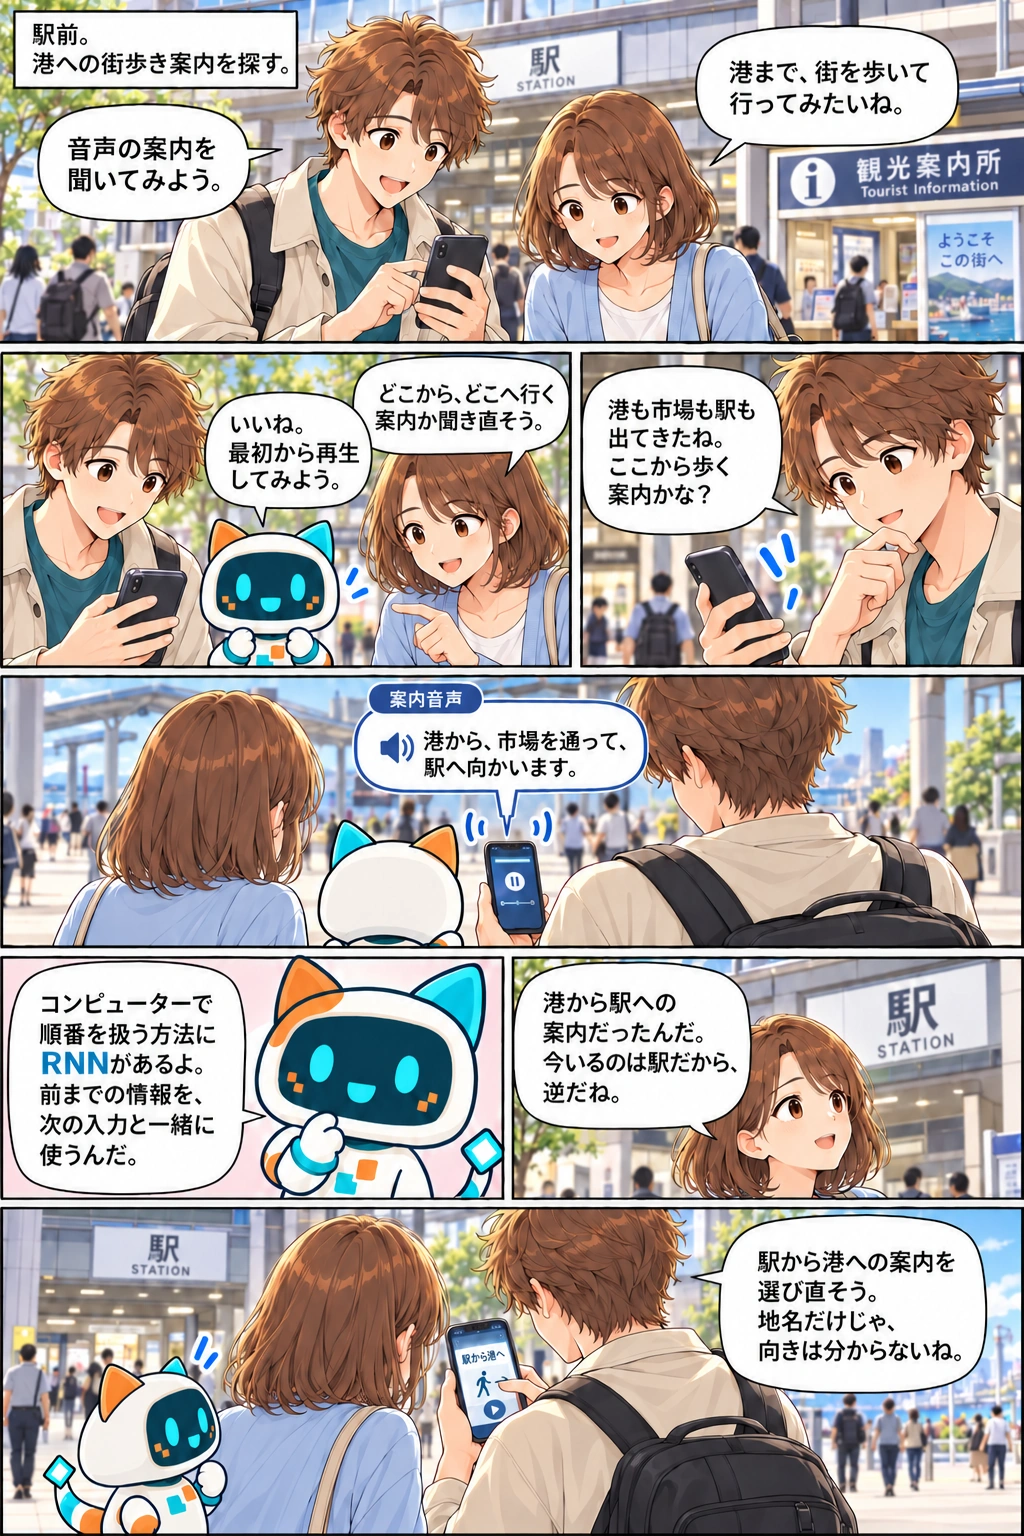
会話を文章で読む
場面:駅の観光案内所の前。正面のハルが左、ミオが右。ハルが自分のスマートフォンを持ち、二人で画面を見る。
場面説明「駅前。港への街歩き案内を探す。」
ミオ「港まで、街を歩いて行ってみたいね。」
ハル「音声の案内を聞いてみよう。」場面:右コマ。ハルはスマートフォンのスピーカーから録音案内を聞き、3つの地名に気づく。まだ出発地・目的地を確かめていない。
ハル「港も市場も駅も出てきたね。ここから歩く案内かな?」場面:左コマ。正面からハルが左、ミオが右、ビットは中央。ミオが聞き直しを提案し、ビットが再生を勧める。
ミオ「どこから、どこへ行く案内か聞き直そう。」
ビット「いいね。最初から再生してみよう。」場面:背後からミオが左・ハルが右、ビットは間で録音を聞く。ハル自身の手で同じスマートフォンを支える。ビットの背面は水色の耳が左・オレンジが右。音声の吹き出しはスマートフォンへ向く。
案内音声「港から、市場を通って、駅へ向かいます。」場面:右コマ。ミオが目の前の駅の表示を見て、駅へ向かう案内だと気づく。ミオはまだ歩き始めていません。
ミオ「港から駅への案内だったんだ。今いるのは駅だから、逆だね。」場面:左コマ。目を開いたビットが片方の前足を顎付近へ添え、順番を扱う方法の一例を説明する。録音やアプリの内部にRNNがあるとは断定していない。
ビット「コンピューターで順番を扱う方法にRNNがあるよ。前までの情報を、次の入力と一緒に使うんだ。」場面:肩越しに見たミオが左・ハルが右。小さなスマートフォンは二人へ向き、ハルの支える手と選ぶ指が本体へつながる。駅から港への項目を選び直そうとし、港へ到着したとはしていない。
ハル「駅から港への案内を選び直そう。地名だけじゃ、向きは分からないね。」
順番を替えると、同じ言葉でも意味が変わる
二人は駅から港へ歩きたいのに、聞き直した案内は「港から、市場を通って、駅へ向かいます」でした。同じ駅・市場・港という名前でも、出発点と目的地は逆です。名前を集めただけでは、その違いを残せません。漫画で確かめたのは、何が、どの順番で伝えられたかです。人の聞き直しそのものが、RNNの数値の計算という意味ではありません。
シーケンスデータは、順序を持つデータの並びです。文章の語順、音声の時間の流れ、機械の温度を時刻順に並べた記録などが当たります。表の行として並んでいても、その順番に意味があるとは限りません。例えば、客の会員番号の一覧と、一台の機械の温度が変わる記録では、順番の役割が違います。
温度を低い順に並べ替えると、上がってから下がったのか、下がってから上がったのかが分からなくなります。モデルへ渡す前に、何の順番を残す必要があるかを決めます。なお、案内の文や声を見聞きしただけでは、その作成や認識に使われたモデルの構造までは分かりません。
根拠:GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別のタブで開く) ↗ / TensorFlow: Working with RNNs(別のタブで開く) ↗ / Google Developers: Machine Learning Glossary(別のタブで開く) ↗
前の状態と今の入力から、新しい状態を作る
RNN(再帰型ニューラルネットワーク)は、並びの前の部分から受け渡した情報を、次の部分の計算へ使う構造です。ここでは、先頭から後ろへ進む基本的なRNNを考えます。単語や音声も、そのまま文章として計算するのではなく、処理できる数値の形で渡します。
RNNは、一つ入力を受け取るたびに、前の状態と現在の入力から、新しい状態を計算します。状態とは、それまでに受け取った情報を反映する内部の数値のまとまりです。作った状態を次の入力の計算へ渡し、この手順を繰り返します。
「港から市場を通って駅へ」を順に処理する例なら、「港」の情報を反映した状態へ「から」の入力を合わせ、その新しい状態へ次の入力を合わせます。「駅から市場を通って港へ」では、状態を作る過程も変わります。同じ場所の名前でも、前後関係を判断へ使えるようにする考え方です。
状態は、前の言葉をそのまま並べた録音や全文の記録ではありません。数値へまとめる中で情報が弱くなったり、十分に残らなかったりすることもあります。順番を扱う構造があっても、出発点や目的地を正しく読み取れるかは、学習と別の例での確認が必要です。
根拠:TensorFlow: Working with RNNs(別のタブで開く) ↗ / Keras: Simple RNN cell layer(別のタブで開く) ↗ / Pascanu, Mikolov, Bengio: On the difficulty of training Recurrent Neural Networks(別のタブで開く) ↗
状態が変わることと、学習で重みが変わること
基本的なRNNでは、並びの各位置で同じ学習済みの重みを使います。利用中に入力に応じて変わるのは状態です。新しい語を受け取り、状態が変わったことだけで、重みを学習し直したとはいえません。学習は、目的に合う結果へ近づくよう重みなどを調整する段階でした。
状態から結果を出す方法には、並び全体を読んで一つの種類を選ぶ構成も、各時点で結果を出す構成もあります。例えば、文全体から問い合わせの用件を選ぶ課題と、温度の変化を順に読みながら次の値を予測する課題です。「何を、いつ出したいか」に合わせて設計します。
CNNの画像内の小さな範囲を計算する仕組みと、RNNの前の状態を次へ渡す仕組みは違います。どちらも数値を扱いますが、画像内の近さと、時間・語順の前後関係を同じものとみなさないことが、ここでの比較の要点です。
根拠:TensorFlow: Working with RNNs(別のタブで開く) ↗ / Keras: Simple RNN cell layer(別のタブで開く) ↗ / Pascanu, Mikolov, Bengio: On the difficulty of training Recurrent Neural Networks(別のタブで開く) ↗ / Keras: Conv2D layer(別のタブで開く) ↗
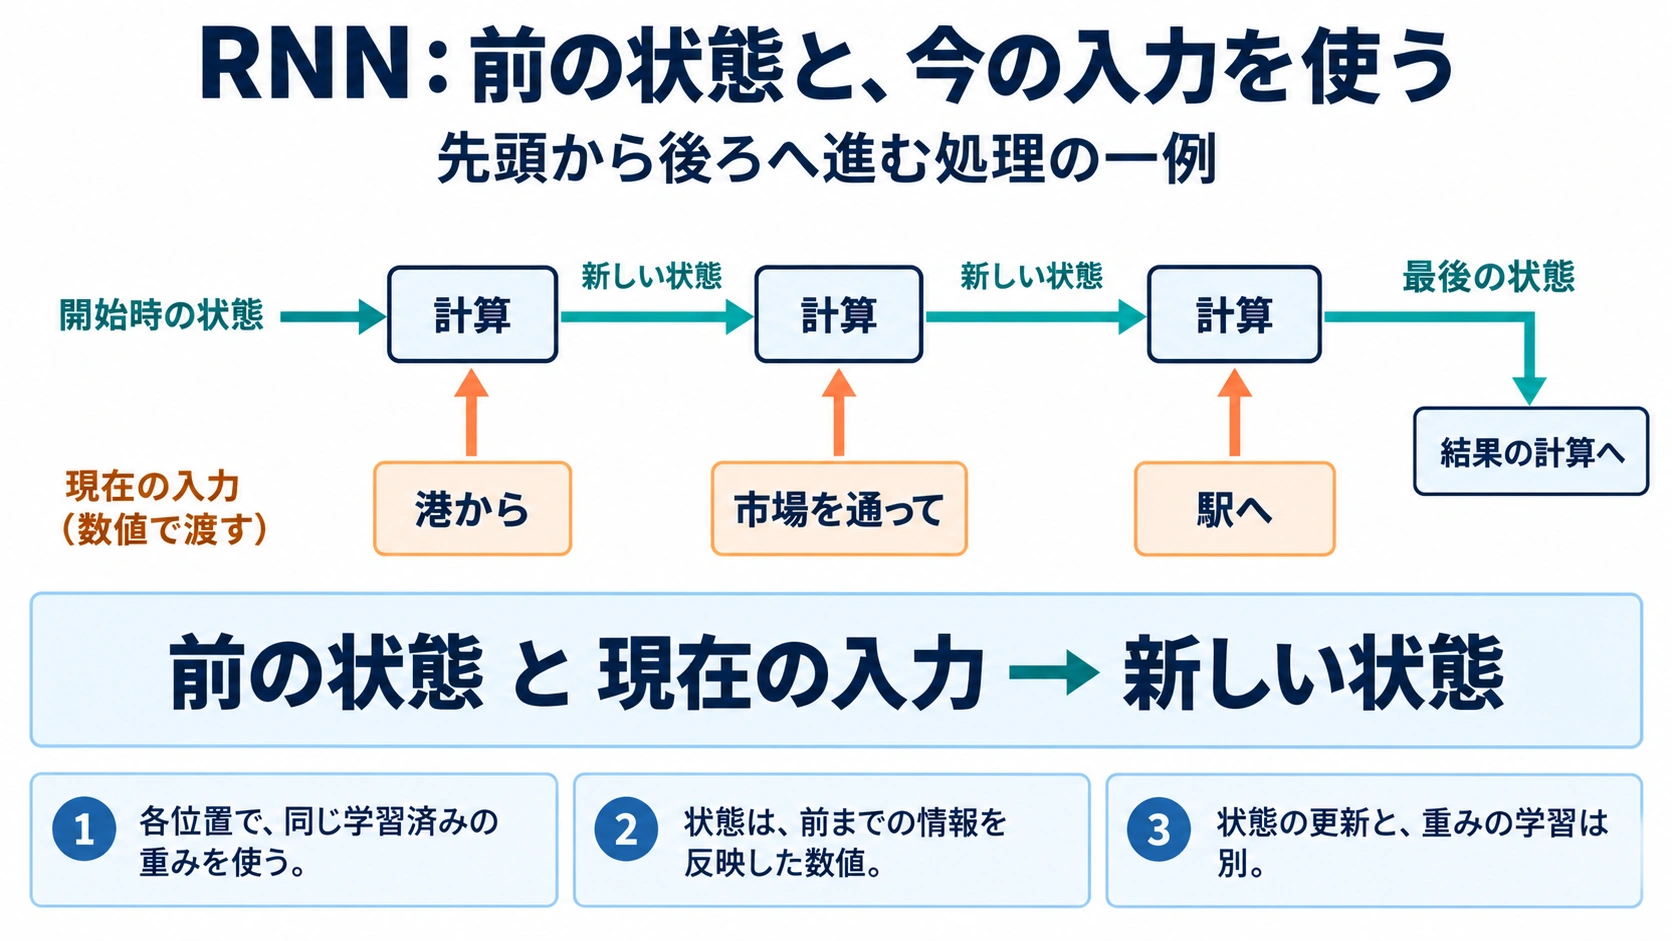 図を拡大する ↗
図の内容を文章で確認する
- 開始時の状態と、最初の入力から、新しい状態を作る。
- その状態と、次の入力から、次の状態を作る。
- 同じ手順を並びに沿って繰り返し、状態を結果の計算へ使う。
前の状態+現在の入力 → 新しい状態という二つの入力を追います。「+」は合わせて計算することを表し、状態が単純な足し算でできるという意味ではありません。各位置で使う学習済みの重みと、入力ごとに変わる状態は別です。
先頭から後ろへ進むRNNの一例です。横へ進む矢印は状態の受け渡し、下から入る矢印は現在の入力を表します。状態内の数値は説明用に省略します。 説明のため文を3つのまとまりに分けています。実際の入力単位は設計で異なります。
別場面:一台の機械の温度を追う
ある機械の温度が、朝は低く、昼に上がり、夕方に戻った記録を考えます。記録を温度の低い順に並べ替えると、変化の向きを失います。次の時点の温度を予測したいなら、まず同じ機械の記録を時刻順に渡します。
RNNを使う構成なら、前の記録を反映した状態と今の温度から、新しい状態を作れます。これは過去の温度を全文のまま保存するという説明ではなく、前後の関係を予測へ使う仕組みの例です。予測が役立つかは、学習に使っていない期間の記録で確かめます。
別の場面で確かめる
全て独自作成の問題です。答える前に、本文の考え方を条件に当てはめてみましょう。
言葉にしてみる (採点なし)
「下がってから上がる温度」と「上がってから下がる温度」を区別したいとき、RNNへ何を渡し、何を次へ受け渡すか説明してください。
3長い並びで、前の情報を使えるか
長い文章の最初にある条件を、最後の判断にも使うには、どんな工夫があるでしょうか。
この節の学習目標
- 勾配と損失、学習時の重みの更新と利用時の状態の変化を区別する。
- 勾配消失と勾配爆発の違いを説明する。
- LSTMの情報保持という基本的な役割、Attentionの参照配分、Transformerという構造を区別する。
- 【任意の補助】クリッピングやセル状態/ゲートの仕組みを、基本概念を助ける説明として追える。
閉店後のカフェ。ミオは、団体予約の人数変更について届いた架空の長いメールの返信案を整理しています。自動要約には「予約を取消」とありますが、冒頭には「予約は残し、人数だけ減らしたい」と書かれていました。ハルと元の条件を照合し、返信案を店長へ確認することにします。
残すのは、予約そのもの
この話で学ぶこと:離れた条件を確かめ、保持の工夫と参照する仕組みを分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
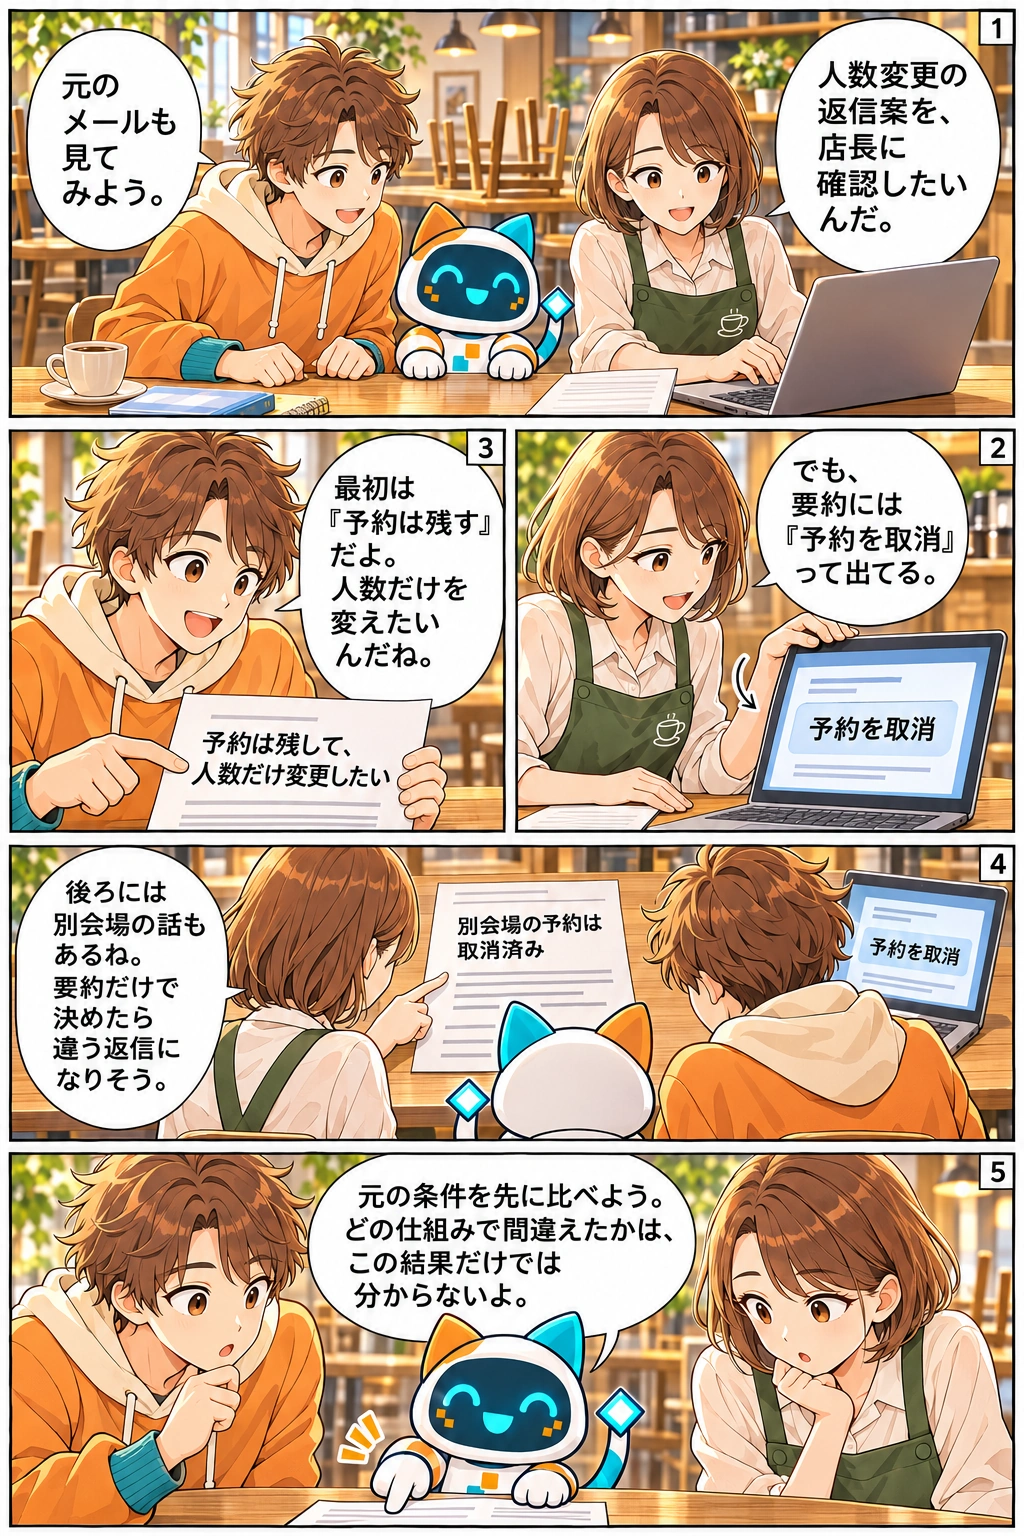
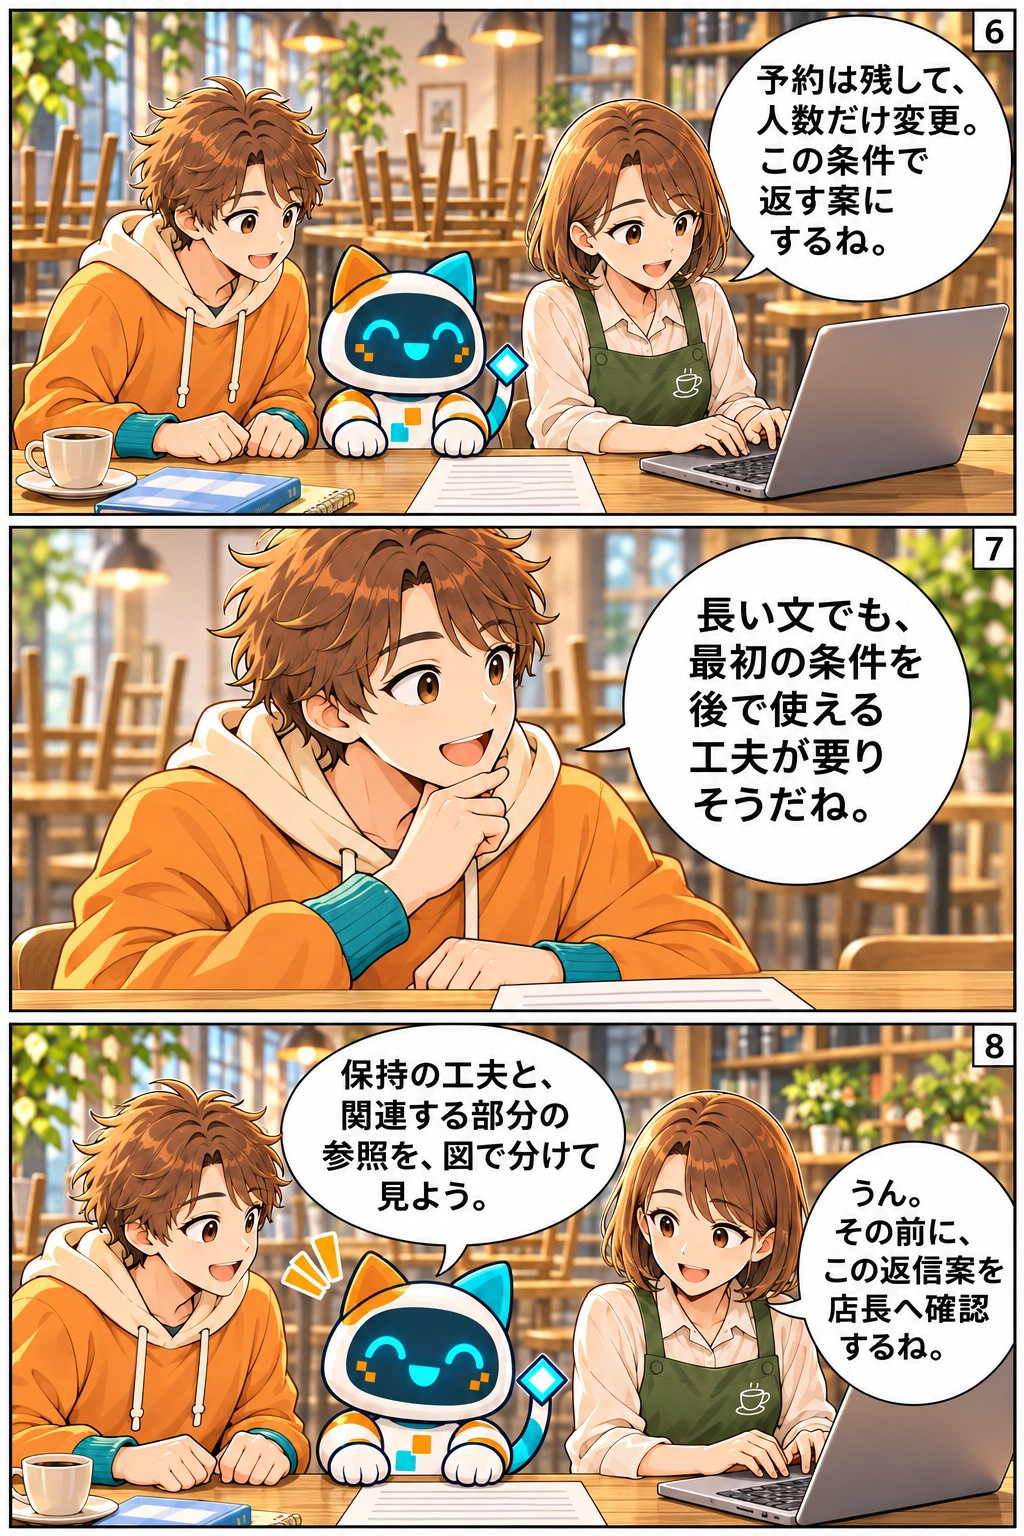
会話を文章で読む
場面:店の片付けが見える。ミオが返信案を作る目的を共有。
ミオ「人数変更の返信案を、店長に確認したいんだ。」
ハル「元のメールも見てみよう。」場面:ミオが画面を二人/ビットに見える向きへ少し回し、短い要約を見せる。
ミオ「でも、要約には『予約を取消』って出てる。」場面:ハルが冒頭の条件を見つける。
ハル「最初は『予約は残す』だよ。人数だけを変えたいんだね。」場面:原文の後の「別会場は取消」と、抜けた冒頭の条件を同じ画面で比べる。
ミオ「後ろには別会場の話もあるね。要約だけで決めたら違う返信になりそう。」場面:ビットは見せられた要約/原文を受けて整理する。
ビット「元の条件を先に比べよう。どの仕組みで間違えたかは、この結果だけでは分からないよ。」場面:原文を確認し、送信前の返信案を直す。
ミオ「予約は残して、人数だけ変更。この条件で返す案にするね。」場面:ハルが必要な判断を自分の言葉にする。
ハル「長い文でも、最初の条件を後で使える工夫が要りそうだね。」場面:ミオの次の仕事と、次の技術説明へつなぐ。
ビット「保持の工夫と、関連する部分の参照を、図で分けて見よう。」
ミオ「うん。その前に、この返信案を店長へ確認するね。」
漫画で確かめたのは、離れた場所の条件を使って用件を読む必要があることです。人がメールを読み直す行動は、LSTMやAttentionの計算そのものではありません。要約が誤った原因や、使われたモデルの構造も、この場面からは分かりません。ここからは、RNNの学習を難しくする現象、情報を保持する工夫、必要な部分を参照する仕組みを、別々に見ます。
前の節のRNNは、順序を持つデータを、前の状態と今の入力から次の状態へ渡して扱う構造でした。状態は内部の数値、重みなどのパラメータは学習で調整する数値です。この節でも、状態が変わる利用段階と、パラメータを更新する学習段階を分けます。
勾配の大きさは、損失の大きさとは別
学習では、出力が目的からどれくらい外れたかを損失という数値で評価します。重みなどのパラメータを少し変えたとき、損失がどちらへ、どれくらい変わるかを表す手掛かりが勾配です。勾配降下法では、その手掛かりを使ってパラメータを調整します。損失は結果を評価する値、勾配は調整の方向や大きさに関わる値で、同じ数値ではありません。
基本的なRNNは、並びの各位置で同じ重みを使い、前の状態と今の入力から次の状態を計算します。学習時には、後の位置での損失から、状態を作った計算を時間方向にもさかのぼります。この長い計算経路で、離れた位置に関わる勾配の寄与が繰り返し小さくなり、離れた情報の関係を学ぶ調整信号が弱くなるのが勾配消失問題です。反対に、勾配が過大になって更新が不安定になり得るのが勾配爆発問題です。
勾配が小さいという記録だけで、損失も小さい、離れた言葉の関係を学べた、とは判断できません。また、利用中に入力を受けて状態が変わることは、そのたびに重みを学習し直すことではありません。RNNの重みは位置ごとに別のものが冒頭から順に消えるのではなく、共有して使われます。長い文で間違えたという出力だけから、勾配消失が原因だと断定することもしません。
根拠:Pascanu, Mikolov, Bengio: On the difficulty of training Recurrent Neural Networks(別のタブで開く) ↗ / TensorFlow: Working with RNNs(別のタブで開く) ↗
任意の補助:勾配クリッピングは、過大な更新を抑える
勾配クリッピングは、過大な更新を抑える
勾配爆発への対策の一つが勾配クリッピングです。この節では、勾配全体の大きさを表すノルムが上限を超えたとき、向きを保ちながら全体を縮める方法を考えます。縮めた勾配を重みの更新へ使い、一度の過大な更新を抑えます。小さな勾配を上限まで引き上げる方法ではなく、勾配消失をそれだけで解消する処理でもありません。
ここで制限するのは、学習時の更新に使う勾配です。入力文の後半を切り取ることや、文字数を減らすことを指しません。前の情報を保持するセルやゲートを追加することとも違います。利用中に状態を次へ渡す処理と、学習時の勾配を抑える処理を分けて読みましょう。
任意の数値例を読む
数値の小例:一つの重みを更新する
RNN全体の実測ではなく、更新幅だけを見る一成分の説明例です。重みw=2、勾配g=12、学習率η=0.1、クリッピングの上限=3とします。学習率は、勾配に掛けて更新の大きさを調整する倍率です。値はすべて単位なしです。一成分なので、勾配ノルムは絶対値です。
- 上限なし:w'=2−0.1×12=0.8。
- クリッピング:gの大きさ12を上限3へ縮めるので、更新に使う勾配は3。
- 上限あり:w'=2−0.1×3=1.7。
一度の重みの移動を1.2から0.3へ抑えた例です。入力文の長さを12文字から3文字へ変えたのではありません。この数値例だけでモデルの精度向上を保証することもしません。
根拠:Pascanu, Mikolov, Bengio: On the difficulty of training Recurrent Neural Networks(別のタブで開く) ↗ / PyTorch 2.15: torch.nn.LSTM(別のタブで開く) ↗
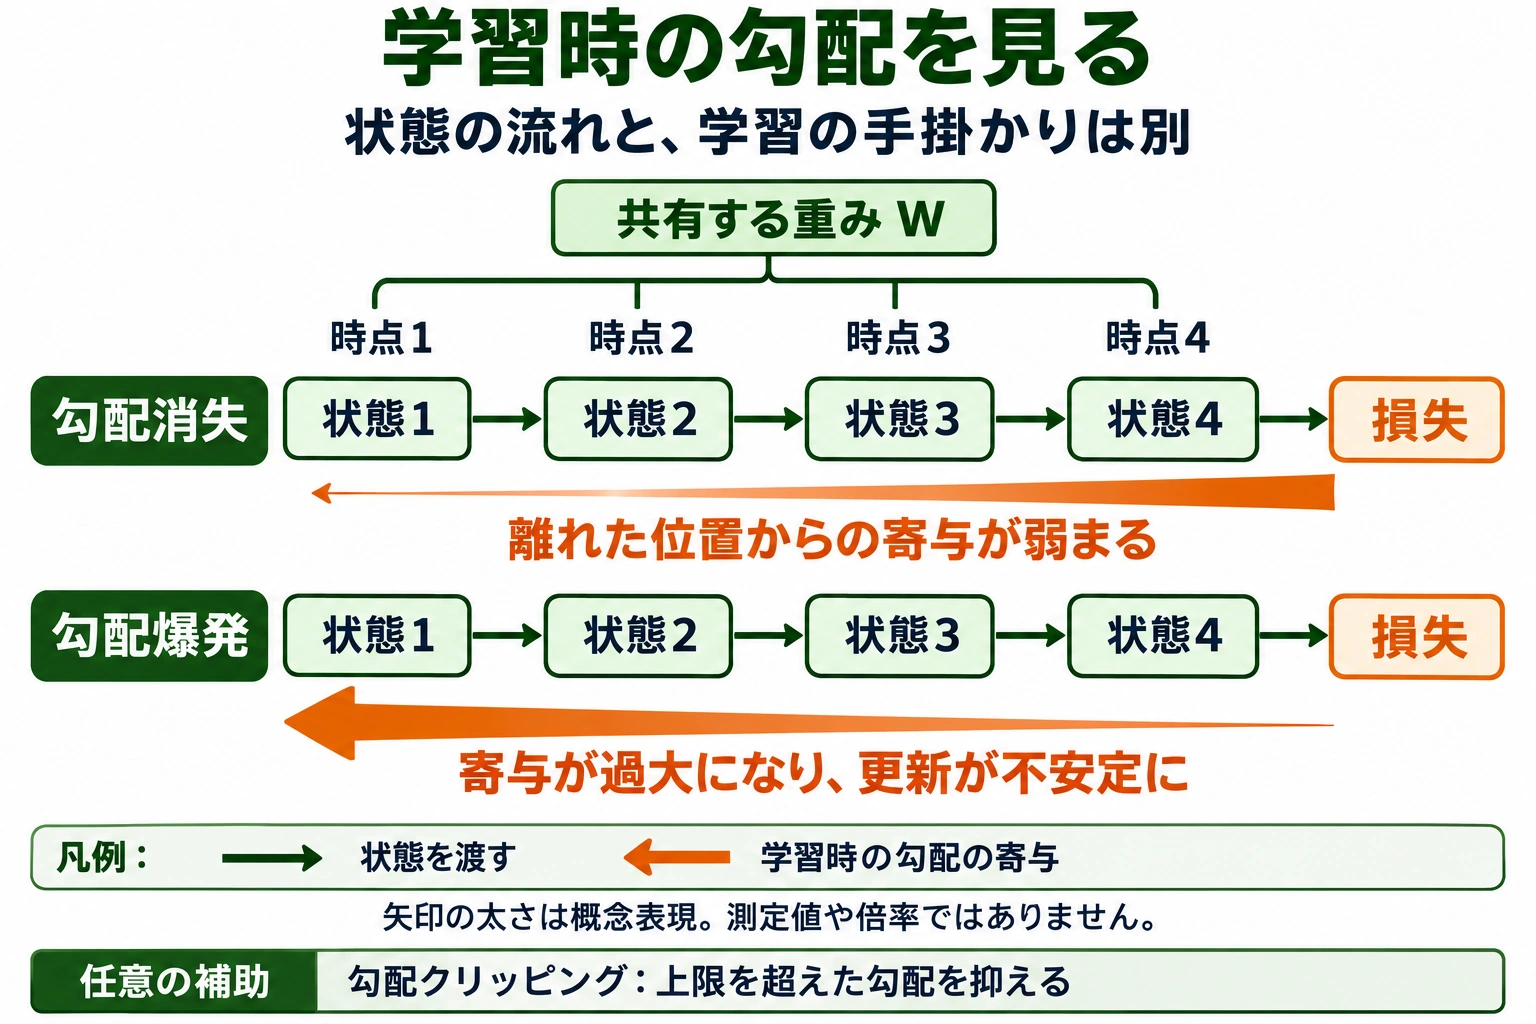 図を拡大する ↗
図の内容を文章で確認する
状態は時点1から4へ進み、学習時の勾配の寄与は損失から逆向きに追います。各時点で同じ重みWを共有します。消失は離れた位置での寄与が弱くなり、爆発は寄与が過大になることです。矢印の太さは測定値や倍率ではありません。任意の補助で扱うクリッピングは、上限を超えた勾配を抑えます。
学習の仕組みを説明する自作概念図です。原著の図や実験結果の転載ではありません。
LSTMは、セル状態に残す情報を調整する
LSTM(Long Short-Term Memory)は、情報を保持する仕組みを工夫したRNNの一種です。以前の入力の情報を後の計算でも使いやすくし、離れた位置どうしの関係を扱うためのモデルです。使うのは入力の情報を反映した内部の数値で、元の文章や録音を文字/音のまま保存した文書庫ではありません。保存した原文を検索で取り出す手順全体の別名でもありません。
任意の仕組み・計算を読む
ここからは現行の仕組みを少し詳しく見る任意の補助です。LSTMは出力側の状態に加えて、情報を運ぶセル状態という内部の数値のまとまりを使います。現在よく使われる形では、忘却・入力・出力のゲートで、前のセル状態をどれくらい残すか、今の候補情報をどれくらい加えるか、外へどれくらい出すかを調整します。ゲートは実物の扉ではなく、数値をどれくらい通すかを決める計算です。学習の勾配を縮める処理や、画像の局所の計算とは役割が違います。
セル状態を通じて情報を運ぶ工夫は、長く離れた関係を扱い、勾配消失を軽減するために役立ちます。人のように必要性を自覚して記憶するわけではありません。構造をLSTMにしたことだけで必要な条件が残ったとはせず、学習に使っていない長い文でも判断に使えるか確かめます。ここでは現行のゲートを持つ形を説明し、1997年の最初の論文に同じ忘却ゲートがあったとは説明しません。
根拠:PyTorch 2.15: torch.nn.LSTM(別のタブで開く) ↗ / TensorFlow: Working with RNNs(別のタブで開く) ↗ / Keras: LSTM cell layer(別のタブで開く) ↗ / Pascanu, Mikolov, Bengio: On the difficulty of training Recurrent Neural Networks(別のタブで開く) ↗
Attentionは、参照する情報の配分を計算する
Attention(注意機構)は、今の出力や判断に使う情報を、どの部分からどれくらい受け取るか計算する仕組みです。翻訳なら、今作る語に関係する元の文の各部分の情報に係数を付け、組み合わせます。単に一つの位置番号を選んで、その語を丸ごとコピーする処理とは違います。この係数を、参照の重みやAttentionの重みと呼ぶことがあります。
参照の係数と、学習するパラメータを分けます。学習済みのモデルは、固定したパラメータを使っても、今の入力や出力対象が変われば違う参照係数を計算できます。係数が変わったというだけで、追加学習が行われたとはいえません。参照する情報の配分は、画像や語をどの種類へ分けるかというカテゴリ名でもありません。
AttentionはRNNと組み合わせることもできます。LSTMのセル状態の別名ではなく、人が意識して注意を向けることそのものでもありません。LSTMでは保持の通し方、Attentionでは今使う情報の参照配分を見る、という役割の違いを押さえましょう。両者を併用する構成もあるので、二者択一の製品分類にしません。
任意の数値例を読む
数値の小例:最大の一つを選ぶことと、組み合わせること
実際の言語の意味を一つの数値にした例ではありません。重み付きの組合せだけを見る説明用の一成分です。三つの情報の値を2、6、10、参照係数を0.5、0.25、0.25と仮定します。この例の係数の合計は1です。
- 2×0.5=1、6×0.25=1.5、10×0.25=2.5。
- 組み合わせた値=1+1.5+2.5=5。
最大係数の位置の値2だけを選ぶ場合とは違います。実際はベクトルの情報を組み合わせます。この5を、正解率や訳語の番号とは解釈しません。係数をどう求めるかのQuery/Key/Valueの詳説は後続の第2章へ分けます。
根拠:Bahdanau, Cho, Bengio: Neural Machine Translation by Jointly Learning to Align and Translate(別のタブで開く) ↗ / Vaswani et al.: Attention Is All You Need(別のタブで開く) ↗ / PyTorch 2.15: torch.nn.LSTM(別のタブで開く) ↗
Transformerは、Attentionを主要部品にした構造
Transformerモデルは、Attentionを主要な部品として組んだニューラルネットワークの構造です。Attentionという情報を参照して組み合わせる仕組みと、モデル構造全体の名前を分けます。基本のTransformerは、RNNのように前の状態を一つずつ次へ渡す構造を中心にはしていません。LSTMの状態の別名や、LSTMを単に高速化した呼び方ではありません。
基本のTransformerは、同じ並びの各部分の関係を計算するSelf-Attention(自己注意機構)や、位置ごとの変換などを組み合わせます。順序を扱うために、語の位置に関する情報も加えます。位置情報を加える処理そのものがAttentionなのではありません。また、位置の番号から元の文章を取り出す保存形式でもありません。
この節では、学習上の問題、保持を調整するLSTM、情報を参照するAttention、それを主要部品にしたTransformerを見分けるところまで扱います。Self-Attentionの具体的な計算、複数の参照、生成時に見てよい位置の制限、並列処理の詳細は第2章の担当です。現在の問題は、その詳説を読まなくてもこの節の説明で判断できます。
根拠:Vaswani et al.: Attention Is All You Need(別のタブで開く) ↗ / GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別のタブで開く) ↗
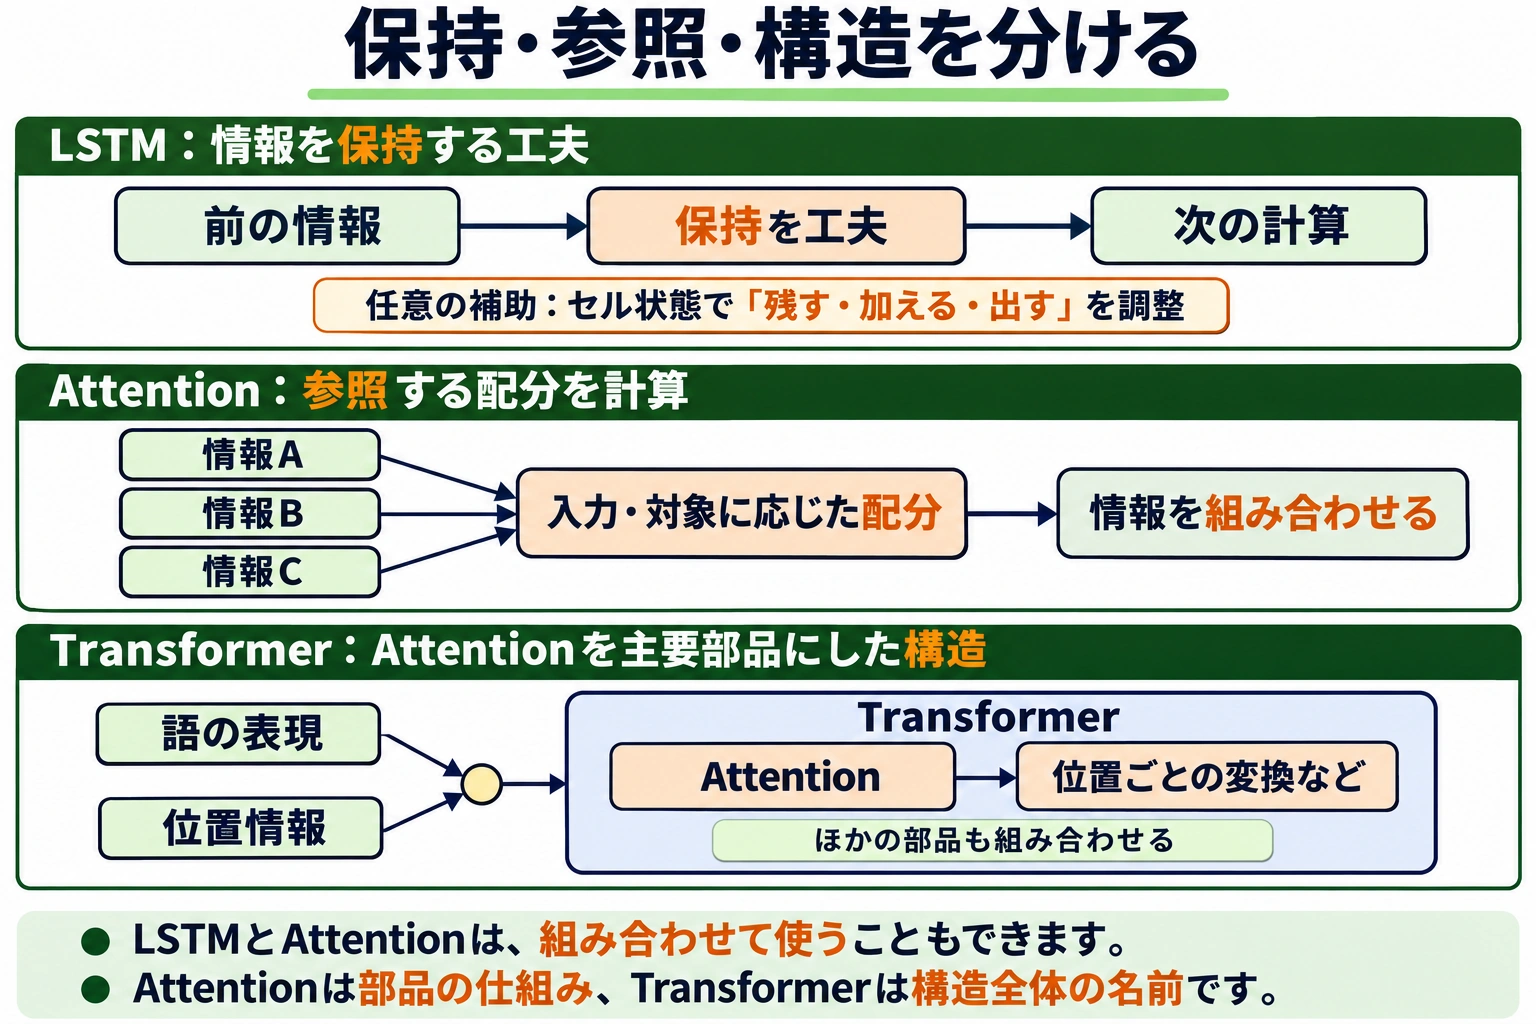 図を拡大する ↗
図の内容を文章で確認する
LSTMは情報を保持する工夫、Attentionは入力や対象に応じた参照配分、TransformerはAttentionを主要部品として他の部品も組み合わせる構造です。位置情報は語の表現へ別に加えます。LSTMとAttentionは併用できます。セル状態やゲートの細部は任意の補助です。
学習の仕組みを説明する自作概念図です。原著の図や実験結果の転載ではありません。
別の場面で確かめる
独自作成の確認問題です。基本問題と任意の補助問題を分けています。任意問題を開かなくても先へ進めます。
任意の理解確認 2(基本問題の集計とは別)
言葉にしてみる(採点なし)
長い説明の冒頭の条件を使いたいとき、『保持を調整する』『関連部分を参照する』『更新を抑える』は、それぞれ何をしているか説明してください。
解説と考え方を読む
LSTM、Attention、勾配クリッピングを対応させます。人が読み直したことからモデル内部の原因まで分かった、としていないかも確認します。
4内部の数値から画像を作る。VAEの潜在表現
数値を少し変えて別の図案ができたとき、その数値は何を表し、どこまで意味が分かるのでしょうか。
この節の学習目標
- 潜在ベクトルを、分類結果・ファイル番号・縮小画像と区別する。
- 一件を表す値の数としての次元と、データの件数を分ける。
- エンコーダ・潜在表現・デコーダの基本的な役割を説明する。
- 【任意の補助】入力画像に基づく再構成と基準分布からの生成、サンプリングのノイズを、条件を与えた図で追える。
- 【任意の補助】一つの値が一つの意味だけを表すと、少数の出力から決め付けない。
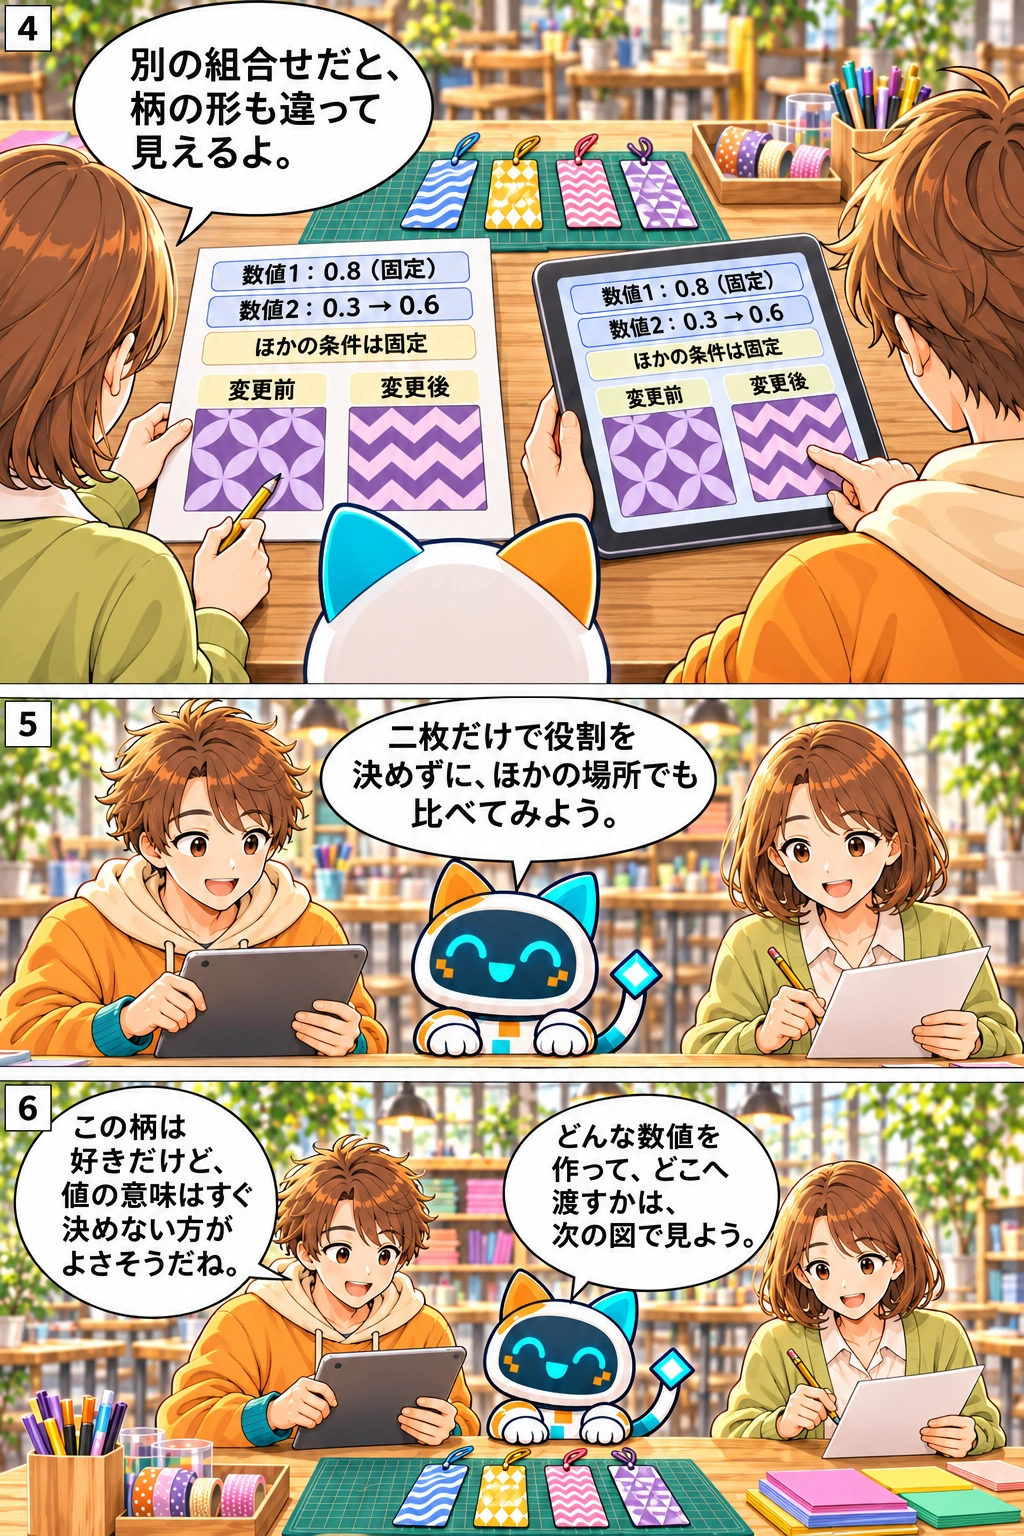
休日の地域のものづくりスペース。ハルとミオは、しおりに使う布模様の候補を架空の画像デモで比べます。一つの値を変えると色の濃さが変わり、ハルは『色だけのつまみかな』と思います。ほかの値の組合せでは柄の形も変わる例に気づき、数値の役割をすぐに決めずに調べることにします。
色だけのつまみ、なのかな
この話で学ぶこと:同じ条件の前後比較と別の地点の比較から、値の意味を決め過ぎない。
コマは上から下へ、横に並んだコマは右から左へ読みます。
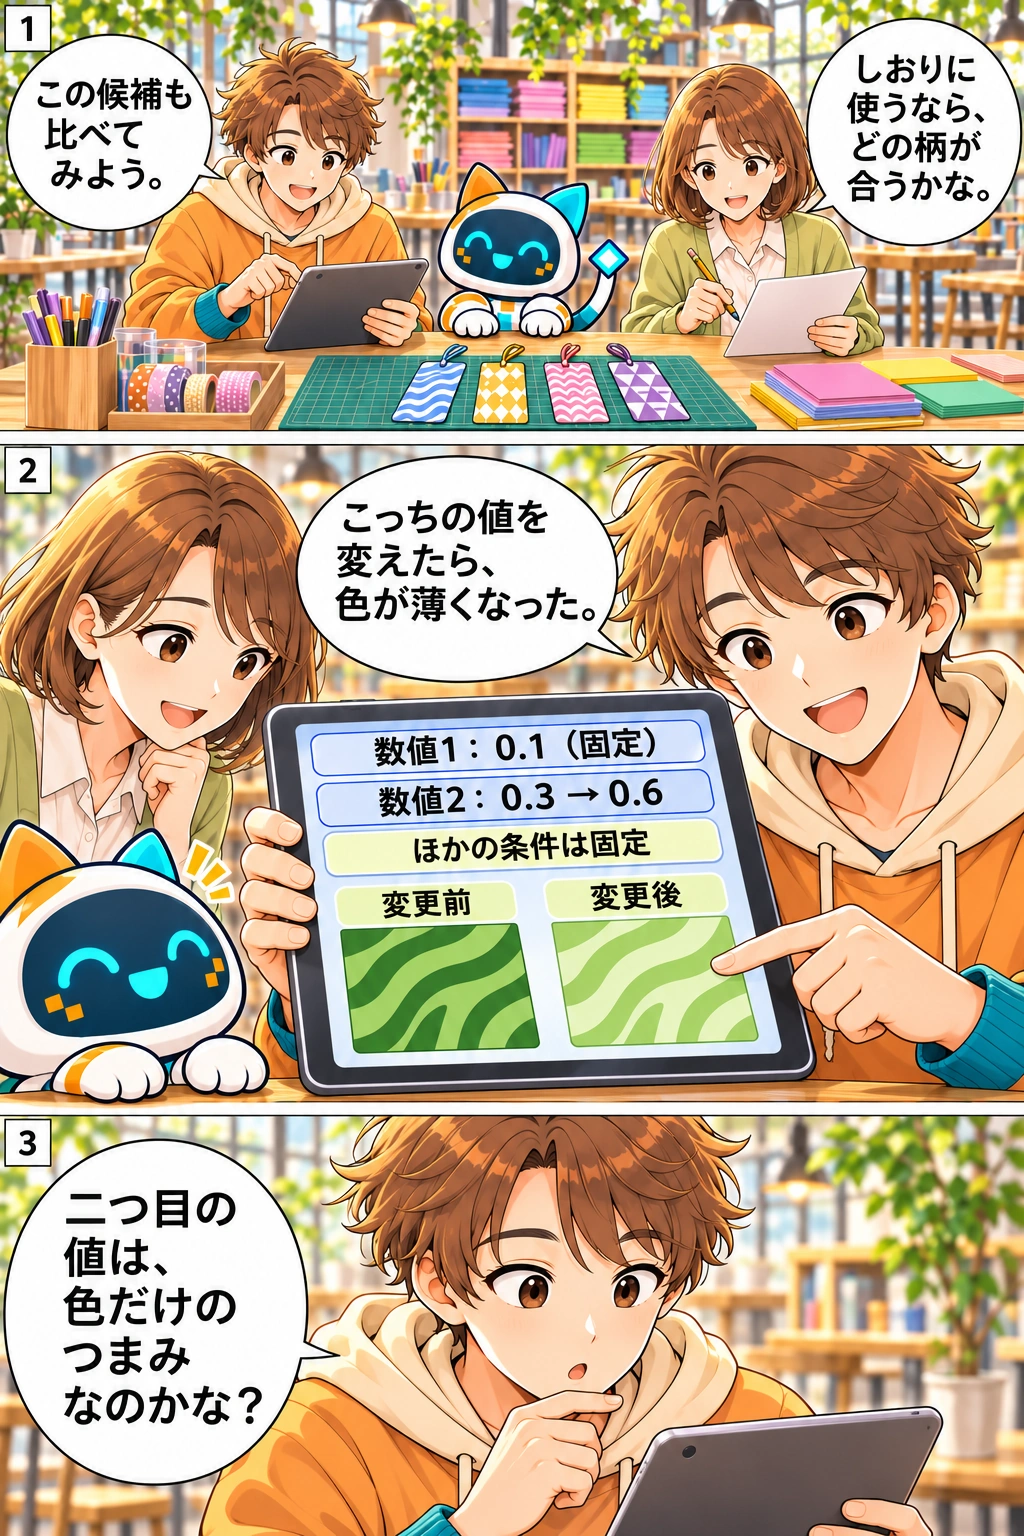
会話を文章で読む
場面:しおり作りの机で模様候補を眺める。
ミオ「しおりに使うなら、どの柄が合うかな。」
ハル「この候補も比べてみよう。」場面:ハルが「数値2」を変え、タブレットを三人に向ける。
ハル「こっちの値を変えたら、色が薄くなった。」場面:観察から意味を決めかける。
ハル「二つ目の値は、色だけのつまみなのかな?」場面:別の数値の場所での二枚を比較する。
ミオ「別の組合せだと、柄の形も違って見えるよ。」場面:少数の出力から一般化しない確認へ。
ビット「二枚だけで役割を決めずに、ほかの場所でも比べてみよう。」場面:好みの候補と、内部表現の理解を分けて次へ進む。
ハル「この柄は好きだけど、値の意味はすぐ決めない方がよさそうだね。」
ビット「どんな数値を作って、どこへ渡すかは、次の図で見よう。」
漫画で見たのは、同じ仕組みに違う数値を渡すと候補が変わることと、少ない例から値の意味を決め過ぎない判断です。画面の見た目だけでデモの内部方式を特定したわけではありません。ここからは代表的な画像用VAEを、入力を表し直す部分、数値を選ぶ部分、出力を作る部分へ分けて説明します。
漫画の比較条件:同じ学習済みデコーダを使い、追加の乱数や表示方法など、潜在ベクトル以外を固定した架空の説明デモです。最初は数値1を0.1、次は0.8で固定し、どちらも数値2を0.3から0.6へ変えています。実モデルの実験結果ではありません。
潜在ベクトルは、出力に使う内部の表現
値を順にまとめたものをベクトルと呼びます。潜在ベクトルは、画像などの内容をモデルの内部で表す数値のまとまりです。ここでの『潜在』は、元画像に見える画素とは別の内部表現、という意味です。元画像の保存場所を指す番号や、縮小表示した画像の画素そのものとは区別します。
エンコーダは入力を別の表現へ写す部分、デコーダは内部の表現から出力を作る部分です。画像を表す内部の数値から、元に近い画像を作り直すことを再構成、または復元と呼びます。元の画素をファイルからそのまま取り出すコピーや、表示倍率を戻すだけの処理ではありません。再構成しても、元のすべての細部が同じになる保証はありません。
同じように数値が並んでいても、何のための値かは構成によります。種類ごとの確率を出してカテゴリを選ぶ分類結果と、学習済みデコーダへ渡して画像を作る内部表現は別です。値の個数だけを見て、分類の確率や画像ファイルの番号だとは決めません。この節のデコーダは、潜在ベクトルを使って出力を作るよう学習した部分です。
根拠:Kingma, Welling: Auto-Encoding Variational Bayes(別のタブで開く) ↗ / Keras: Variational AutoEncoder(別のタブで開く) ↗
次元は、一件を表す値の数
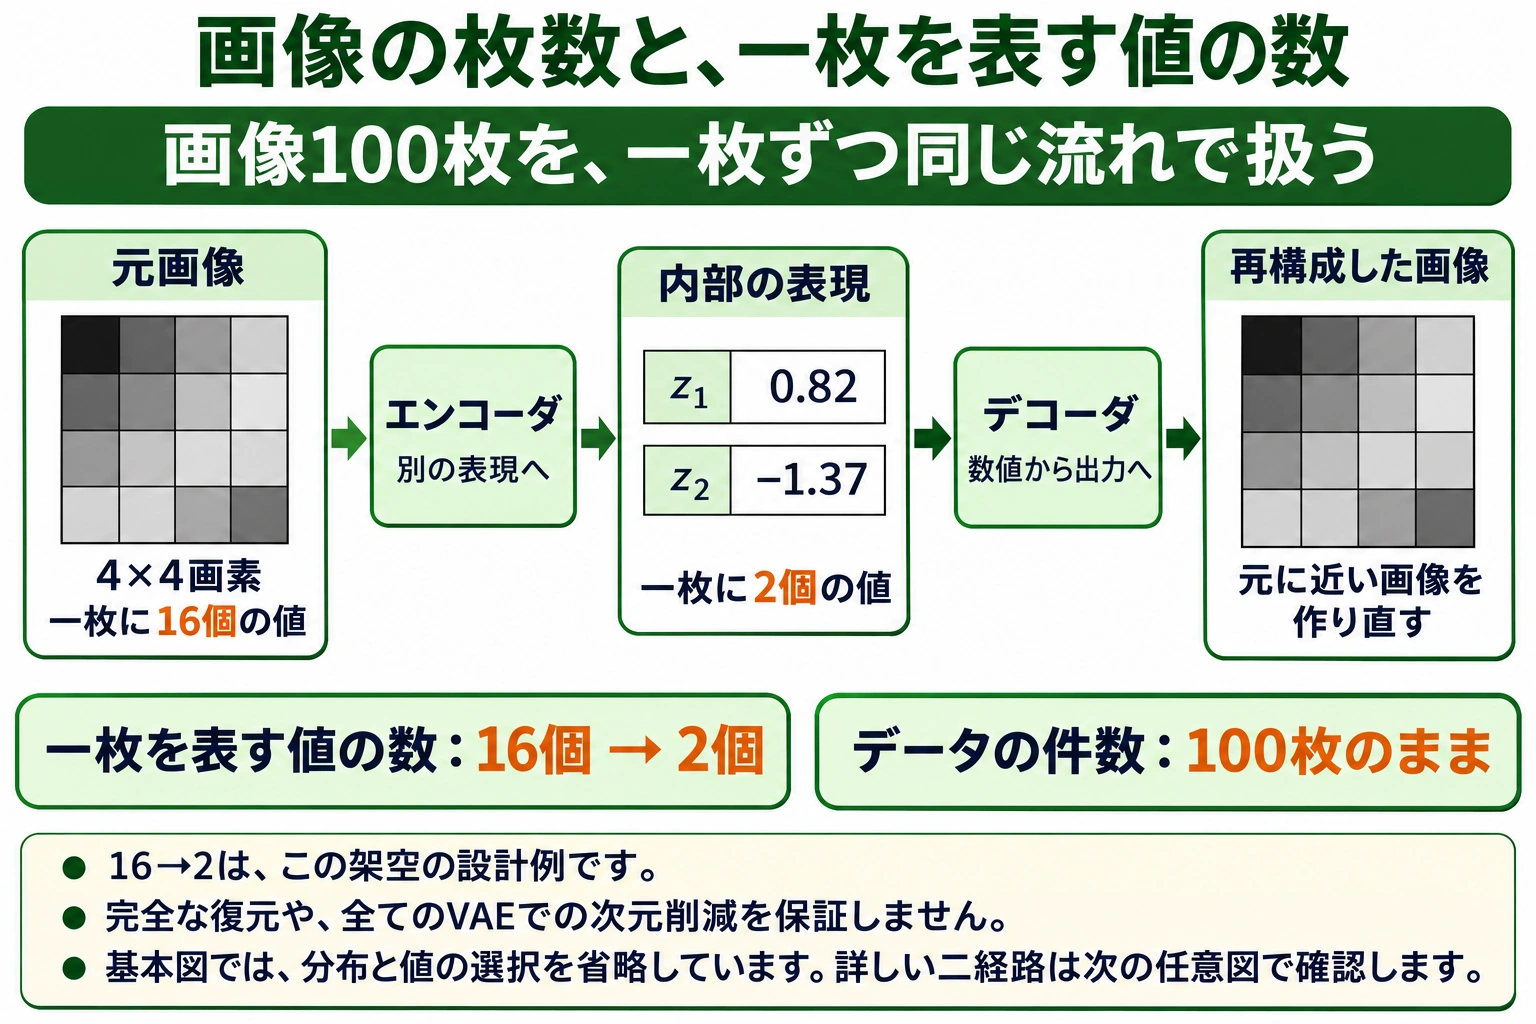
この節でいう次元は、一件のデータを表す値の数です。例えば、白黒の4×4画素を各画素一つの濃淡値で表す画像なら、一枚に16個の値があります。その一枚に対応する内部表現を2個の数値へまとめる設計は、次元削減の一例です。画像の件数が100枚なら、件数100と、一枚を表す値の数16→2は別の軸です。
次元削減は、データの枚数を減らすことや、画像をいくつかの種類へ分類することではありません。また、潜在ベクトルは低い解像度へ縮めた画像そのものとも限りません。値を少なくする過程では情報が失われることもあり、少数の値にしたことから元の全情報を正確に戻せるとはいえません。すべてのVAEが入力より少ない次元でなければならない、という定義にも広げません。
数える軸を分ける
白黒4×4画素、1画素1値、画像100枚、潜在ベクトル2値という架空の設計です。
- 入力の一枚の値の数=4×4=16。
- 潜在ベクトルの一枚当たりの値の数=2。
- 画像の件数=100枚。エンコードしたことだけでは100枚が2枚になるわけではありません。
件数と一件の表現の長さを分けます。16→2はこの例の設計で、圧縮率や再構成の品質を全VAEへ共通化しません。
根拠:GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別のタブで開く) ↗ / Keras: Variational AutoEncoder(別のタブで開く) ↗ / Kingma, Welling: Auto-Encoding Variational Bayes(別のタブで開く) ↗
 図を拡大する ↗
図の内容を文章で確認する
画像は100枚のまま。1枚を表す値は16個から2個になります。白黒の4×4画素を、1画素につき1個の濃淡値で表す架空例です。
この例では画像を1枚ずつエンコーダで表し直します。図の z1=0.82、z2=−1.37 は説明用の仮の値です。デコーダにこの2成分を渡して、元に近い画像を作ります。
基本図では分布と値の選択を省略しています。後の任意図で二つの経路を比べられます。次元の選び方や再構成の精度は設計によって異なります。
学習の仕組みを説明する自作概念図です。原著の図や実験結果の転載ではありません。
VAEは、分布から潜在ベクトルを選ぶ
VAE(変分オートエンコーダ)は、潜在表現を確率的に扱う生成モデルです。確率分布は、どんな値がどれくらい現れ得るかを表すものです。分布に従って値を選ぶことをサンプリングと呼びます。代表的な画像用VAEでは、エンコーダが入力に対応する分布の中心や広がりを求めます。出力を『一つの数値へ固定しない』とだけ説明すると、ベクトル全体と一成分を取り違えるため、分布から一組の値を選ぶ、と考えます。
任意の仕組み・計算を読む
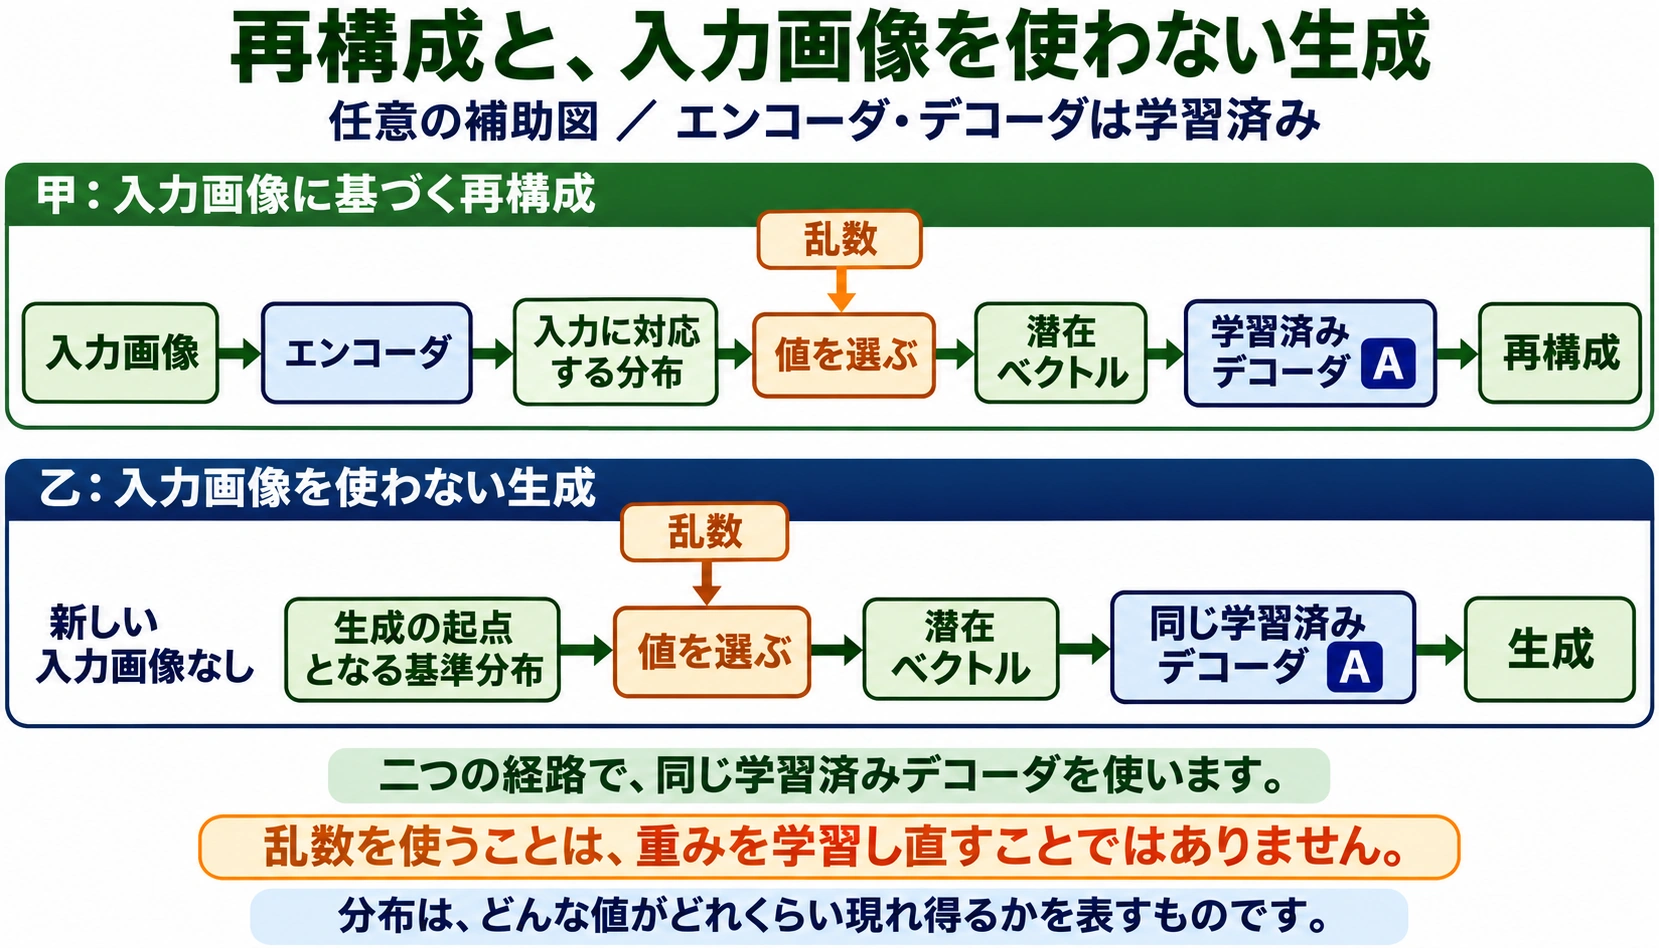
入力画像に基づく再構成では、まずその画像をエンコーダへ渡します。得られた分布から潜在ベクトルを選び、学習済みデコーダへ渡して画像を作ります。デコーダが元の画像ファイルの場所を探したり、分類名に対応する用意済み画像を取り出したりする流れではありません。
任意の仕組み・計算を読む
学習後の生成では、新しい入力画像をエンコーダへ渡さず、生成の起点としてあらかじめ決めた潜在変数の基準分布から潜在ベクトルを選んで、同じ学習済みデコーダへ渡す方法も使えます。この基準分布は、入力ごとにエンコーダが作る分布とは分けます。元画像の保存場所の一覧やカテゴリ名の抽選表でもありません。この流れでも、数値から出力を作るために学習したデコーダが必要です。
任意の仕組み・計算を読む
VAEの学習では、入力を再構成することと、入力に対応する潜在分布を基準の分布へ近づけることの両方を考えます。一方、学習済みモデルで潜在ベクトルを選び、デコーダへ渡して出力を作るだけの操作は、重みを更新する追加学習とは分けます。同じデコーダでも、渡す潜在ベクトルが違えば出力は変わり得ます。
根拠:Kingma, Welling: Auto-Encoding Variational Bayes(別のタブで開く) ↗ / Keras: Variational AutoEncoder(別のタブで開く) ↗
ノイズは、入る場所と役割を見る
ノイズという語は、撮影した画像に混ざる乱れにも、計算で使うランダムな要素にも使われます。名前だけで役割を決めません。代表的なVAEのサンプリングで使う乱数は、潜在表現を分布から選ぶための要素です。撮影で乱れた画素の位置を指定して削除する番号とは別です。
任意の仕組み・計算を読む
この節の計算例は、入力ごとの潜在分布を正規分布で表す代表的な構成に限ります。正規分布は中心の近くが現れやすい左右対称な分布で、中心を表す平均μと、ばらつきの大きさを表す標準偏差σを使います。各成分について、中心0・標準偏差1の標準正規分布から選んだ乱数εを使い、z=μ+σ×εとすると、その入力に対応する分布から値を選べます。μやσは入力から計算し、εは別に選ぶランダムな値です。実装が分散の対数を出す場合は、そこから標準偏差へ変換して使います。
この乱数は正解カテゴリの教師ラベルでも、重みを変更する更新量でもありません。ランダムな数値を渡したことだけでモデルを学習し直したとはいえず、乱数だけで目的に合う画像を作れるわけでもありません。学習したエンコーダ/デコーダと分布の扱いを組み合わせる仕組みです。
任意の数値例を読む
数値の小例:一組の潜在表現を作る
二成分の独立した正規分布で近似する説明例です。μ=(1, −1)、σ=(0.5, 2)、今回選んだε=(2, −0.5)とします。すべて単位なしで、成分ごとに計算します。
- 第1成分:z1=1+0.5×2=2。
- 第2成分:z2=−1+2×(−0.5)=−2。
- 今回選ばれた潜在ベクトルはz=(2, −2)。これを学習済みデコーダへ渡します。
元画像二枚を選んだのではなく、一件に対応する内部表現の二つの値です。別のεなら別のzになり得ます。εを画像の欠損位置や重み更新量とは読みません。この小例はVAEの学習全体や生成品質の計算ではありません。
根拠:Kingma, Welling: Auto-Encoding Variational Bayes(別のタブで開く) ↗ / Keras: Variational AutoEncoder(別のタブで開く) ↗
任意の補助図:再構成と生成の二経路を見る
 図を拡大する ↗
図の内容を文章で確認する
任意の補助図です。甲は入力画像→学習済みエンコーダ→入力に対応する分布→値を選ぶ→潜在ベクトル→学習済みデコーダA→再構成。乙は新しい入力画像なしで、生成の起点となる基準分布→値を選ぶ→潜在ベクトル→同じ学習済みデコーダA→生成。両経路で乱数は値の選択へ入ります。乱数を使うことは重みの再学習ではありません。
学習の仕組みを説明する自作概念図です。原著の図や実験結果の転載ではありません。
任意の補助:一つの値の意味を、二枚だけで決めない
一つの値の意味を、二枚だけで決めない
潜在ベクトルの各成分が、そのまま『色』『袖の長さ』のような人の付けた特徴名に一対一で対応するとは限りません。この節の例では、各成分を特定の意味だけへ対応させる制約を与えていません。数値のまとまりを使って出力を作ることと、一成分の意味が独立に分かったことを分けます。
この比較では、学習済みデコーダ、出力時に追加の乱数を使う場合はその条件、表示方法など、潜在ベクトル以外を固定したとします。一つの成分を変えて二枚の色が変わったなら、その比較条件で出力の見え方が変わったとはいえます。しかし、まだ見ていない数値の場所でも色だけが変わる、他の成分は形を担当する、とまでは二枚から決められません。入力する潜在ベクトルが変わったことを、デコーダの再学習が行われた証拠にもしません。
意味を確かめたいなら、デコーダや他の成分、追加の乱数などの条件を固定し、複数の値や別の場所でも何が変わるかを比較します。その確認をしても、使う範囲を超えた保証へ広げません。ここではモデルの表現と結果の読み方までを扱い、潜在表現の意味を分離するための専門的な設計や評価は必須にしません。
根拠:Kingma, Welling: Auto-Encoding Variational Bayes(別のタブで開く) ↗ / Locatello et al.: Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations(別のタブで開く) ↗
別の場面で確かめる
独自作成の確認問題です。基本問題と任意の補助問題を分けています。任意問題を開かなくても先へ進めます。
任意の理解確認 3(基本問題の集計とは別)
任意の理解確認 4(基本問題の集計とは別)
任意の理解確認 5(基本問題の集計とは別)
任意の振り返り:二つの経路を説明する
言葉にしてみる(採点なし)
入力画像からの再構成と、新しい入力画像を使わない生成を比べましょう。それぞれの分布がどこから来るか、どちらでエンコーダを使うか、潜在ベクトルを選んだ後は何をするかを説明してください。
解説と考え方を読む
再構成では、入力画像をエンコーダに渡し、その画像に対応する分布から潜在ベクトルを選びます。新しい入力画像を使わない生成では、あらかじめ決めた基準分布から選びます。両方とも、選んだ潜在ベクトルを同じ学習済みデコーダに渡します。
乱数は分布から値を選ぶときに使います。成分と画像の見え方の対応は、他の条件をそろえて別に確かめます。
5作る側と見分ける側を学習する。GAN
画像を作るモデルは、見分けるモデルの評価をどう学習に使うのでしょうか。
この節で使う言葉:GAN(敵対的生成ネットワーク)・生成器(Generator)・識別器(Discriminator)
この節の学習目標:生成器と識別器の入力・出力・学習の目的を分け、VAEの再構成との違いを説明する。
休日の文具店の包装紙展示で、二つの処理で学んだ架空の模様案の説明カードを見比べる。
柄を作る側、見分ける側
この話で学ぶこと:作る側と見分ける側の出力・学習目的・利用時を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
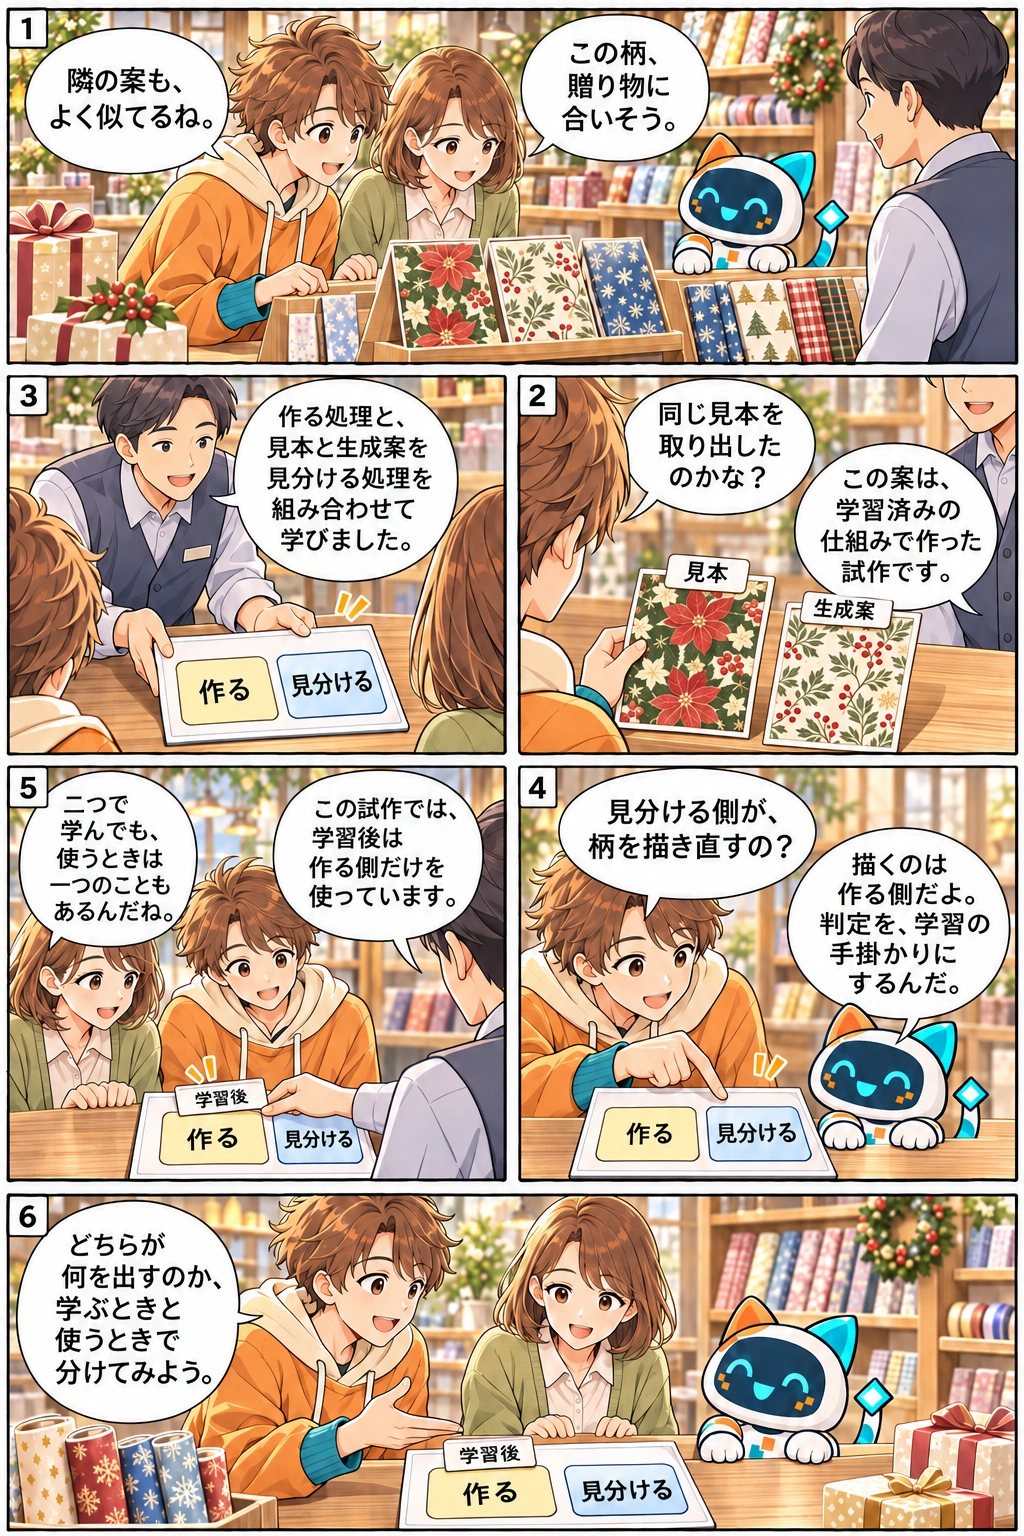
会話を文章で読む
場面:横長の引き。二人が包装紙の見本へ歩み寄る
ミオ「この柄、贈り物に合いそう。」 ハル「隣の案も、よく似てるね。」場面:ハルの肩越しで2枚の模様カード。「見本」「生成案」の短い札
ハル「同じ見本を取り出したのかな?」 店員「この案は、学習済みの仕組みで作った試作です。」場面:店員が説明カードを机へ置く。斜め上から、別々の箱「作る」「見分ける」
店員「作る処理と、見本と生成案を見分ける処理を組み合わせて学びました。」場面:目線の高さの寄り。ハルが右の人差し指でカードの「見分ける」箱を示す
ハル「見分ける側が、柄を描き直すの?」 ビット「描くのは作る側だよ。判定を、学習の手掛かりにするんだ。」場面:奥からの逆方向。店員が「学習後」の小カードを横へ移す
店員「この試作では、学習後は作る側だけを使っています。」 ミオ「二つで学んでも、使うときは一つのこともあるんだね。」場面:客側の少し引いた画。二人が2箱のカードを見直す
ハル「どちらが何を出すのか、学ぶときと使うときで分けてみよう。」
店頭の模様案は架空の場面です。人の店員の講評を、そのままGANの識別器と呼ぶ説明ではありません。ここから、二つのモデルの入力・出力・学習目的を図で分けます。
新しい画像を作るモデルと、実例から来た画像かを見分けるモデルを組み合わせます。二つのモデルが、何を入力にして何を出すかを分けます。
生成器は新しい候補を作り、識別器は出所を見分ける
架空の布の模様を作る例を考えます。生成器(Generator)は、新しい模様の画像を作るモデルです。ここで扱う基本の構成では、ランダムな数値を入力し、学習した模様の傾向に合う画像を出します。実例の写真を一枚取り出して返す処理とは区別します。
識別器(Discriminator)は、画像が実例のデータから来たものか、生成器が作ったものかを見分けるモデルです。実例の模様と生成された模様の両方を入力として受け取り、どちらに当たるかの判定に使う値を出します。画像の画素を作るのは生成器、出所を見分けるのは識別器という役割です。
ここでいう「実例」は、学習に使うデータから来た画像という意味です。識別器が画像を実例に近いと評価しても、画像内の出来事が実際に起きたか、商品が販売されているかまで証明するものではありません。
根拠:Goodfellow et al.: Generative Adversarial Nets(別タブで開く) ↗ / TensorFlow: Deep Convolutional Generative Adversarial Network(別タブで開く) ↗
GANは、二つの異なる目的を組み合わせる
GAN(敵対的生成ネットワーク)は、生成器と識別器を組み合わせて学習する生成モデルです。識別器は、実例と生成されたものを正しく見分けるよう学習します。生成器は、自分の出力が識別器から実例側と判断されるよう学習します。同じ画像を同じ目的で分類する二つのモデルという説明とは違います。
例えば、識別器が生成画像を見分けた結果を使い、生成器側の重みを調整します。また、生成器の出力が変われば、識別器も実例との違いを見分けるよう調整します。基本の学習では、二つの更新を繰り返します。「敵対」は学習の目的の関係を表し、二つのモデルが人のように相談したり、勝ち負けを理解したりするという意味ではありません。
二つを組み合わせただけで、学習が順調に進み、いろいろな模様を作れるとは限りません。例えば、見分ける側が作る側に対して強過ぎる場合は、生成器へ十分な学習の手掛かりが得られないことがあります。学習の条件と、生成結果の偏りや品質を確認します。
根拠:Goodfellow et al.: Generative Adversarial Nets(別タブで開く) ↗ / TensorFlow: Deep Convolutional Generative Adversarial Network(別タブで開く) ↗
VAEの流れと、GANの学習時・利用時を比べる
この教材のVAEでは、入力から潜在表現の分布を求め、その表現から元に近い出力を作る再構成も使って学習しました。GANでは、生成器と識別器の異なる目的を組み合わせることが中心です。基本のGANを説明するために、各入力画像をエンコーダで写してから復元する流れが必須になるわけではありません。
学習後、模様候補を作る利用時には、学習済みの生成器だけへランダムな数値を渡して画像を作る構成もあります。利用時に識別器を動かさないから、学習もGANではなかった、と判断しないようにします。学習時の二者の役割と、利用時にどの部分を動かすかは別です。
生成器を含むモデルすべてがGANというわけではありません。また、GANの識別器が存在することを理由に、全体の目的を「画像をカテゴリへ分けるだけのAI」とするのも不適切です。部品の役割と、モデル全体が何を作るかを分けて考えます。
根拠:Goodfellow et al.: Generative Adversarial Nets(別タブで開く) ↗ / Kingma, Welling: Auto-Encoding Variational Bayes(別タブで開く) ↗ / TensorFlow: Deep Convolutional Generative Adversarial Network(別タブで開く) ↗
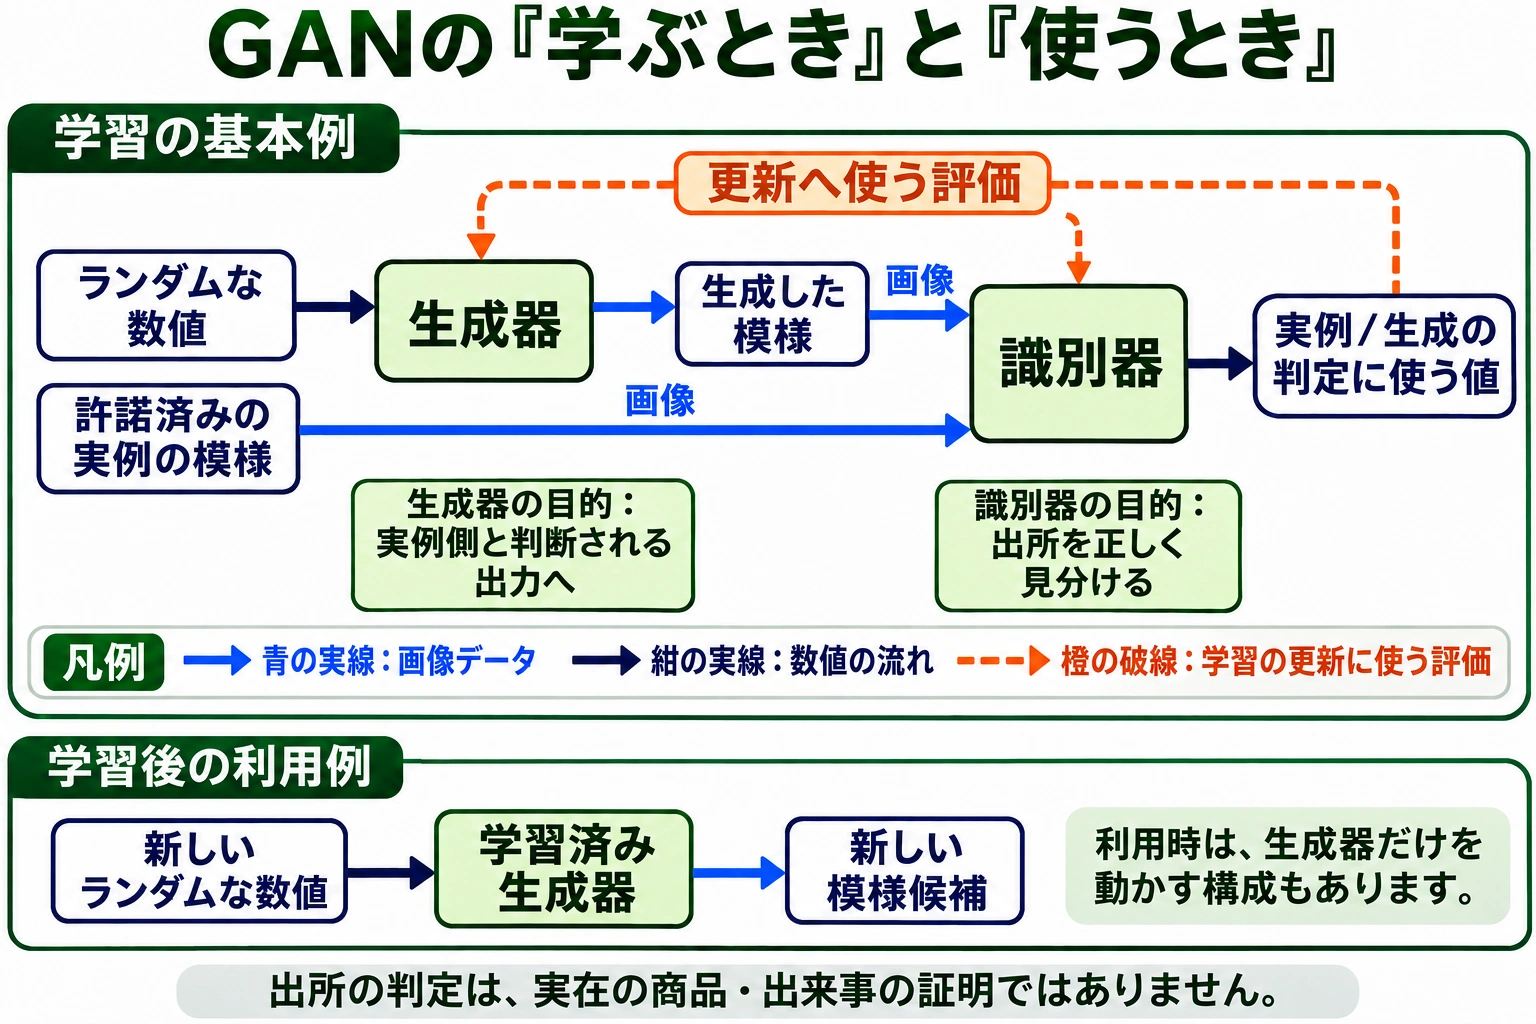 図を拡大する ↗
図の内容を文章で確認する
- ランダムな数値を生成器へ渡し、模様候補を作る。
- 実例の模様と生成した模様を識別器へ渡し、出所の判定に使う値を出す。
- 識別器は、実例と生成画像を見分けるよう重みを調整する。
- 生成器は、出力が実例側と判断されるよう識別器の評価を使って重みを調整する。
学習が終わった後は、生成器だけを動かして新しい候補を作る構成もあります。識別器の評価は、現実の出来事や商品の存在を証明しません。
矢印はデータを渡す流れと、学習の評価を使う関係を区別して示します。識別器が生成画像そのものを描き直す図にしません。
別場面:架空の壁紙の模様案を作る
壁紙の模様データと、生成器が作った模様を識別器へ渡します。識別器はデータから来た模様かを見分け、生成器はその評価を使って、実例側と判断されやすい模様を作るよう学習します。
学習後に生成器だけを利用へ組み込み、候補画像を出す構成も考えられます。識別器が画像の画素を作るわけではありません。また、実例に似た候補でも、壁紙として使える模様か、人は用途に合わせて確認します。
別の場面で確かめる
独自作成の問題です。本文の考え方を条件に当てはめてみましょう。
言葉にしてみる(採点なし)
GANの学習時に、生成器と識別器がそれぞれ何を出し、何を改善するか説明してください。
6種類を選ぶ仕事と、内容を作る仕事
AIの名前や入力だけでなく、どんな出力を求めているかで区別できるでしょうか。
この節で使う言葉:識別系AI・生成系AI・ディープフェイク
この節の学習目標:カテゴリなどを判断する処理と内容を作る処理を分け、自然に見える姿や声を本人の事実と混同しない。
当日、美術館へ向かう公園で、転送された本日の休館案内風動画の出所と対象日を確かめる。
自然な動画。それは本人の発信?
この話で学ぶこと:自然な姿や声と、本人が発信した事実を分け、出所と時点を確かめる。
コマは上から下へ、横に並んだコマは右から左へ読みます。
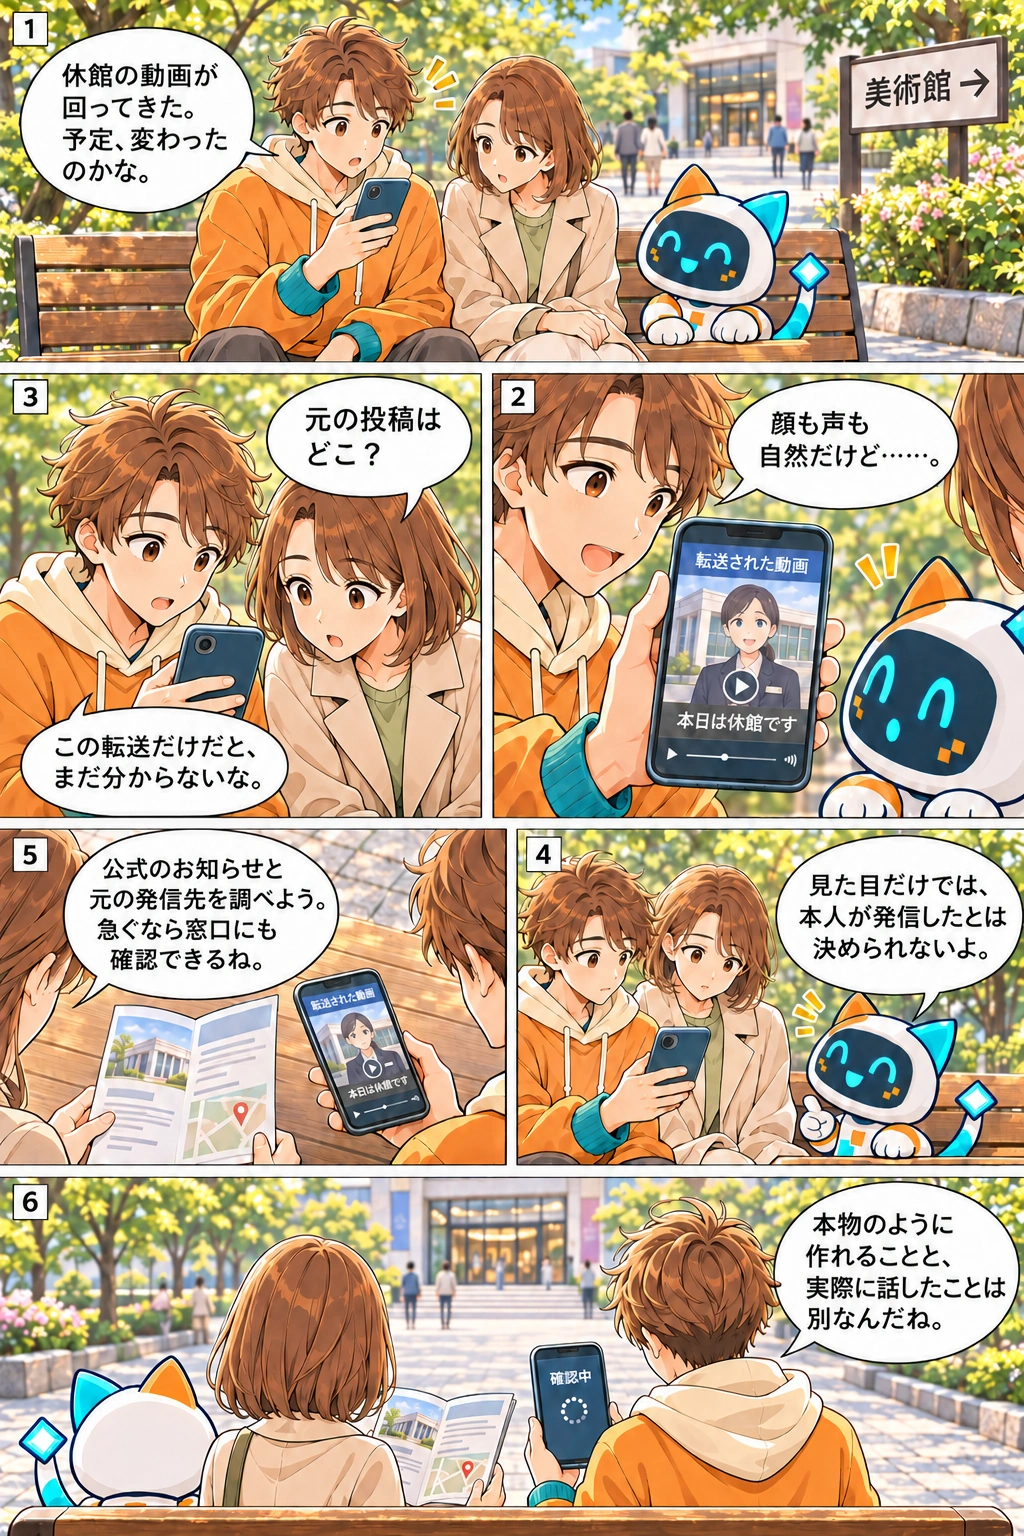
会話を文章で読む
場面:公園と美術館の案内板が分かる縦長の引き。端末通知で足を止める
ハル「休館の動画が回ってきた。予定、変わったのかな。」場面:ミオとビットにも向けた端末の寄り。「転送された動画」、匿名係員と「本日は休館です」の字幕
ハル「顔も声も自然だけど……。」場面:ミオの寄りから端末へ視線。元投稿欄を探す
ミオ「元の投稿はどこ?」 ハル「この転送だけだと、まだ分からないな。」場面:全員へ向いた端末をハルが保った手元を含む中景
ビット「見た目だけでは、本人が発信したとは決められないよ。」場面:パンフレットと端末を一緒に見られる俯瞰。連絡先は図形のダミー
ミオ「公式のお知らせと元の発信先を調べよう。急ぐなら窓口にも確認できるね。」場面:立ち止まって調べる二人の肩越し。結論欄は「確認中」
ハル「本物のように作れることと、実際に話したことは別なんだね。」
この場面では動画が合成だったかはまだ分かりません。自然な姿や声から本人の発言と決めず、出所と内容を照合する行動に気づくための例です。識別の出力、生成した内容、現実の事実という三つを区別して読み進めます。
同じ画像を扱う機能でも、分類結果を出す仕事と、新しい画像・文章を作る仕事では目的が違います。人の姿や声に似た内容を見たときの確認にもつなげます。
識別系AIは、入力について判断する
識別系AIは、与えられた入力がどの種類に当たるかなどを判断する目的のAIです。例えば、写真にある建物を「橋・トンネル」に分ける、メールを「新規申込み・取消」に分ける課題が当たります。入力から用意したカテゴリ、つまり種類を選ぶ課題を分類と呼びました。
結果が数値でも、種類ごとの可能性を表す値なら、分類へ使えます。また、「橋の写真です」という定型文を表示していても、実際の処理が種類の判定と決めておいた表示なら、文章を生成したとまではいえません。画面に自然な文が出たことと、内容を生成する処理は別です。
CNNは画像を分類するモデルに使えますが、名前だけで目的を決めません。GANの識別器は、その中で出所を見分ける役割を持つ部品です。GAN全体の生成の目的と、識別器の判定の役割は分けます。
根拠:Google Developers: Machine Learning Glossary(別タブで開く) ↗ / Goodfellow et al.: Generative Adversarial Nets(別タブで開く) ↗ / TensorFlow: Convolutional Neural Network (CNN)(別タブで開く) ↗
生成系AIは、学習した傾向を使って内容を作る
生成系AIは、学習したデータの傾向などを使い、画像・文章・音声といった内容を作る目的のAIです。例えば、説明から架空の花の画像を作る、資料から説明文を作る課題が当たります。VAEやGANは、生成を行うモデルの例でした。
画像を入力しても、出力が「橋」という種類なら分類です。同じ画像から新しい説明文や画像を作るなら、生成を含む処理として考えます。入力が画像か文章かだけで区別せず、求める出力を見ることが大切です。構造の名前と、識別・生成という目的の区分も同じ軸ではありません。
生成された内容は、参考資料や候補として役立つ場合がありますが、自然な見た目や表現が、事実に一致する証拠にはなりません。例えば、存在しない施設の写真や、本人が話していない音声を作れるからです。何を確認してから使うかを、用途に合わせて決めます。
根拠:Google Developers: What is Machine Learning? — Generative AI(別タブで開く) ↗ / Kingma, Welling: Auto-Encoding Variational Bayes(別タブで開く) ↗ / YouTube Official Blog: How we're helping creators disclose altered or synthetic content(別タブで開く) ↗
ディープフェイクでは、姿や声と本人の事実を分ける
生成や加工の技術では、人に似た姿や声を作ることもできます。ディープフェイクは、深層学習などを使って画像・動画・音声を生成・加工し、実際のもののように見せる技術や内容を指す言葉です。特に、実在する人の顔を置き換えたり、その人の声に似せたりする例があります。架空の花を描いた画像が、すべて本人へのなりすましになるわけではありません。
例えば、店の担当者が休業を知らせるように見える動画でも、本人が実際に撮影・発信したとは限りません。顔や口元が自然、声が似ている、画像の人物名が一致するといったことだけでは、話した内容まで確認できません。元の発信先や店の公式案内など、内容を確かめられる情報と照合します。合成の表示がないことも、実際の撮影映像である証明にはなりません。 元の発信日時と、休業などが対象にしている日もそろえて確認します。動画内のリンクや電話番号だけに頼らず、以前から把握している公式サイトや案内にある窓口から確かめます。確認できなければ、本人の発信や内容の真偽は未確認のままです。
作る側としては、架空の素材と、実在人物に似せた素材で、必要な確認を分けます。本人の同意、元の素材の利用条件、用途や公開範囲、閲覧者が本物の発言と受け取らない表示などを確認します。同意があることだけで、素材や公開に関する条件まで満たしたとは判断しません。
この節では、作れること、本人の実際の言動、利用できる条件を分けるところまで学びます。権利や契約の具体的な判断、公開先の規則の詳細は、後続のリスク・利用条件の教材で扱います。
根拠:GUGA 生成AIパスポート試験シラバス(2027年2月試験より適用)(別タブで開く) ↗ / YouTube Official Blog: How we're helping creators disclose altered or synthetic content(別タブで開く) ↗ / Google Official Blog: How Google helps others track frauds and scams online(別タブで開く) ↗ / FTC: Scammers use AI to enhance their family emergency schemes(別タブで開く) ↗ / IPA:ん?あやしいと思ったら立ち止まれ(別タブで開く) ↗
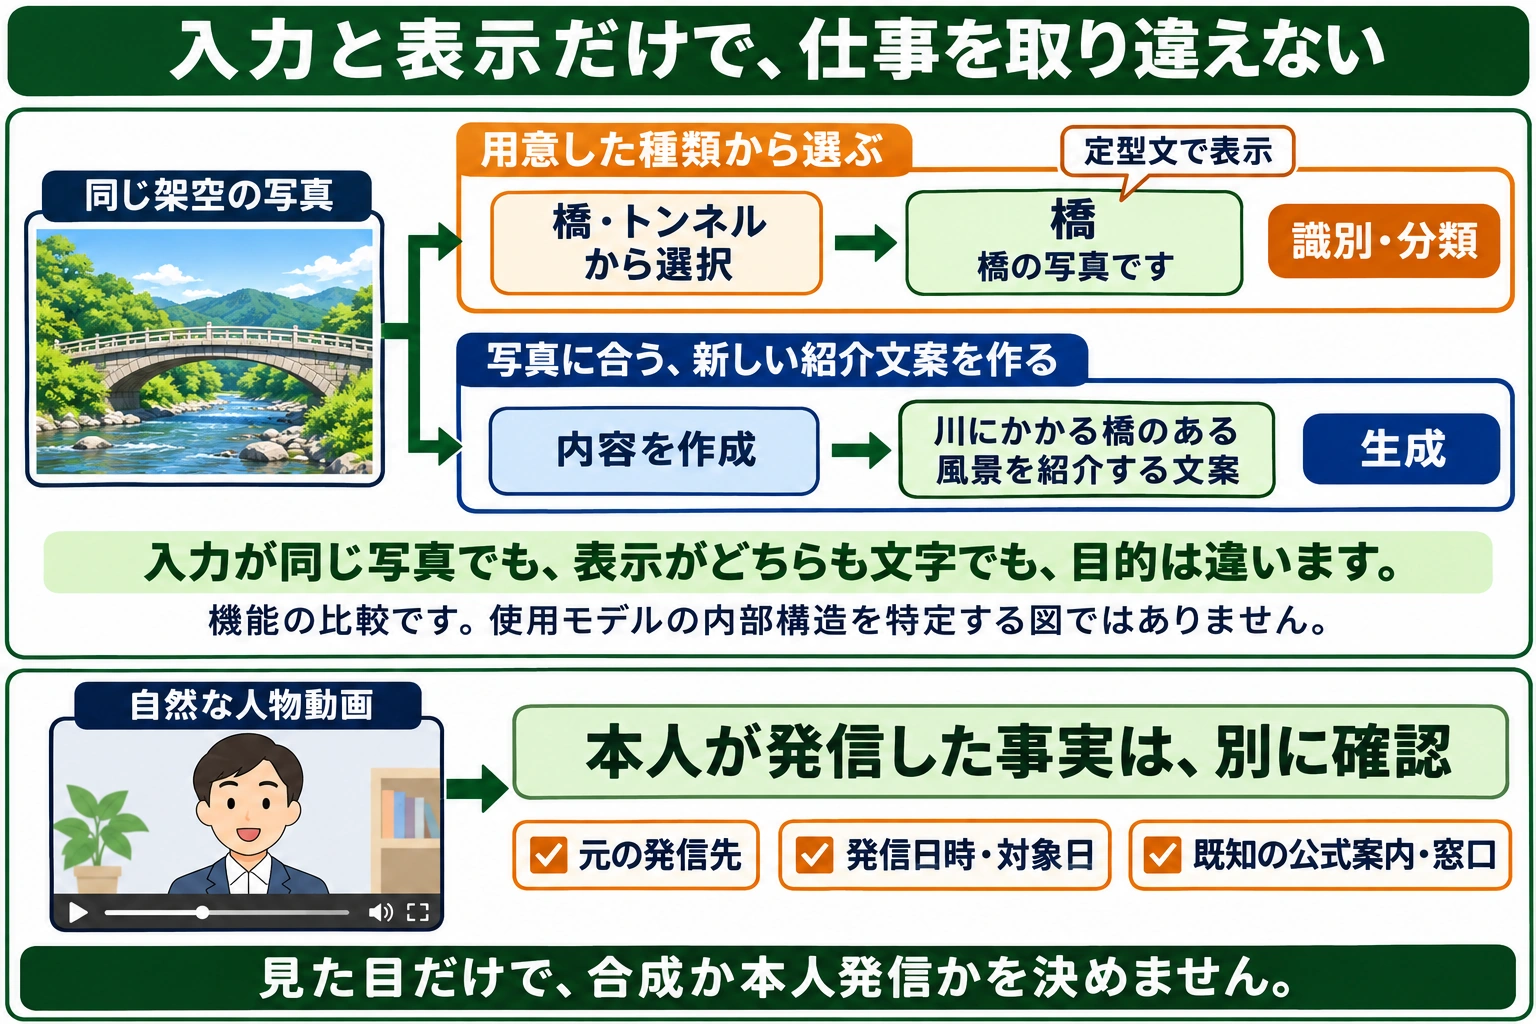 図を拡大する ↗
図の内容を文章で確認する
同じ架空の建物写真を入力する二つの機能を比べます。
- 用意した「橋・トンネル」から種類を選び、「橋の写真です」という定型文で表示
- カテゴリを判断する識別・分類の課題。
- 同じ写真に合わせ、新しい紹介文の案を作る
- 内容を作る生成の課題。
入力が同じ写真でも、表示がどちらも文字でも、処理の目的は違います。これは機能の比較で、使われたモデル構造を特定する図ではありません。
自然な人物動画は、本人が発信した事実とは別に確認します。元の発信先、発信日時と対象日、以前から把握している公式案内や窓口を照合します。見た目だけで合成か本人発信かを決めません。
構造と目的は別の比較軸です。識別結果や生成結果を、本人の発言や現実の出来事の証明に読み替えません。
別場面:展示の案内機能を二つ比べる
美術館の機能Aは、来館者が選んだ作品写真を用意した作品カテゴリへ分けます。機能Bは、その写真に合わせた新しい紹介文の案を作ります。入力が写真でも、Aは種類を判断する課題、Bは内容を作る課題です。
さらに、案内担当者がその紹介文を話すような合成動画を作るなら、本人が実際に話した映像とは分けて扱います。本人や素材の利用条件、公開の条件、合成であることが分かる伝え方を確認します。紹介文の事実も、作品の資料に照らして確かめます。
別の場面で確かめる
独自作成の問題です。本文の考え方を条件に当てはめてみましょう。
言葉にしてみる(採点なし)
店の担当者が話すように見える動画が届いたとき、映像から分かることと、別に確かめることを説明してください。