この教材の目次を開く
採点と保存は、記録の準備ができてから使えます。保存済みの表示を確認してください。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
1元の記録を追える表に整える
一枚の受付に用件が二つあり、表には同じ値の行が二つあります。何を一件と数えるか、何を見て確かめますか。
一枚なのに、用件は二つ
コマは上から下へ、横に並んだコマは右から左へ読みます。
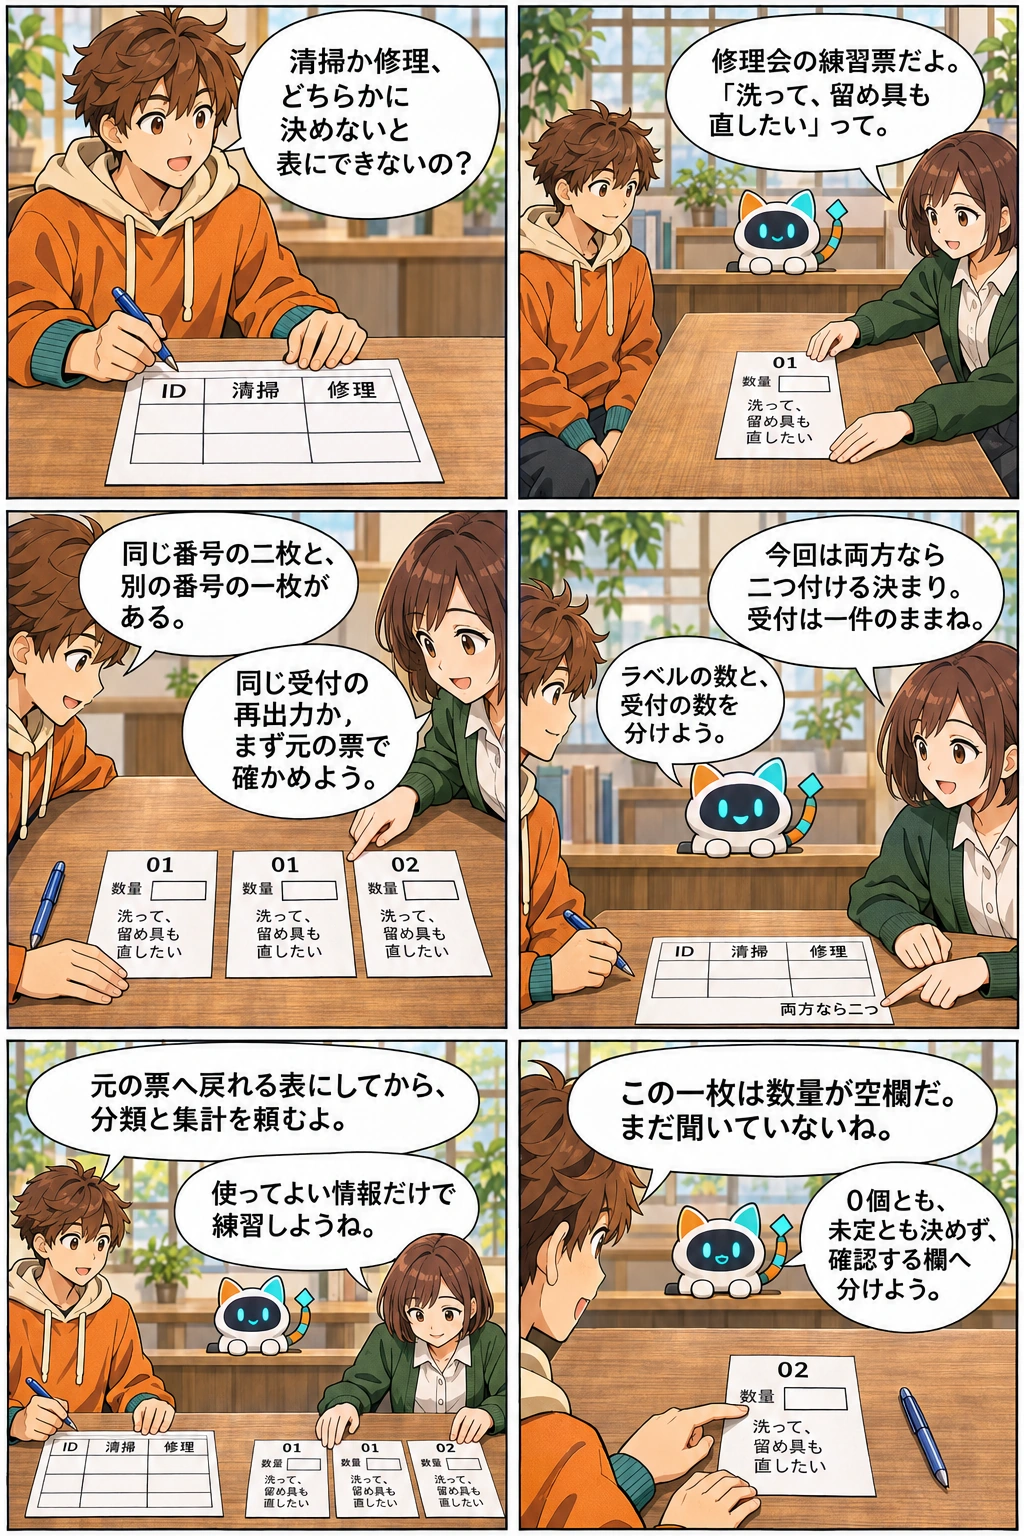
会話を文章で読む
- ミオ「修理会の練習票だよ。「洗って、留め具も直したい」って。」
- ハル「清掃か修理、どちらかに決めないと表にできないの?」
- ミオ「今回は両方なら二つ付ける決まり。受付は一件のままね。」
- ビット「ラベルの数と、受付の数を分けよう。」
- ハル「同じ番号の二枚と、別の番号の一枚がある。」
- ミオ「同じ受付の再出力か、まず元の票で確かめよう。」
- ハル「この一枚は数量が空欄だ。まだ聞いていないね。」
- ビット「0個とも、未定とも決めず、確認する欄へ分けよう。」
- ハル「元の票へ戻れる表にしてから、分類と集計を頼むよ。」
- ミオ「使ってよい情報だけで練習しようね。」
練習票には01が二枚と、別の02が一枚あります。元の票に戻って同じ受付かを確かめ、02の数量の空欄は確認する欄へ分けます。
集会室で、ハルは地域の修理会の受付票を分類しています。ミオが読み上げた一枚には、清掃と修理の両方の用件がありました。表の行をきれいにする前に、何を一件と数え、何を残すかを決めます。
一行は何の記録か、元へ戻れるか
データは、文字・数値・日時など、判断や処理の材料になる記録です。数値は、数量や測定した値などを数で表したものです。表では横の一行を一件の記録、縦の列を同じ種類の項目として扱います。ただし、一行が一人、一回の受付、一商品のどれを表すかは表ごとに違います。原表は、処理の基になる元の表です。CSVは表の各行の値を区切って保存する文字の形式です。表になっているだけで一行の意味や正確さが決まるわけではありません。
IDは、どの記録かを区別するための識別子です。元の受付番号を残し、整形後の行から元の票へ戻れるようにします。受付番号の数字は、数量のように足して使う値とは限りません。同じ人が別の日に申し込んだ二回の受付を、一人分へまとめるかは目的によります。一行が何を表すかを途中で勝手に変えません。
データの整形は、表記や列、値の形を、処理しやすいようにそろえることです。単位は、量を表すときの基準です。「30分」と「0.5時間」を分へそろえるなら、単位の意味も保って変換します。元の値を残し、変換後の値・規則・変更した箇所を対応させます。日付の並べ替えや空白の除去も、意味や必要なIDを変えていないか確かめます。
欠けた値を、ゼロや未定に置き換えない
欠損は、必要な値が記録にない状態です。数量0個という確認済みの値、数量が未記入の状態、数量がまだ決まっていない状態は違います。未確認はまだ確かめていないこと、未定はまだ決まっていないことです。空欄だけを見て、0や未定と決めません。不足の理由を確かめ、確認が済むまでは、その値を使える状態と分けて記録します。
例えば在庫点検で「0本」と記録した品と、数え忘れて空欄の品があれば、空欄を0本へ埋めると、ないと確認していない在庫まで欠品にしてしまいます。分かる品だけの合計を出す場合は「確認済みの品だけ」と範囲を示します。全品の合計が必要なら、不足値を確認してから確定します。ソフトが数値を返したことと、欠損の意味が解決したことは別です。
参照した資料と該当箇所
- pandas Working with missing data
web L34–38 欠損を表す値/L438–456 skipna/空や全NAのsumが数値を返す例/L521–545 fillnaで別の値へ置換する例
分類の名前と、重なったときの扱いを決める
分類は、決めた種類へ記録を割り当てることです。ラベルは、その種類を表す名前です。分類を頼むときは名前だけでなく、どの記述を含めるか、一件へ一つだけ付けるか、複数を付けてよいかを示します。どちらにも当たらない「その他」と、材料が足りず判断できない「要確認」も、必要に応じて分けます。これは分類の作業であり、AIへ新しいモデルの学習を行わせたと自動的に意味するものではありません。
架空の修理会では、「汚れを落としたい記述=清掃」「壊れた箇所を直したい記述=修理」「両方なら二つのラベル」と決めます。「表面を洗い、外れた留め具を直したい」は、一件の受付のまま両方に当たります。片方を主な用件と推測して他方を消したり、一枚を二件の受付へ増やしたりしません。ラベルが二つでも元の受付が二件になったわけではありません。
一つだけの分類が必要なら、重なるときの優先順位や別の区分を先に決めます。どちらの方式が常によいということではなく、目的に合う規則が必要です。少数の元記録と分類結果を人が比べ、抜け・重なり・判断できなかった理由を確かめます。複数ラベルの件数を足した値は、同じ受付を重ねて数えることがあるので、全受付件数と区別します。
重複の基準と、扱ってよい情報を確かめる
重複は、同じと扱う基準に照らして、同じ記録が重ねて入っていることです。例えば「同じ受付ID・同じ版の票を再出力した行は一件として扱う」と決めれば、その組を見ます。品名や数量が同じでも別の受付IDの二件なら、その事実だけで重複にはできません。似た値を消す前に、何を一件と数えるかと、重複判定に使う項目を決めます。
重複と確認した同じ記録は、代表を一つ残して集計します。重なっている行を全部取り除くと、その受付自体がなかったことになります。同じIDでも修正前後の値が違えば、単なる再出力とは限りません。版や更新の経緯を確かめ、どの値を採用するかを決めます。元の票や変更前の値は、照合できる形で保ちます。
ここまでの例として、架空の備品受付M11「鉛筆2本」を同じ版から二回出力し、別受付M12も「鉛筆2本」だったとします。同じIDの再出力を一件にまとめれば、受付はM11・M12の2件、数量は2+2=4本です。数量が同じだからM12を消すことも、二重になったM11をすべて消すこともしません。
AIへ渡す前に情報の扱いを確かめる
個人情報は、生存する個人に関する情報のうち、氏名などで特定の個人を識別できるものや、個人識別符号を含むものです。他の情報と容易に照合して特定の個人を識別できる場合も含まれます。名前をIDへ置き換えた表も、そのIDと名簿を容易に照合できるなどの条件次第で個人情報に当たります。名前を消しただけで、自由にAIへ入力できる表になったとは判断しません。
AIへ渡す前に、目的に必要な項目へ絞り、資料の閲覧・利用権限、送信先の取扱い、組織の手順を確かめます。個人名がない表にも企業の秘密が残ることがあります。集計結果でも、少人数の組合せなどから誰のことか分かる場合があります。法令上の条件、提供者との契約、社内の承認は別の確認です。詳しい判断はGA403・GA404の範囲へ戻り、この教材の表の例だけで送信可否を決めません。
参照した資料と該当箇所
- pandas Indexing / Duplicate data
web L2549–2561 duplicate detection columnsとkeep first/last/False - 個人情報保護委員会 通則編
「2-1 個人情報」の定義と説明。参照範囲は次の見出しの直前まで。
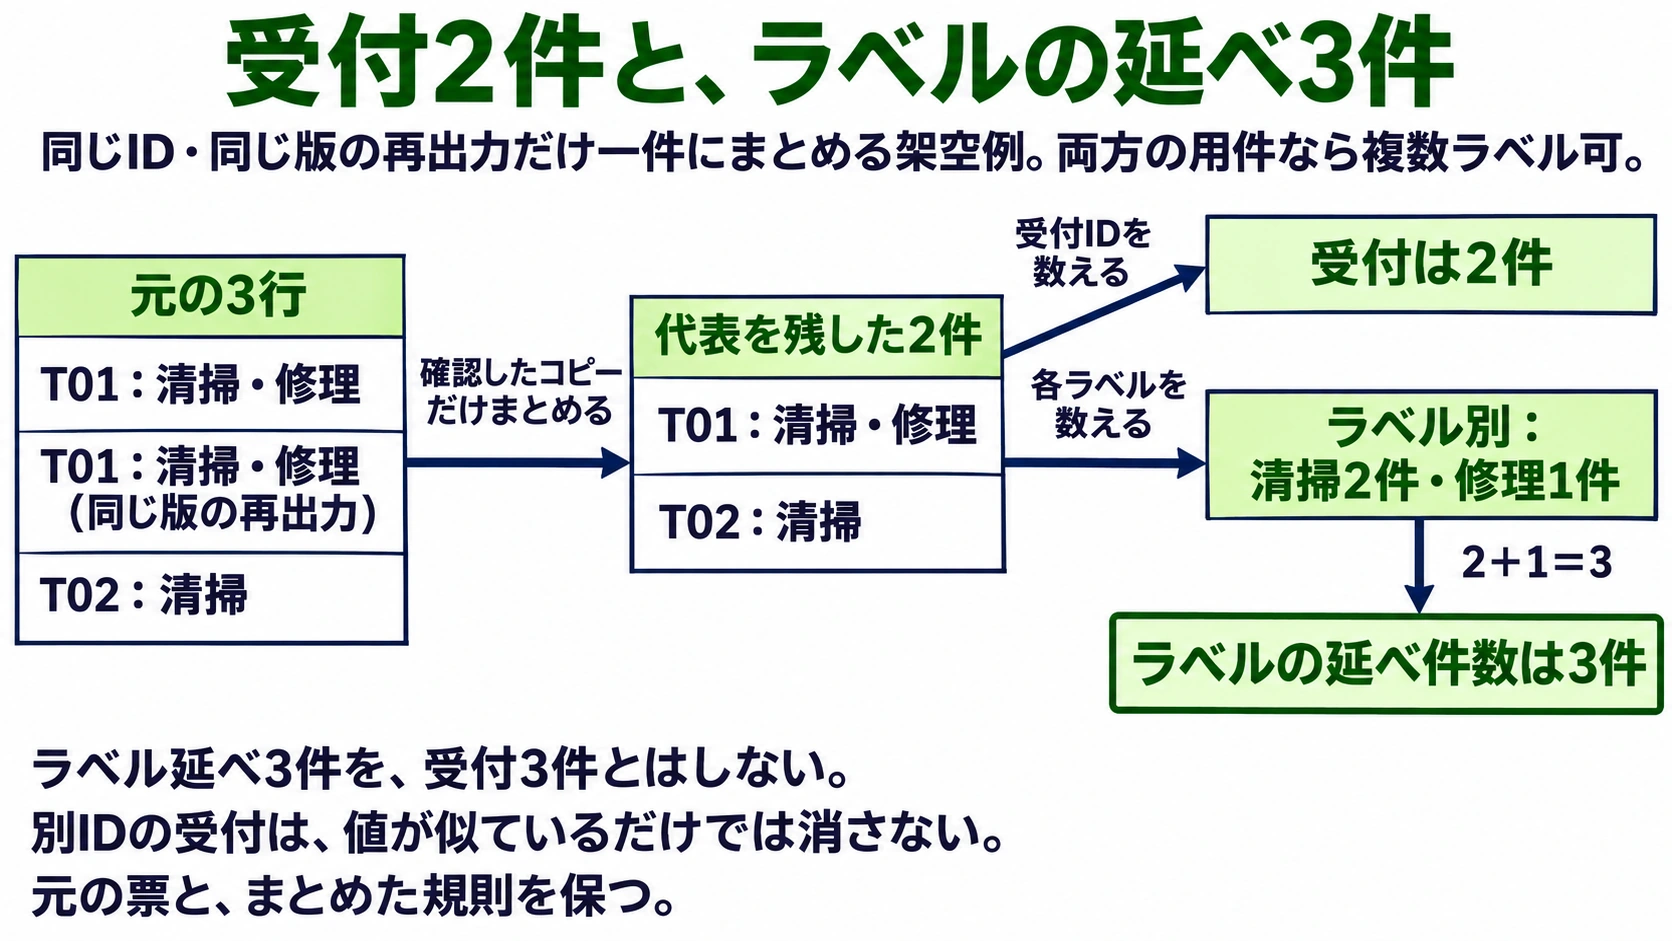
受付2件はT01とT02。ラベル延べ3件は清掃2件と修理1件。
同じ受付ID・同じ版の再出力だけをまとめ、両方の用件なら2つのラベルを付けます。
 図を拡大する ↗
図の各項目と矢印を文章で読む
同じ版のT01を二回出力し、T02は別受付である。T01の代表一行とT02を残すと受付は2件。T01には清掃と修理、T02には清掃が付くので、ラベル別では清掃2件・修理1件、延べ3件になる。複数ラベルの延べ件数と元の受付件数は違う。別IDを値の類似だけで消さず、元の票とまとめた規則を保つ。
条件 同じID・同じ版の再出力だけ一件にまとめる架空例。両方の用件なら複数ラベル可。
- 元の3行
- T01:清掃・修理
- T01:清掃・修理(同じ版の再出力)
- T02:清掃
- 代表を残した2件
- T01:清掃・修理
- T02:清掃
- 受付は2件
- ラベル別:清掃2件・修理1件
- ラベルの延べ件数は3件
- 元の3行 → 代表を残した2件
- 確認したコピーだけまとめる
- 代表を残した2件 → 受付は2件
- 受付IDを数える
- 代表を残した2件 → ラベル別:清掃2件・修理1件
- 各ラベルを数える
- ラベル別:清掃2件・修理1件 → ラベルの延べ件数は3件
- 2+1=3
空間は処理/数え方の関係、時間や因果の軸ではない。
- ラベル延べ3件を、受付3件とはしない。
- 別IDの受付は、値が似ているだけでは消さない。
- 元の票と、まとめた規則を保つ。
図に対応する本文
参照した資料と該当箇所
- pandas Indexing / Duplicate data
web L2549–2561 duplicate detection columnsとkeep first/last/False
別の場面で確かめる
独自作成の問題です。本文で扱った判断を確かめます。
2集計と図を、元の条件から検算する
表の合計と、きれいなグラフがそろえば、確認は終わりでしょうか。
棒の長さと、実際の人数
表の合計と、きれいなグラフがそろえば、確認は終わりでしょうか。
コマは上から下へ、横に並んだコマは右から左へ読みます。
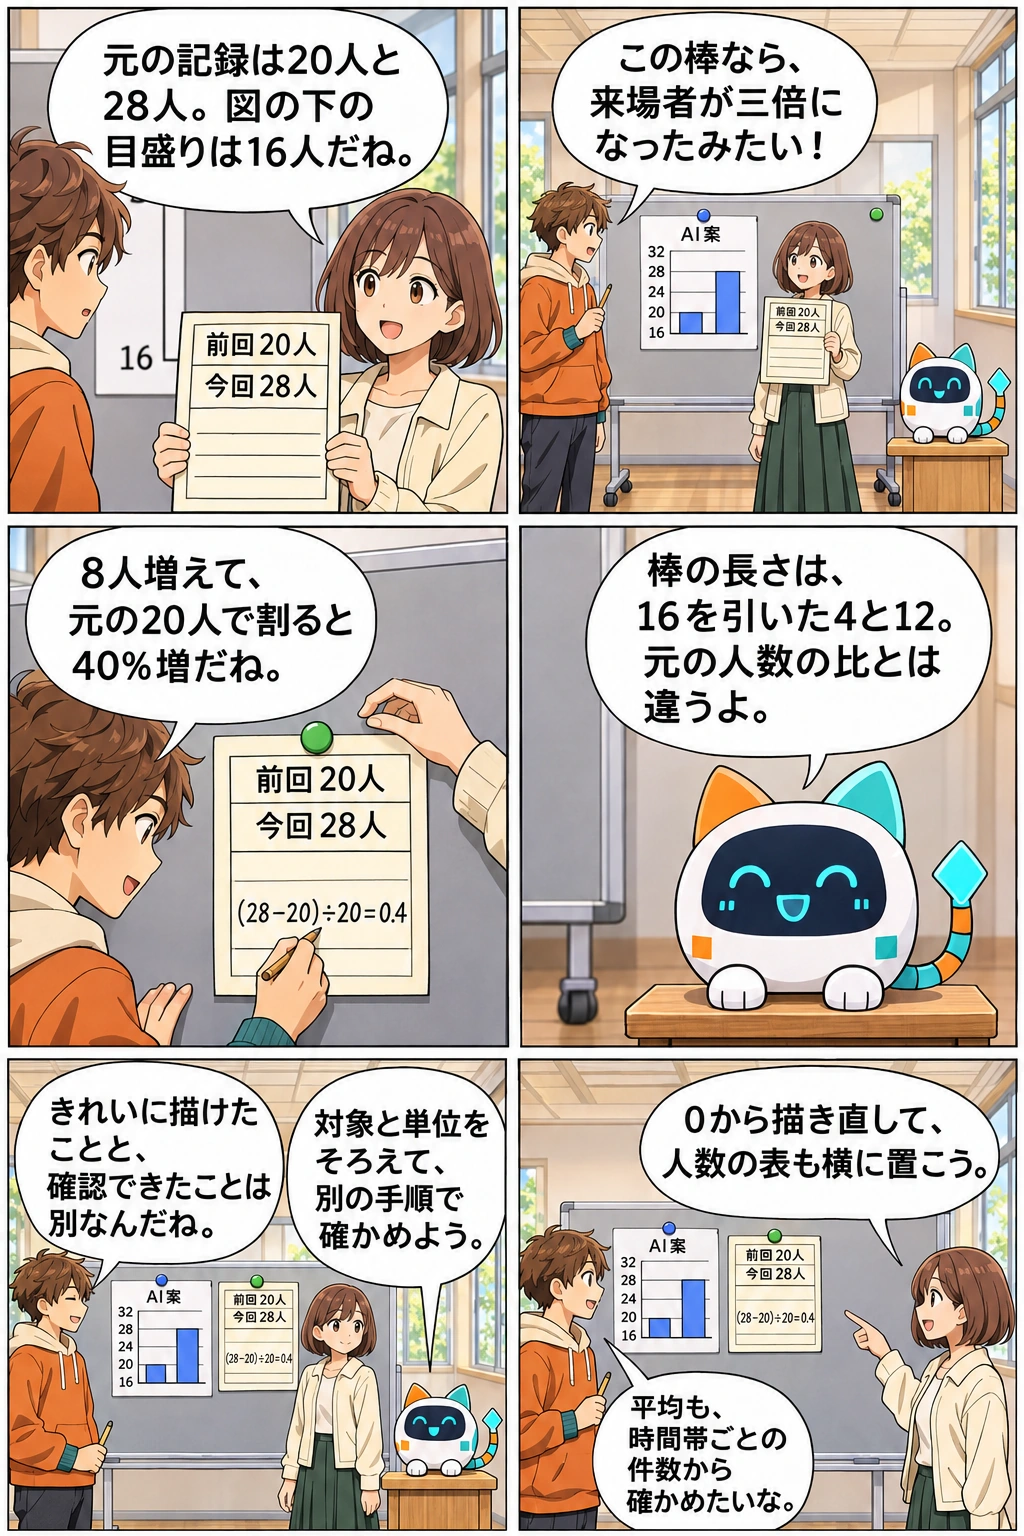
会話を文章で読む
- ハル「この棒なら、来場者が三倍になったみたい!」
- ミオ「元の記録は20人と28人。図の下の目盛りは16人だね。」
- ビット「棒の長さは、16を引いた4と12。元の人数の比とは違うよ。」
- ハル「8人増えて、元の20人で割ると40%増だね。」
- ミオ「0から描き直して、人数の表も横に置こう。」
- ハル「平均も、時間帯ごとの件数から確かめたいな。」
- ビット「対象と単位をそろえて、別の手順で確かめよう。」
- ハル「きれいに描けたことと、確認できたことは別なんだね。」
元の表は20人と28人で、棒グラフの下端は16人です。棒の長さ4と12を、元の20人に対する8人・40%の増加と分けます。
地域展示の準備室で、ハルはAIが描いた来場記録のグラフを見ています。ミオは増え方が大きく見える理由を問い、元の表と軸を並べます。計算が合うかと、図が何を伝えるかを分けて読みます。
集計の対象・期間・単位・分母をそろえる
集計は、決めた条件で記録をまとめ、件数・合計・平均などを求めることです。原表は、その計算の基になる表です。「受付の多さ」でも、行数、重複を除いた受付件数、同じ人をまとめた人数は違います。集計を始める前に、対象となる記録、含める期間、重複の扱い、求める値を決めます。
単位は、数が何をどれだけ表すかの基準です。1,200mLと0.8Lを合計するなら、0.8L=800mLとして2,000mL、つまり2Lです。数だけを足した1,200.8という値は、意味のそろった合計ではありません。税込と税別、一日と一か月などの違いも見て、同じ条件に直せない値をそのまま足したり比べたりしません。
分母は、割合や平均で何を一まとまりとして割るかを表す数です。平均は、同じ意味の数値の合計を、その数値の個数で割った値です。平均待ち時間なら、対象の待ち時間の合計を、値が分かる対象件数で割ります。集団ごとの平均をもう一度平均しても、各集団の件数が違えば、全件の平均とは限りません。割合でも、何件中の何件かを数値と一緒に残します。
参照した資料と該当箇所
- pandas Group by: split-apply-combine
web L34–49 split/apply/combine、group sums/means/counts/L636–654 aggregation、non-NA count/mean/nunique/L1749–1750 grouping keysのNA扱いは必要参考。実ソフト運用仕様へ一般化しない。
AIの式を眺めるだけでなく、別の手順で確かめる
検算は、計算結果を別の計算や元の値との照合で確かめることです。原表から対象行を確かめ、単位をそろえ、件数と合計を出し、最後に平均や割合を計算します。AIの答えと同じ答えがもう一度返ることだけで確認を終えません。小さな例を手で計算する、計算専用の道具で別に求めるなど、元の数値へ戻れる手順を使います。
架空の窓口で、午前は3件で平均4分、午後は9件で平均8分とし、全12件に欠損や丸めがないとします。合計待ち時間は午前3×4=12分、午後9×8=72分です。全体は(12+72)÷(3+9)=84÷12=7分です。(4+8)÷2=6分は二つの時間帯を同じ重さで平均した値で、今回の全12件の平均ではありません。
待ち時間に欠損があるときは、その理由と計算の範囲も確かめます。空欄を0分へ変えると、待たなかった記録を作ることになります。分かる値だけで平均を求めるなら、有効な値の件数と除いた件数を示し、全件の平均が確認できたとはしません。式が正しく動くこと、入力の値が正しいこと、その範囲から言えることは別に確認します。
参照した資料と該当箇所
- NIST AI600-1 Generative AI Profile
物理p10/印刷6 §2.2 - pandas Working with missing data
web L34–38 欠損を表す値/L438–456 skipna/空や全NAのsumが数値を返す例/L521–545 fillnaで別の値へ置換する例 - pandas Group by: split-apply-combine
web L34–49 split/apply/combine、group sums/means/counts/L636–654 aggregation、non-NA count/mean/nunique/L1749–1750 grouping keysのNA扱いは必要参考。実ソフト運用仕様へ一般化しない。
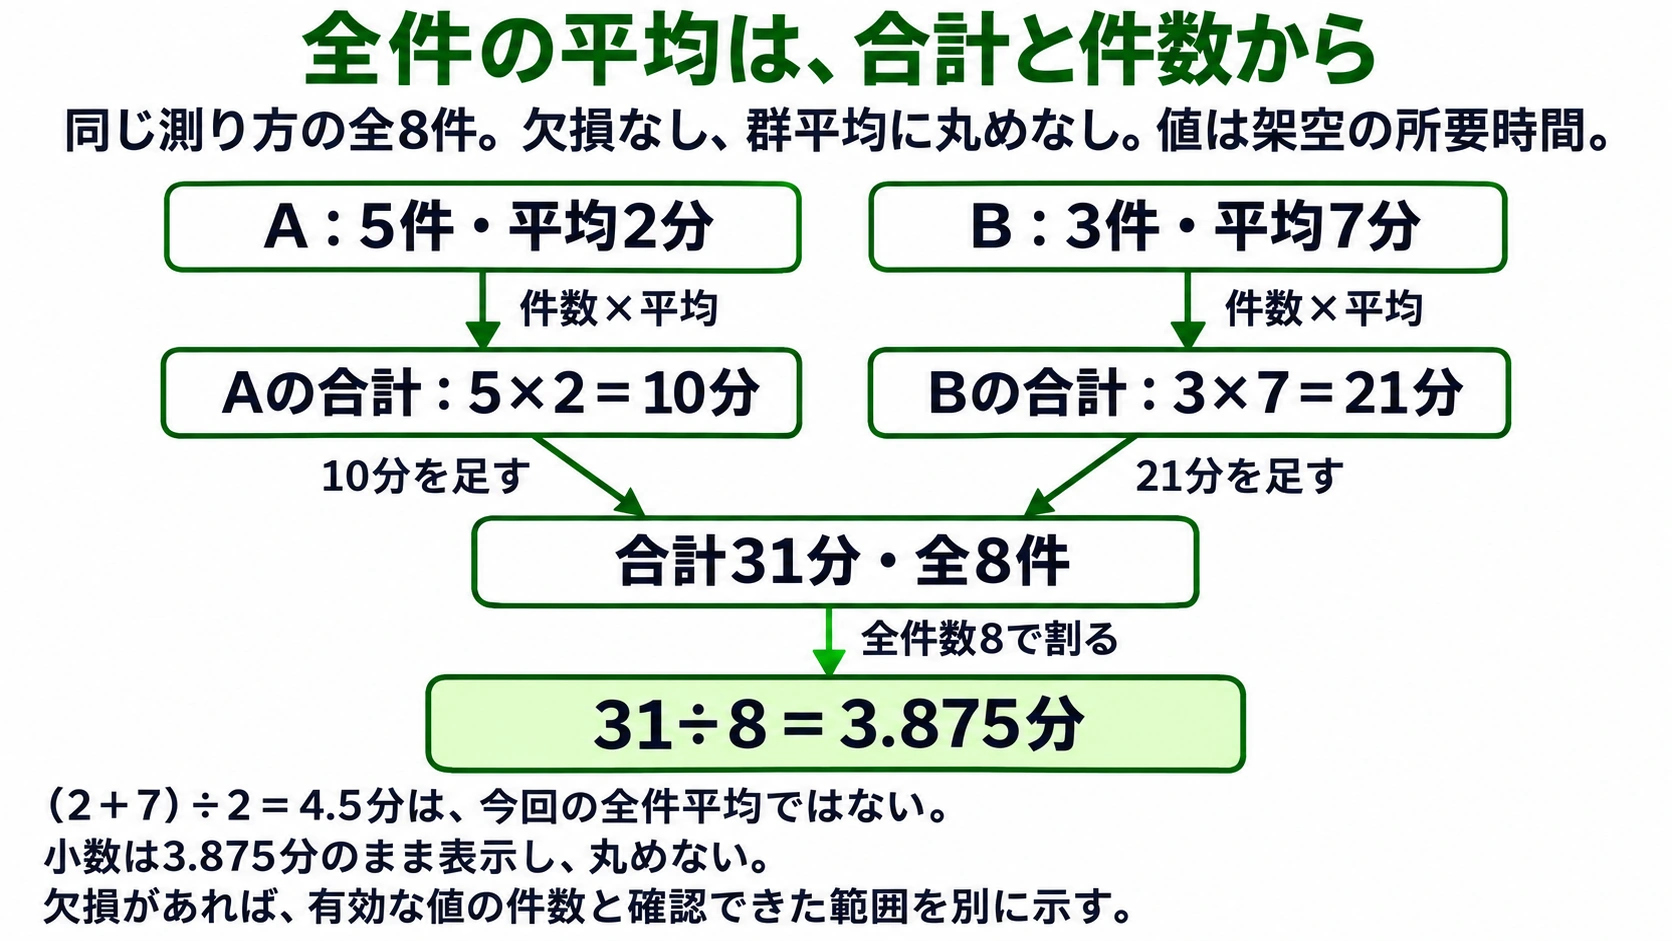
全件平均3.875分。Aは5件×2分=10分、Bは3件×7分=21分。合計31分を8件で割ります。
同じ方法で測った、欠損・丸めのない例です。群平均を単純に平均した4.5分とは異なります。
 図を拡大する ↗
図の各項目と矢印を文章で読む
同じ方法で測ったAの5件は平均2分、Bの3件は平均7分で、全8件に欠損も群平均の丸めもない。Aの合計は5×2=10分、Bは3×7=21分。合計31分を全8件で割ると3.875分で、丸めず表示する。群平均を単純平均した(2+7)÷2=4.5分は今回の全件平均ではない。欠損がある別の状況では、有効な値の件数と確認範囲を示す。
条件 同じ測り方の全8件。欠損なし、群平均に丸めなし。値は架空の所要時間。
- A:5件・平均2分
- B:3件・平均7分
- Aの合計:5×2=10分
- Bの合計:3×7=21分
- 合計31分・全8件
- 31÷8=3.875分
- A:5件・平均2分 → Aの合計:5×2=10分
- 件数×平均
- B:3件・平均7分 → Bの合計:3×7=21分
- 件数×平均
- Aの合計:5×2=10分 → 合計31分・全8件
- 10分を足す
- Bの合計:3×7=21分 → 合計31分・全8件
- 21分を足す
- 合計31分・全8件 → 31÷8=3.875分
- 全件数8で割る
処理の順序。棒の長さを値の比として使わない。
- (2+7)÷2=4.5分は、今回の全件平均ではない。
- 小数は3.875分のまま表示し、丸めない。
- 欠損があれば、有効な値の件数と確認できた範囲を別に示す。
図に対応する本文
参照した資料と該当箇所
- pandas Group by: split-apply-combine
web L34–49 split/apply/combine、group sums/means/counts/L636–654 aggregation、non-NA count/mean/nunique/L1749–1750 grouping keysのNA扱いは必要参考。実ソフト運用仕様へ一般化しない。
グラフの軸と元の値を一緒に読む
可視化は、数や関係を図やグラフなどの見える形で表すことです。出典は、使った情報がどの資料や記録に基づくかを示す手掛かりです。図には対象・期間・単位・出典をそろえ、軸がどこから始まり、同じ間隔でいくつ増えるかを読みます。棒の長さで量の大きさを比べる棒グラフでは、0を基準に描くことが大切です。折れ線や散布図まで一律に0始まりとする規則とは分け、図の型と読み方を考えます。
架空の展示の受付が18件から27件へ増えた場合、増加は9件、割合は9÷18=0.5、つまり50%です。棒の下端を15件にすると、描かれた長さは3から12になり4倍に見えますが、受付件数は27÷18=1.5倍です。目盛と数字が書かれていても、棒の長さの比をそのまま件数の比へ読み替えません。元の18・27という値と、0を基準にした棒を照合します。
図の見やすさを直すときも、対象や期間、分母など必要な条件を落としません。件数と割合では意味が違い、全体の数が変われば同じ件数でも割合が変わります。数値に合う図を作れても、なぜ変化したかという原因までは計算だけで決まりません。事実、そこからの解釈、まだ確認していない点を分けます。
参照した資料と該当箇所
- Office for National Statistics Axes and gridlines
web L83–101 特にbars/areaのzero baselineとline/scatterとの区別/L134–136 比較する図のconsistent scales - NIST AI600-1 Generative AI Profile
物理p13/印刷9 §2.8の定義段落
文書の抽出とRAGは、検算の材料をそろえる工程
情報抽出は、文書から目的に必要な部分を取り出すことです。会場の報告書から利用人数を表へ抜き出すなら、資料ID・頁・見出し・表の行列・単位・脚注も対応させます。全体を短くまとめる要約とは目的が違います。例えばAの30人は延べ人数(同じ人の複数回も数える)、Bの25人は実人数(対象期間内の同じ人を一人と数える)なら、そのまま足した55人を「実人数」とはしません。数字を取り出せても、数え方の違いは残ります。見出しと値や脚注を原文へ戻して比べます。
RAG(検索拡張生成)は、質問に関連する外部資料を検索し、その内容を生成モデルへ渡して回答を作る構成です。長い資料を小さな部分に分けて検索することもあり、資料の名前や版、元の位置を追える情報を添えます。ここでは利用時に資料を参照する流れを扱い、資料を渡しただけでモデルの重みを更新したとはみなしません。資料を検索できることと、その人に閲覧・利用の権限があることは別です。
関連する箇所が見つかったことは、全対象の記録を数えた証拠ではありません。全会場の総数が必要なら、対象会場の一覧と抽出済みの資料を照合し、欠落や二重計上を確かめます。構成によって表の全件処理や計算道具を組み合わせることもできますが、検索と生成を使ったという名前だけで網羅や算術を保証しません。根拠となる文章を読めること、正しい対象を抽出したこと、集計と解釈が合うことを分けて点検します。
参照した資料と該当箇所
- Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
arXiv L8/28–31版表示/Abstract L16–19 特にparametric/non-parametric memoryとretrieved passages
別の場面で確かめる
独自作成の問題です。本文で扱った判断を確かめます。
途中の選択もこの端末に残ります。二つ選んで「答えを確かめる」を押すと、確認済みの回答になります。
3出典と更新を追い、定例報告を仕上げる
新しく公表された資料なら、新しい時期のデータでしょうか。
新しい日付は、いつの数字?
新しく公表された資料なら、新しい時期のデータでしょうか。
コマは上から下へ、横に並んだコマは右から左へ読みます。
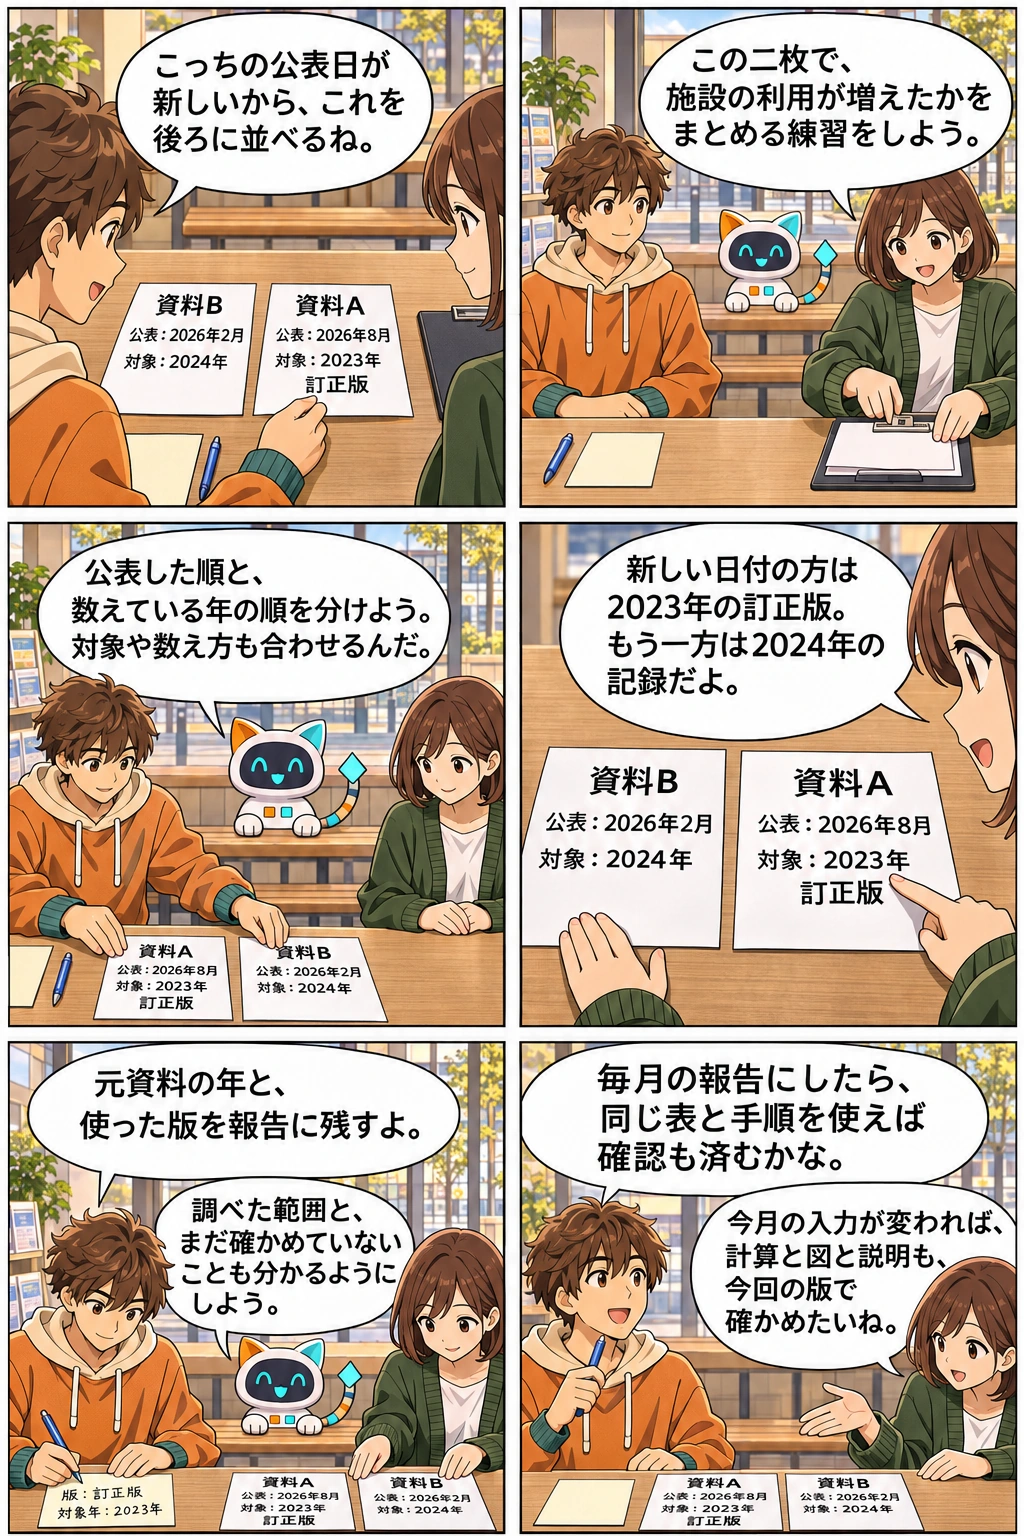
会話を文章で読む
- ミオ「この二枚で、施設の利用が増えたかをまとめる練習をしよう。」
- ハル「こっちの公表日が新しいから、これを後ろに並べるね。」
- ミオ「新しい日付の方は2023年の訂正版。もう一方は2024年の記録だよ。」
- ビット「公表した順と、数えている年の順を分けよう。対象や数え方も合わせるんだ。」
- ハル「毎月の報告にしたら、同じ表と手順を使えば確認も済むかな。」
- ミオ「今月の入力が変われば、計算と図と説明も、今回の版で確かめたいね。」
- ハル「元資料の年と、使った版を報告に残すよ。」
- ビット「調べた範囲と、まだ確かめていないことも分かるようにしよう。」
資料Aは2026年8月公表で、対象は2023年の訂正版です。資料Bは2026年2月公表で、対象は2024年です。二人は対象年の順に置き直し、版と対象年を記録します。
駅前の共有掲示スペースで、二人は地域施設の利用状況をまとめる相談をしています。新しい日付の報告が、古い対象年の訂正版だと分かりました。出典の順と、データの時間の順を並べ直し、来月も確認できる記録を考えます。
一次情報へ戻り、複数の出所を読み比べる
一次情報は、調査した人や組織、制度を定める機関などが直接示す元の記録や資料です。店の自分たちの実測表や、調査実施者が公表した報告も一次情報になり得ます。別の人が元資料を紹介・解説したものは二次情報として区別できます。一次情報でも対象の偏りや誤記がないとは限らず、何を調べたかと確認できる範囲を読みます。
ディープリサーチは、この教材では、問いを小さく分け、複数の資料を探して読み比べ、不足に応じて調べ直し、根拠を示してまとめる調査の進め方を指します。一つの検索結果を長く要約するだけとは分けます。同じ名前の製品機能もありますが、使える資料・操作・手順や性能はサービスや構成によって違います。名称だけで十分な調査が終わったとは判断しません。
資料を並べるときは、掲載したサイトの数だけでなく、どの元記録に基づくかを追います。同じ調査の転載は、別々の調査が一致した証拠にはなりません。逆に、別調査なら対象者・質問・方法が同じかを確かめます。報告では、確認できた主張と出典、不足している資料、食い違いを残し、多数決や文章の自然さだけで結論を決めません。
参照した資料と該当箇所
- NIST AI600-1 Generative AI Profile
物理p13/印刷9 §2.8の定義段落 - GUGA 2027年2月試験以降適用の保存シラバス
物理p1表紙/物理p7 S-K081のデータ分析・リサーチ業務の1目標行、5学習項目、9詳細語
公表した日と、データが示す期間を分ける
公表日は、資料を外へ示した日です。対象期間は、その資料の数値がいつの出来事や状態を表すかという期間です。確認日は、自分が資料を確かめた日です。版は、修正などで区別された資料のまとまりを表します。公表が新しくても、古い対象期間の訂正版かもしれません。公表日の順を、そのままデータが新しい順へ読み替えません。
架空の施設の同じ対象・定義の利用記録で、2026年5月公表の訂正版は2025年1〜3月の900件、2026年4月公表の別報告は2026年1〜3月の1,080件とします。対象期間順では900件から1,080件で、180÷900=20%増です。公表順へ並べた1,080件から900件という減少ではありません。二つは同じ期間の数字の食い違いでもないため、平均して一つの値にもまとめません。
比較には、期間の長さだけでなく、対象地域や人、数え方、速報・確報の別も見ます。1〜3月と1年分では、そのまま増減を比べられません。制度や利用条件の調査では、その版がいつ適用されるかも別に確かめます。新しい公表日や自分の確認日だけで、今年や将来に適用する内容と決めません。違う条件をそろえられないときは、比較できる範囲や未確認を示します。
参照した資料と該当箇所
- NIST AI600-1 Generative AI Profile
物理p13/印刷9 §2.8の定義段落
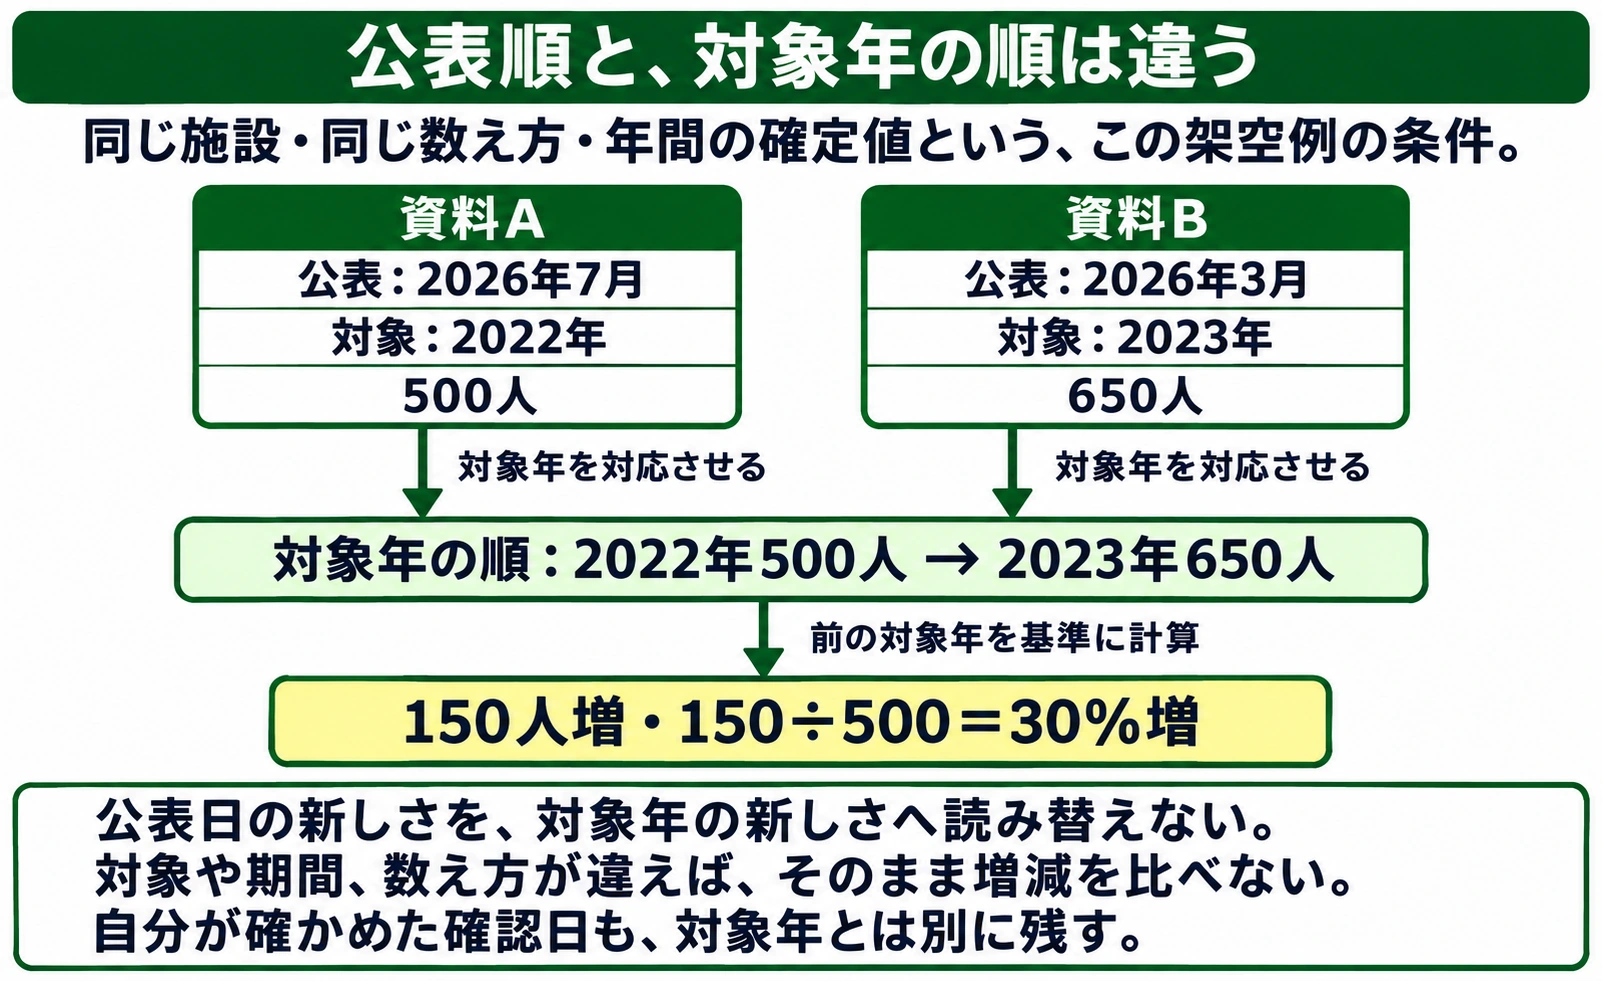
対象年では30%増。2022年500人から2023年650人へ。差150人を500人で割ります。
資料Aは2026年7月公表で対象は2022年。資料Bは2026年3月公表で対象は2023年。同じ施設・同じ数え方の年間確定値を比較します。
 図を拡大する ↗
図の各項目と矢印を文章で読む
同じ施設を同じ方法で数えた年間確定値の架空例。資料Aは2026年7月公表で対象2022年500人、資料Bは2026年3月公表で対象2023年650人。対象年順では2022年500人から2023年650人で、差150人、150÷500=30%増。新しい公表日の資料が新しい対象年とは限らない。対象・期間・数え方が違う資料には、この比較をそのまま適用せず、自分の確認日も分けて残す。
条件 同じ施設・同じ数え方・年間の確定値という、この架空例の条件。
- 資料A
- 公表:2026年7月
- 対象:2022年
- 500人
- 資料B
- 公表:2026年3月
- 対象:2023年
- 650人
- 対象年の順:2022年500人 → 2023年650人
- 150人増・150÷500=30%増
- 資料A → 対象年の順:2022年500人 → 2023年650人
- 対象年を対応させる
- 資料B → 対象年の順:2022年500人 → 2023年650人
- 対象年を対応させる
- 対象年の順:2022年500人 → 2023年650人 → 150人増・150÷500=30%増
- 前の対象年を基準に計算
下段の左→右は対象年2022→2023。上段カードの順は公表日の新旧を意味しない。
- 公表日の新しさを、対象年の新しさへ読み替えない。
- 対象や期間、数え方が違えば、そのまま増減を比べない。
- 自分が確かめた確認日も、対象年とは別に残す。
参照した資料と該当箇所
- NIST AI600-1 Generative AI Profile
物理p13/印刷9 §2.8の定義段落
定めた工程にも、人の確認点と入力の版を置く
ワークフローは、仕事を進める工程のつながりです。ワークフロー型エージェントは、あらかじめ設計した順序や分岐に沿って、LLM(大規模言語モデル)や道具による処理を組み合わせる構成を指します。AIが状況に応じて次の処理を広く選ぶ構成とは、手順をどこで決めるかを分けて考えます。人が確認する工程はどちらにも置けます。ここでの分類は構成の説明で、全製品の共通仕様ではありません。
例えば、使ってよい資料を集める→表を整形・分類する→計算する→報告案を作る→人が内容を確認する→許可した宛先へ配る、という流れを設計できます。各工程には入力の版・対象期間・出力・確認したことを対応させます。入力してよい情報の確認は送信前に必要です。下書き作成、内容確認、配布の権限も分けます。この教材では工程を考えるだけで、サービスの予約送信や自動処理は実行しません。
入力を直したら、その値を使った計算、グラフ、説明文まで影響が続くことがあります。前の版を確認した記録は、直した後の出力の確認へ自動で移りません。変更した入力から影響先を追い、必要な計算と説明を作り直して、その版を確認します。関係のない固定の宛名書式などを機械的に全部作り直す必要はありませんが、変更の影響がないことは確かめます。
参照した資料と該当箇所
- Anthropic Building effective agents
L24–26発行日、L48時代の限定/L51–61 workflows/agentsの区別/L86–98 prompt chainingとintermediate gate/L154–163 human checkpoints/ground truth/stop conditions - NIST AI600-1 Generative AI Profile
物理p13/印刷9 §2.8の定義段落
定例レポートは、毎回の条件まで確かめて渡す
定例レポートは、決めた間隔で繰り返し作る報告です。毎月の計算や文章のひな形を再利用すると、繰り返しの作業を減らす助けになります。一方、今月の原表、対象期間、単位、欠損と重複、計算結果、出典の版は毎回変わり得ます。同じ工程が最後まで動いたことと、今回の内容が正しいことを分けて確認します。
配布前には、原表と集計、図と文章、未確認の注記、今回の対象期間と宛先を確かめます。確認点は、人が何を見て採用するかを決める場所です。取得できない資料、単位の変更、説明できない急な増減があれば、その箇所を分け、影響する結論や配布を確定しない扱いも決めておきます。人を工程へ入れたという名前だけではなく、確認する材料と権限が必要です。
例えば月次の備品報告で、元の点検票の個数を訂正した後に報告案が自動で更新されたなら、前の合計のままの図や「前月と同じ」という説明が残っていないかを見ます。訂正した表、再計算した値、それを使った図と文、確認した版をつなげます。AIへ任せる工程を増やしても、何を根拠に使えると判断したかが残る形を目指します。
参照した資料と該当箇所
- GUGA 2027年2月試験以降適用の保存シラバス
物理p1表紙/物理p7 S-K081のデータ分析・リサーチ業務の1目標行、5学習項目、9詳細語 - Anthropic Building effective agents
L24–26発行日、L48時代の限定/L51–61 workflows/agentsの区別/L86–98 prompt chainingとintermediate gate/L154–163 human checkpoints/ground truth/stop conditions - NIST AI600-1 Generative AI Profile
物理p13/印刷9 §2.8の定義段落
別の場面で確かめる
独自作成の問題です。本文で扱った判断を確かめます。
本文で使った言葉を確かめる
担当範囲にある9語と、説明を支える22語です。
- データの整形
- 表記や列、値の形を、意味を保ちながら処理しやすくそろえること。 本文へ戻る ↑
- 分類
- 決めた種類へ記録を割り当てること。種類の定義と、一件へ複数付けてよいかも決める。 本文へ戻る ↑
- 個人情報
- 生存する個人に関する情報のうち、記述等で特定人を識別できるもの(容易な照合を含む)、または個人識別符号を含むもの。 本文へ戻る ↑
- 集計
- 決めた条件で記録をまとめ、件数・合計・平均などを求めること。 本文へ戻る ↑
- 検算
- 計算結果を別の計算や元の値との照合で確かめること。 本文へ戻る ↑
- RAG(検索拡張生成)
- 質問に関連する外部資料を検索し、その内容を生成モデルへ渡して回答を作る構成。検索だけで網羅・算術・利用権限を保証しない。 本文へ戻る ↑
- 一次情報
- 調査した人や組織、制度を定める機関等が直接示す元の記録や資料。一次であることと、偏りや誤記がないことは別。 本文へ戻る ↑
- ディープリサーチ
- 問いを分け、複数資料を探して読み比べ、不足を調べ直し、根拠を示してまとめる調査の進め方として扱う。製品機能の共通仕様ではない。 本文へ戻る ↑
- ワークフロー型エージェント
- 設計した順序や分岐に沿って、LLMや道具による処理を組み合わせる構成。人の確認点も設計する。 本文へ戻る ↑
- 数値
- 数量や測定した値などを数で表したもの。受付IDの文字列を数量として扱うこととは分ける。 本文へ戻る ↑
- CSV
- 表の各行の値を区切って保存する文字の形式。形式が整うことと内容が正しいことは別。 本文へ戻る ↑
- 未確認
- 正しさや状態をまだ確かめていないこと。資料にない事項は、未定だと決まったことにもならない。 本文へ戻る ↑
- 未定
- まだ決まっていないこと。未記入や未確認から推定せず、そう分かった場合に表示する。 本文へ戻る ↑
- ID
- どの記録かを区別する識別子。数字の形でも、計算に使う数量とは限らない。 本文へ戻る ↑
- 欠損
- 必要な値が記録にない状態。0や未定と自動で同じにしない。 本文へ戻る ↑
- ラベル
- 分類の種類を表す名前。ラベルの延べ件数と元の記録件数は分ける。 本文へ戻る ↑
- 重複
- 決めた基準に照らし、同じ記録が重ねて入っていること。値が同じ別記録とは限らない。 本文へ戻る ↑
- 原表
- 処理や計算の基になる元の表。結果からどの行を使ったかを追えるようにする。 本文へ戻る ↑
- 単位
- 数が何をどれだけ表すかの基準。異なる単位は意味をそろえて計算する。 本文へ戻る ↑
- 分母
- 割合や平均で何を一まとまりとして割るかを表す数。 本文へ戻る ↑
- 平均
- 同じ意味の数値の合計を、その数値の個数で割った値として扱う。 本文へ戻る ↑
- 可視化
- 数や関係を、図やグラフなどの見える形で表すこと。 本文へ戻る ↑
- 情報抽出
- 目的に必要な部分を資料から取り出すこと。元の位置や条件も対応させる。 本文へ戻る ↑
- 出典
- 使った情報がどの資料や記録に基づくかを示す手掛かり。 本文へ戻る ↑
- 対象期間
- 資料の数値が、いつの出来事や状態を表すかという期間。 本文へ戻る ↑
- 公表日
- 資料を外へ示した日。数値が対象にする期間と同じとは限らない。 本文へ戻る ↑
- 確認日
- 自分がその資料を確かめた日。対象期間や適用日と分ける。 本文へ戻る ↑
- 版
- 修正などで区別された資料のまとまり。確認記録もその版と結ぶ。 本文へ戻る ↑
- ワークフロー
- 仕事を進める工程のつながり。入力から後の工程へ影響する関係も考える。 本文へ戻る ↑
- 定例レポート
- 決めた間隔で繰り返し作る報告。毎回の対象期間・原表・出典などは改めて確かめる。 本文へ戻る ↑
- 確認点
- 人が何を見て採用するかを決める工程上の場所。材料と権限もそろえる。 本文へ戻る ↑