この教材の目次を開く
回答はこのページを開いている間だけ保持します。別ページへの移動や再読み込みで消えます。保存されるのは読み方の設定だけです。
「保存済みです。」と表示された回答は、同じブラウザーでこの教材を開き直すと復元できます。
1言語を扱うモデルと、利用時の入力を整理する
文章を扱うAIは、全て大規模言語モデルなのでしょうか。
- 自然言語処理・LM・LLMの範囲を分ける
- プロンプトと学習済みモデル、測った能力を区別する
文字が出ている。中身は同じ?
この話で学ぶこと:文字の表示・モデルの名前・渡す入力を分ける。
コマは上から下へ、横に並んだコマは右から左へ読みます。
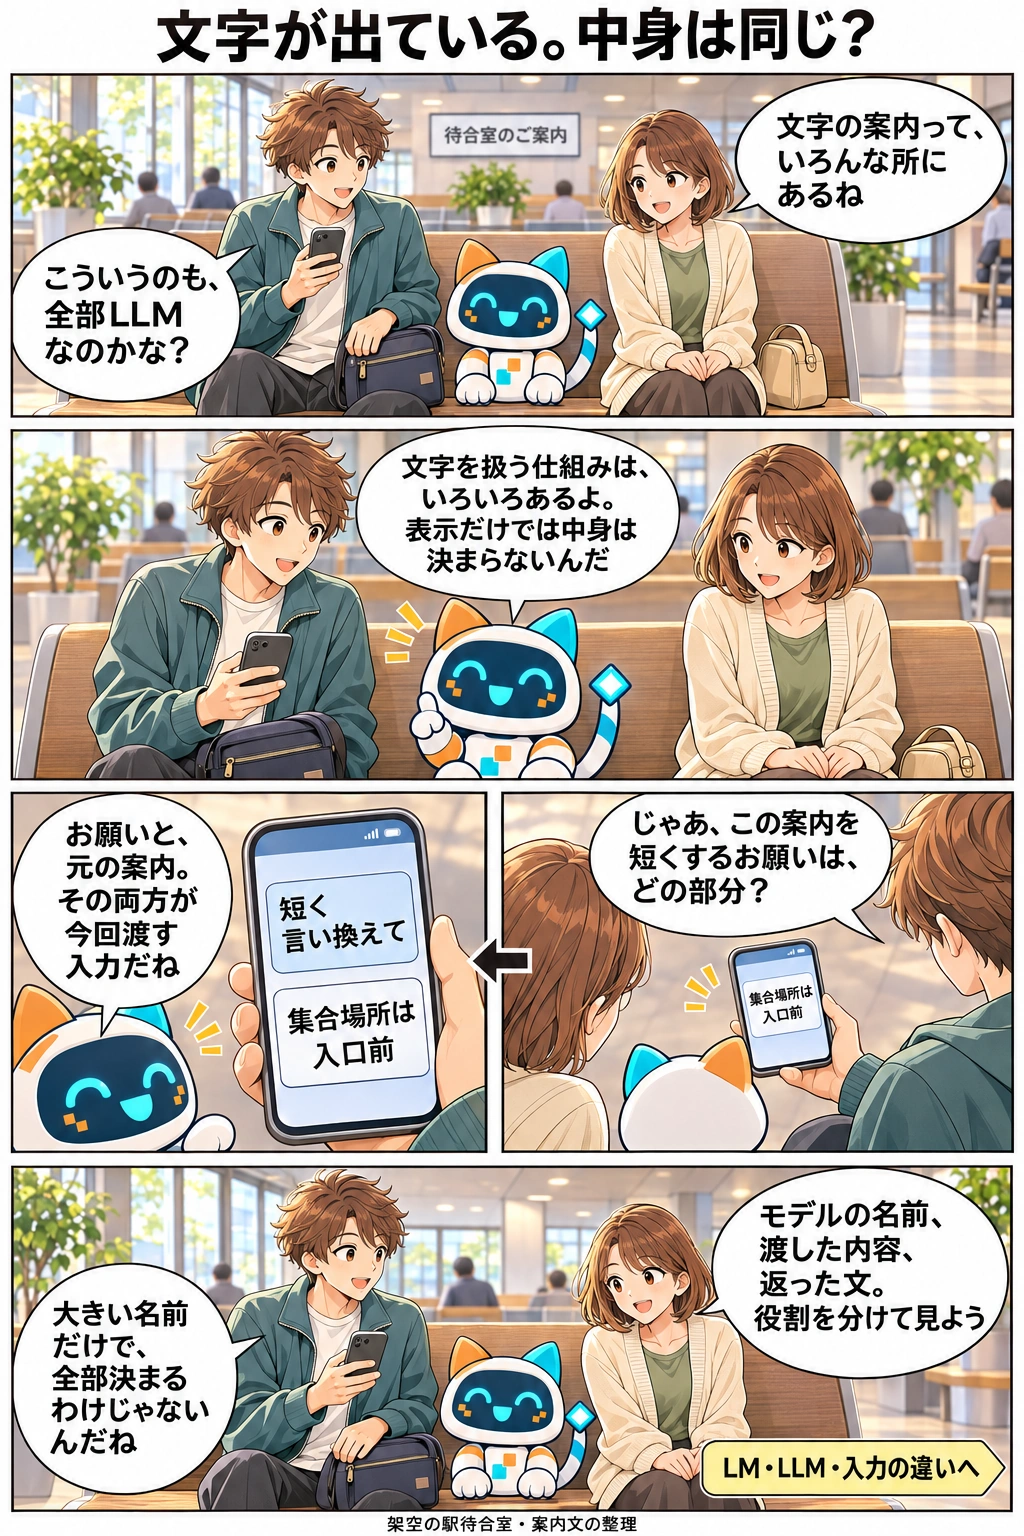
会話を文章で読む
場面:駅の屋内待合室。ハルが左、ミオが右、ビットは間のベンチにいる。奥の表示は架空の「待合室のご案内」。先に右上のミオ、続いて左下のハルが話す。
ミオ「文字の案内って、いろんな所にあるね」 ハル「こういうのも、全部LLMなのかな?」場面:三人がベンチで話す。ビットが、文字の表示だけでは内部の仕組みは決まらないと説明する。
ビット「文字を扱う仕組みは、いろいろあるよ。表示だけでは中身は決まらないんだ」場面:二人の肩越しから、ハルが右手のスマートフォンを共有する。元のメモ「集合場所は入口前」が見える。
ハル「じゃあ、この案内を短くするお願いは、どの部分?」場面:同じスマートフォンに「短く言い換えて」と「集合場所は入口前」が別枠で表示される。右の手元から左の説明へ矢印がつながり、ビットが両方を入力と説明する。
ビット「お願いと、元の案内。その両方が今回渡す入力だね」場面:同じベンチの三人。ミオの発話に続きハルが確認する。欄外の案内は「LM・LLM・入力の違いへ」。
ミオ「モデルの名前、渡した内容、返った文。役割を分けて見よう」 ハル「大きい名前だけで、全部決まるわけじゃないんだね」
駅の待合室で案内文を整理する場面から、アプリ名・モデルの名前・今渡す入力の役割を分けます。人が文章を読めることを、その人や全てのツールがLLMだという例にしません。
自然言語処理の中に、言葉の確率を扱うモデルがある
自然言語処理は、日本語や英語など人が使う言葉をコンピューターで扱う分野です。文章を分類する、意味の手掛かりを取り出す、翻訳する、文章を生成するなどの処理があります。言語モデル(LM:Language Model)は、トークンやその並びが現れる確率を扱うモデルです。言葉を扱う処理という大きな範囲と、その中のモデルの種類を分けます。
例えば、固定した単語の規則だけで文章を分類する仕組みも、自然言語を扱う処理です。それだけで言語モデルを使うことにはなりません。一方、文に続く語の候補の確率を扱うモデルはLMの例です。アプリが文章を入力できるという見た目だけで、内部のモデルの種類を決めないようにしましょう。
根拠:Machine Learning Glossary(別タブで開く) ↗ / Introduction to Large Language Models(別タブで開く) ↗
LLMは大規模な言語モデルで、何でも正しいという意味ではない
大規模言語モデル(LLM:Large Language Model)は、多数のパラメータなどを持つ大規模な言語モデルです。多くのデータや計算資源を使って学習することと関わりますが、「この個数以上なら必ずLLM」という全てに共通する線引きを、この教材で決めるわけではありません。LMとLLMは無関係な二種類ではなく、LLMもLMの一種です。
規模が大きいという名前だけで、今の質問への正確性や、必要な速度・運用条件まで保証されるわけではありません。GA202で見た創発的能力は、ある規模で新たな能力が現れて見えるという議論です。何の課題をどう採点したかも関係するため、大きいモデルなら全業務を評価なしで任せられるという結論にはしません。
根拠:Machine Learning Glossary(別タブで開く) ↗ / Introduction to Large Language Models(別タブで開く) ↗ / Emergent Abilities of Large Language Models(別タブで開く) ↗ / Are Emergent Abilities of Large Language Models a Mirage?(別タブで開く) ↗
プロンプトは、今の処理へ渡す指示や材料
プロンプトは、生成AIへ今の処理のために渡す入力です。指示文と呼ばれますが、命令の一文だけに限りません。質問、元の文章、出力例などを含む場合もあります。「次の案内を100字程度で要約してください」という指示と、要約する案内本文を一緒に渡すなら、その両方が入力のプロンプトに含まれます。
モデルのファイルや学習済みの重み、Temperatureなどの生成設定、実際に返された要約文は、同じものではありません。例えば「モデルZを使う」「Temperatureは0.7」「指示と案内本文を渡す」「要約が返る」という記録なら、順に使うモデル、生成設定、入力、出力という役割です。モデルを固定した利用では、入力を変えることを重みの更新と混同しません。
根拠:Machine Learning Glossary(別タブで開く) ↗ / Generation — GenerationConfig(別タブで開く) ↗
名前・規模・出力を、別の確認へつなぐ
身近な要約ツールを選ぶときも、使われるモデルの説明、実際に渡す指示や材料、自分の用途での結果を分けて見ます。創発的能力の報告があっても、対象の課題や条件を超えた性能をそのまま約束するものではありません。事実の確認や、利用を認められた情報だけを渡す判断も残ります。
「LM/LLM」はモデルの種類や規模、「プロンプト」は利用時の入力、「自然言語処理」は言葉を扱う広い分野です。いずれも、処理をどこで動かすか、データを誰が扱うか、モデルをどの条件で使えるかを名前だけで決めるものではありません。次は配置と利用条件を別の軸で比べます。
根拠:Emergent Abilities of Large Language Models(別タブで開く) ↗ / Are Emergent Abilities of Large Language Models a Mirage?(別タブで開く) ↗ / Machine Learning Glossary(別タブで開く) ↗ / The NIST Definition of Cloud Computing — SP800-145(別タブで開く) ↗ / The Open Source AI Definition 1.0(別タブで開く) ↗
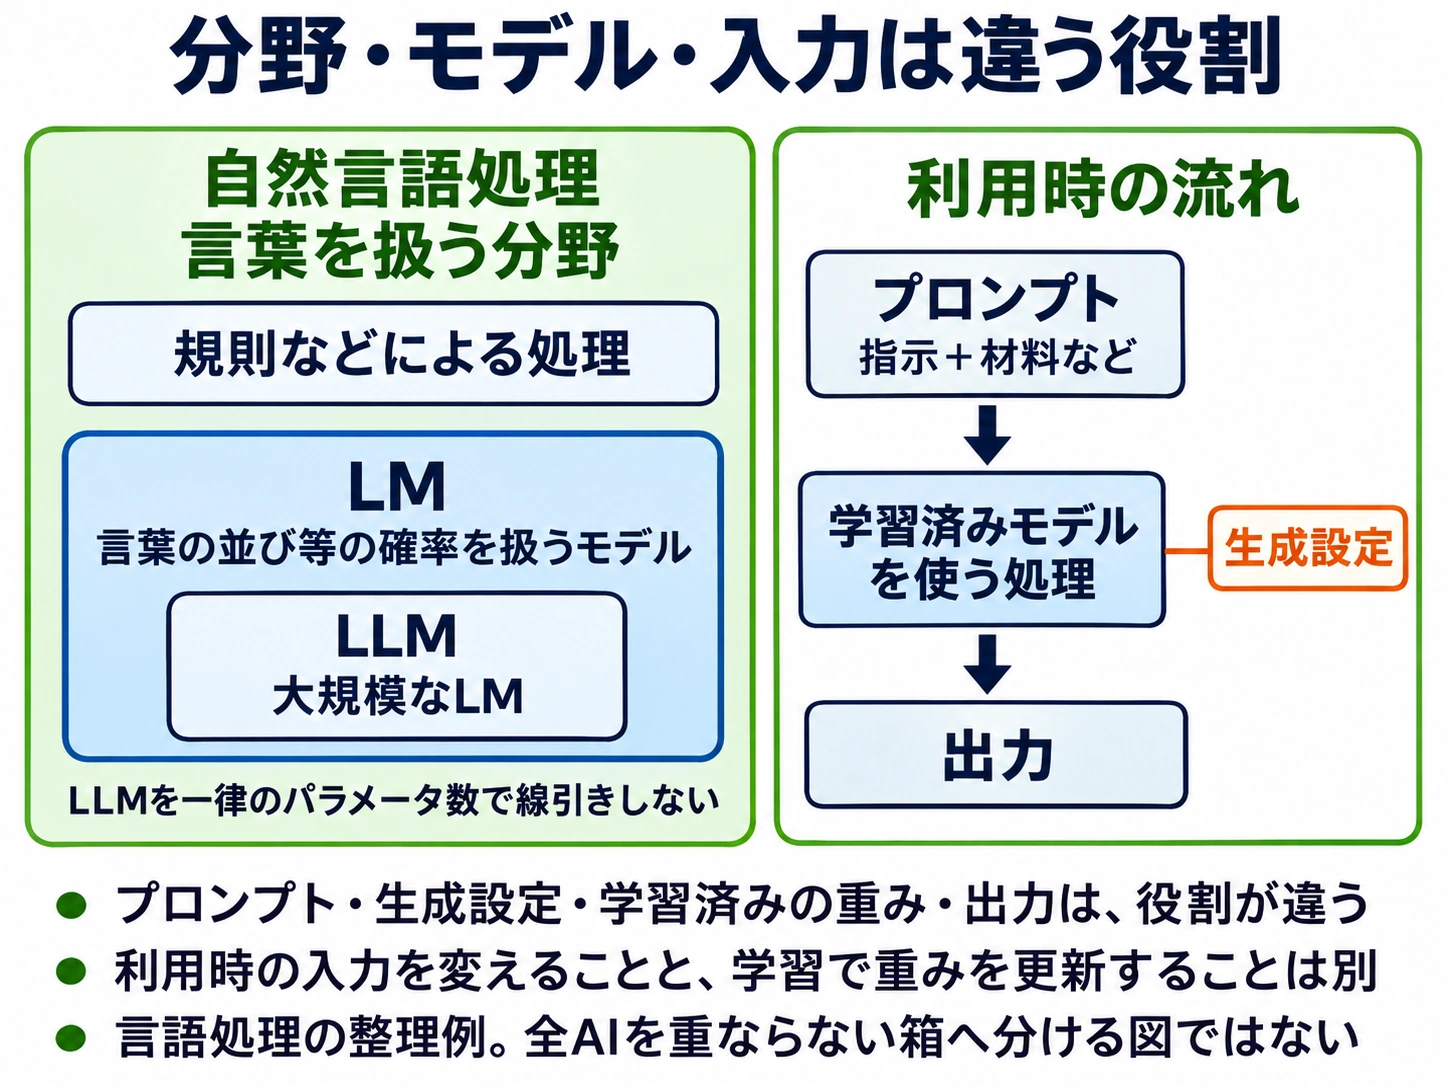 図を拡大する ↗
図の内容を文章で確認する
言葉を扱う分野と、その中のモデル
自然言語処理は言葉を扱う広い分野で、規則などによる処理もあります。LMは言葉の並び等の確率を扱うモデル、LLMはその大規模なものです。LLMを一律のパラメータ数で線引きする図ではありません。
利用時の流れ
- プロンプトとして、指示や材料などを渡します。
- 学習済みモデルを使って処理します。生成設定は別の役割で処理へ添えます。
- 出力が返ります。
プロンプト・生成設定・学習済みの重み・返る出力は、役割が違います。利用時の入力を変えることと、学習で重みを更新することは別です。重みを更新する矢印はありません。
今回の言語処理の整理例で、全AIを重ならない箱へ分ける厳密な分類図ではありません。
名前や規模から性能や用途への適合を保証せず、実際の処理と条件を本文と合わせて読みます。
根拠:Machine Learning Glossary(別タブで開く) ↗ / Introduction to Large Language Models(別タブで開く) ↗ / Generation — GenerationConfig(別タブで開く) ↗ / Emergent Abilities of Large Language Models(別タブで開く) ↗ / Are Emergent Abilities of Large Language Models a Mirage?(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。
2動かす場所・データ管理・利用条件を別々に確かめる
自分の場所で動かせるモデルなら、安全で自由に使えるのでしょうか。
- クラウドとオンプレミスを運用条件で比べる
- データ主権と重み/ソースの公開、ライセンスを分けて判断する
置き場所と、使ってよい条件は別だった
この話で学ぶこと:動かす場所・データ管理・利用条件を別々に確かめる。
コマは上から下へ、横に並んだコマは右から左へ読みます。
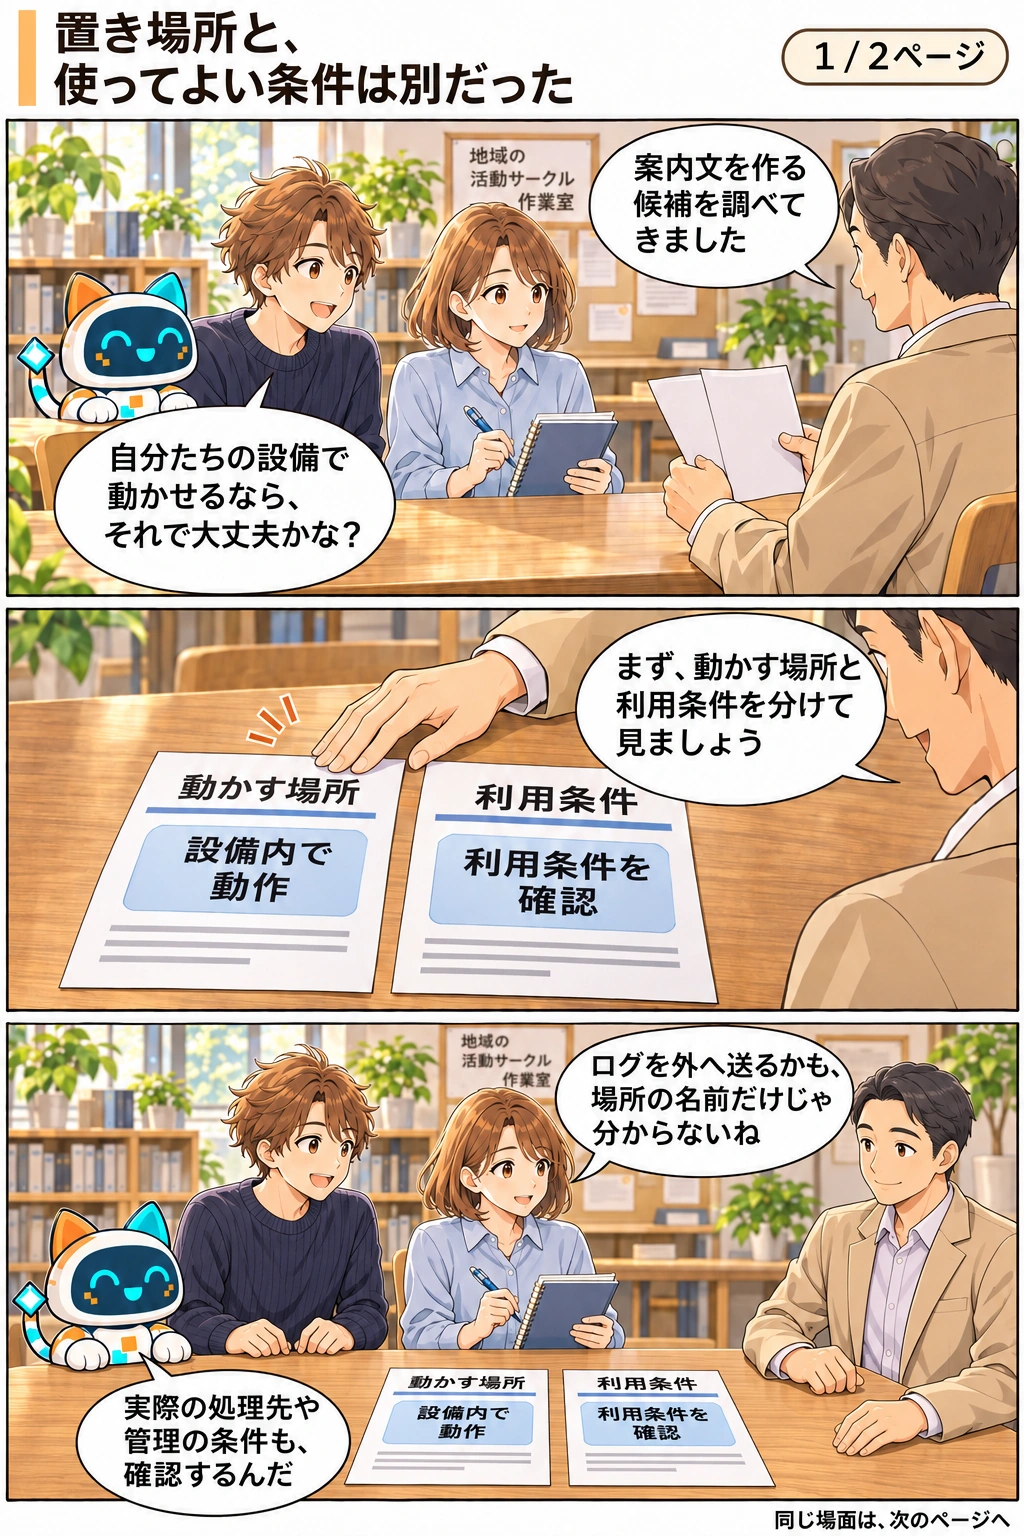
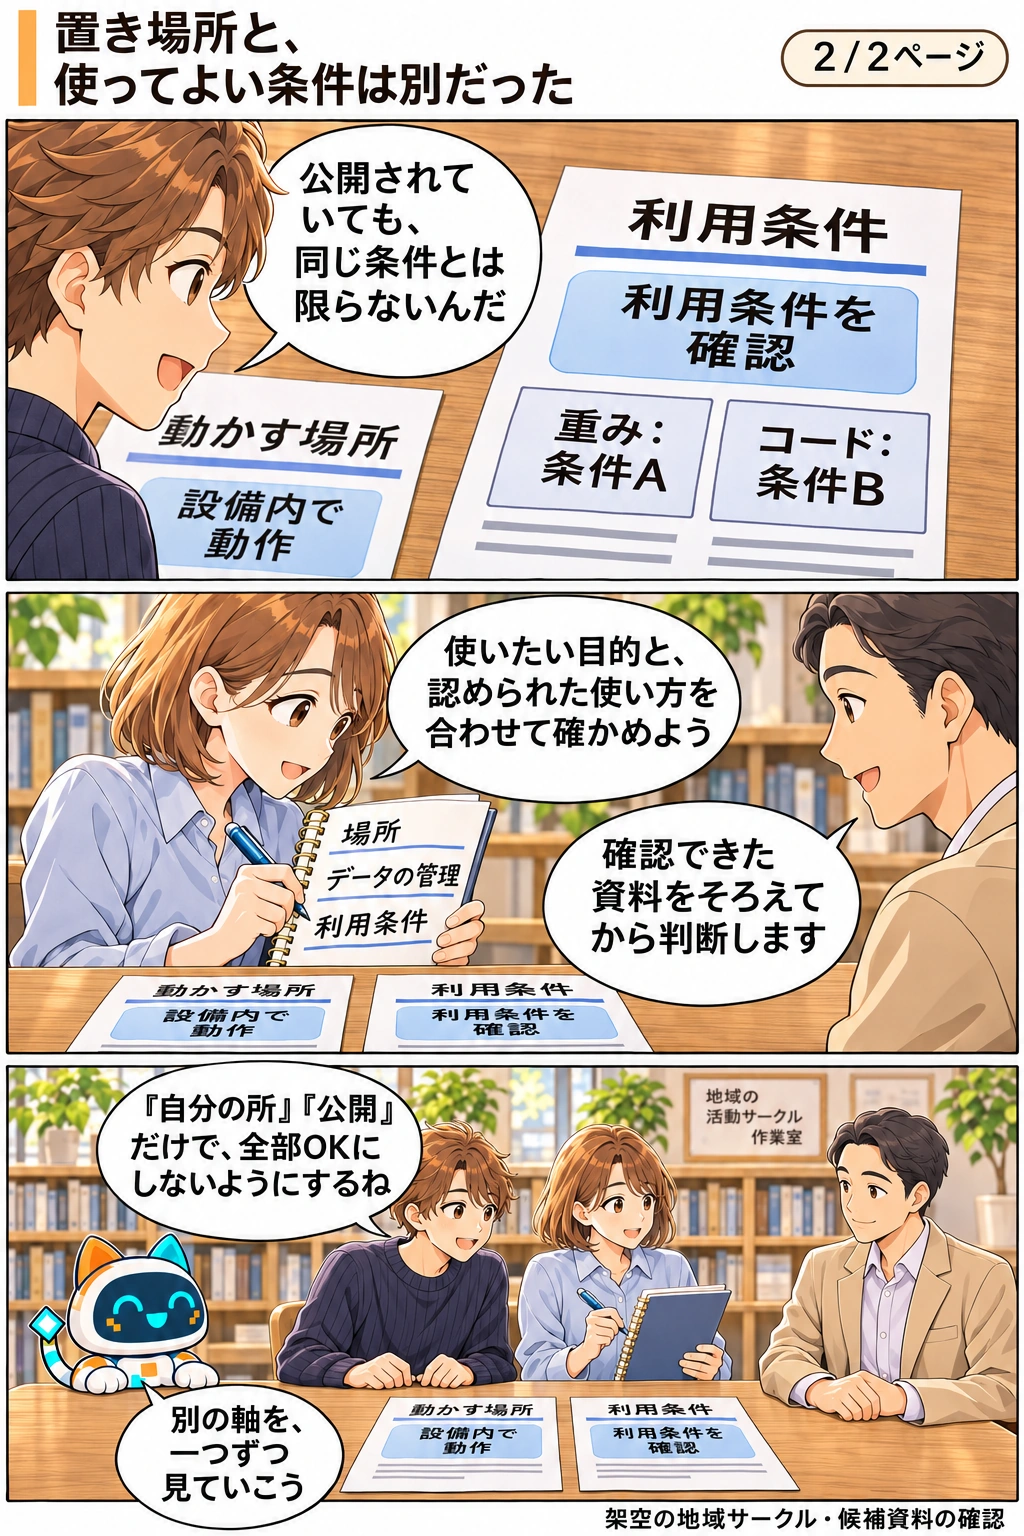
会話を文章で読む
場面:地域サークルの作業室。ハルは左、ミオは中央、担当者は右、ビットは左奥。担当者が持ってきた候補資料を説明し、ハルが問いかける。
担当者「案内文を作る候補を調べてきました」 ハル「自分たちの設備で動かせるなら、それで大丈夫かな?」場面:担当者の右手が二枚を机へ置く。「動かす場所/設備内で動作」と「利用条件/利用条件を確認」が分かれている。
担当者「まず、動かす場所と利用条件を分けて見ましょう」場面:正面寄りに三人とビットが紙を見比べる。二枚は台上、ミオは左手ノート・右手ペン。ミオに続き、下のビットがログと管理条件について話す。
ミオ「ログを外へ送るかも、場所の名前だけじゃ分からないね」 ビット「実際の処理先や管理の条件も、確認するんだ」場面:同じ机上の二枚へ寄る。利用条件紙には「重み:条件A」「コード:条件B」が別々にある。
ハル「公開されていても、同じ条件とは限らないんだ」場面:ミオが左手の同じノートを支え、右手のペンで「場所/データの管理/利用条件」を書く。ミオに続いて担当者が、確認できた資料をそろえて判断すると話す。
ミオ「使いたい目的と、認められた使い方を合わせて確かめよう」 担当者「確認できた資料をそろえてから判断します」場面:正面寄りの引きで、二枚は別々に机上へ残る。ミオは同じノートの表紙側を手元で持つ。ハルに続き、下のビットが別の軸を確かめると話す。
ハル「『自分の所』『公開』だけで、全部OKにしないようにするね」 ビット「別の軸を、一つずつ見ていこう」
地域サークルの案内づくりで公開モデルを検討する場面から、使う場所と許された使い方を分けます。二人が業務上の最終決定権や法律判断の資格を持つ設定にはせず、確認資料をそろえる行動へつなぎます。
どこで動かすかと、どのモデルを使うかは別の軸
クラウド型LLMでは、提供者が用意する環境で動くモデルを、ネットワーク越しに利用する形が代表例です。オンプレミスLLMは、自組織が管理する設備や環境へ置いて運用する形です。どちらでも使うモデルの種類、必要な機材、保守や更新の担当を確認します。自社に置けば機材や運用の費用が不要になるわけではありません。
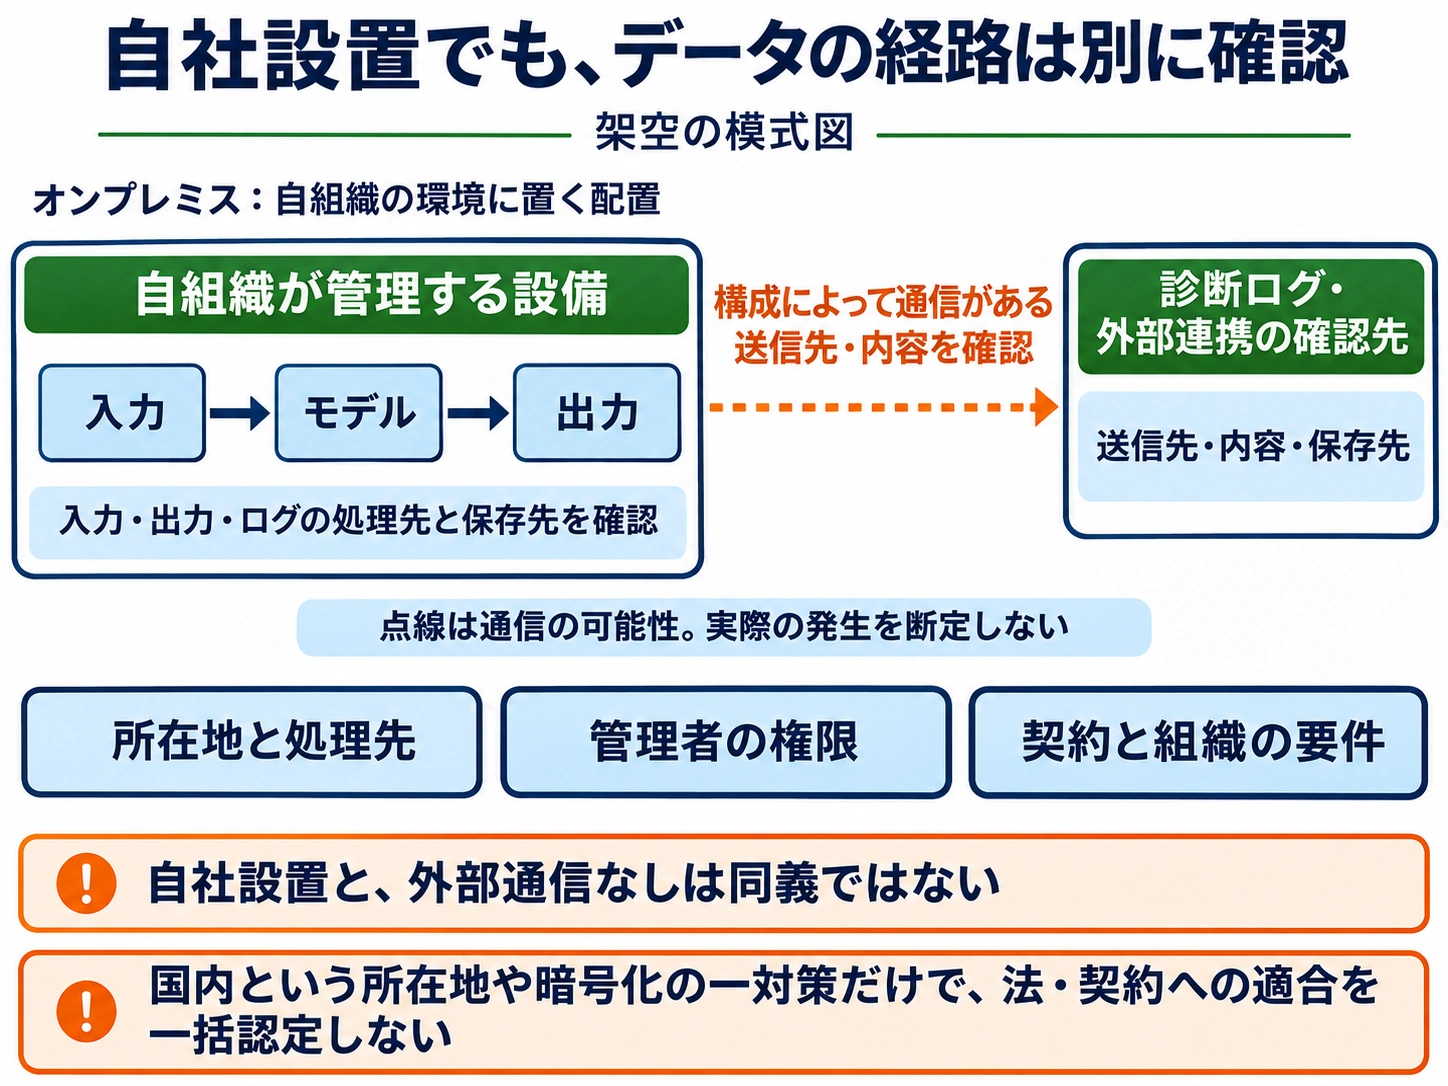
オンプレミスでも更新や外部の機能のために通信する構成はあり得ます。「自社設置」と「外部へ一切接続しない」は同義ではありません。また、単一組織専用のプライベートクラウドは、自社内にも外部にも置かれ得ます。名称だけでなく、実際にどこで何を処理し、どこへ通信するかを確かめます。
根拠:The NIST Definition of Cloud Computing — SP800-145(別タブで開く) ↗ / Sovereign private cloud use cases and configurations(別タブで開く) ↗
データの場所だけでなく、法や管理権限も見る
データ主権は、データに適用される法や、管理・利用を誰がどの条件でコントロールするかに関わる考え方です。保存先の地域、実際の処理先、ログや複製の置き場所、管理者のアクセス権などを確認します。国内のサーバと書いてあることだけで、全ての法・契約・組織の要件を満たすとは決めません。
例えば、組織の規則が「入力と出力、ログも指定国内だけで処理・保存する」と定めているなら、主要なモデルが国内で動くことだけでは足りません。外部の診断ログや連携先まで条件と照合します。個人データについても、クラウドの外部事業者が実際にどう取り扱うかを契約やアクセス制御等で確認します。「学習に使わない」という説明だけを、事業者がデータを取り扱わないことや法的適合と同一視しません。
根拠:AI workloads and sovereignty(別タブで開く) ↗ / 個人情報保護法FAQ Q7-53(別タブで開く) ↗
 図を拡大する ↗
図の内容を文章で確認する
架空の模式図です。オンプレミスは自組織の環境へ置く配置であり、全ての外部通信が自動でなくなる意味ではありません。
自組織が管理する設備の中で、入力→モデル→出力という処理を示します。入力・出力・ログの処理先と保存先を確認します。外への点線は構成による通信の可能性で、実際の送信発生を断定しません。診断ログや外部連携の送信先・内容・保存先を調べます。
- 所在地と実際の処理先
- 管理者の権限
- 契約と組織の要件
自社設置と外部通信なしは同義ではありません。国内という所在地や暗号化の一つの対策だけで、全ての法や契約への適合を一括認定する図ではありません。プライベートクラウドとオンプレミスも同義にしません。
実際の製品のネットワーク構成・送信や個別の法務適合を認定せず、入力/出力だけでなくログ・連携・管理条件まで具体的な規則へ照合します。
根拠:The NIST Definition of Cloud Computing — SP800-145(別タブで開く) ↗ / Sovereign private cloud use cases and configurations(別タブで開く) ↗ / AI workloads and sovereignty(別タブで開く) ↗ / 個人情報保護法FAQ Q7-53(別タブで開く) ↗
重みが入手できることと、オープンソースの条件を分ける
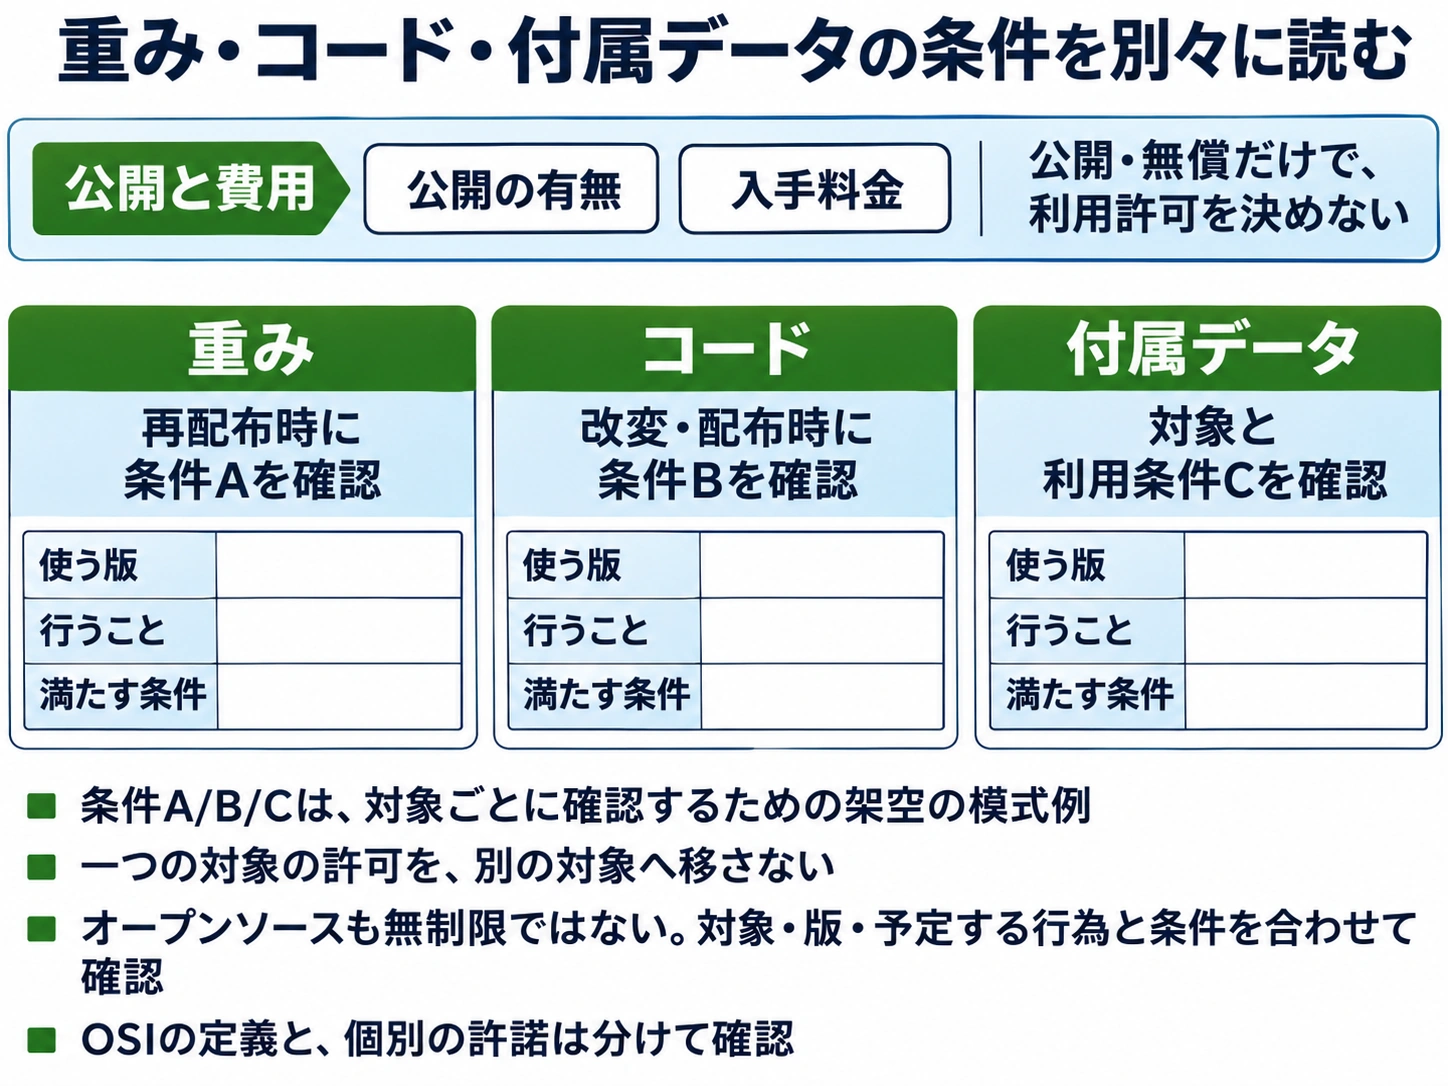
オープンウェイトは、学習済みの重みを公開して入手できるモデルを指す言い方です。重みが手元へ来ても、学習に使った情報やコードの全てが公開されているとは限りません。また、利用目的などに条件が付くこともあります。公開されていること、無償で入手できること、変更・再配布・商用利用を認めることは別です。
オープンソースという名前も、コードを見られるだけという意味にはしません。例えばOSIのOpen Source AI Definition 1.0では、使用・調査・改変・共有の自由と、それに必要なデータに関する情報、コード、パラメータを求めています。学習データそのものを全件自由配布することと、十分なデータ情報を提供することは区別されています。ここではOSIという団体の定義を紹介しており、全ての公開モデルがその定義を満たすと認定するものではありません。
根拠:The Open Source AI Definition 1.0(別タブで開く) ↗ / The Open Source Definition(別タブで開く) ↗
実際の利用行為に合うライセンスを読む
ライセンスは、利用・改変・再配布などについて権利者等が示す条件です。重み、実行コード、付属データ等で条件が違う場合もあるので、使う版と対象のファイルを確認します。例えば架空の公開モデルに「研究目的のみ、商用利用には別途許可」と書かれていたら、無料でダウンロードできても、無許可で販売サービスへ組み込めるという結論にはなりません。
逆に、オープンソースの条件でも著作権が消えるわけではありません。例えばApache License 2.0のコードでは、利用・改変・再配布を認めつつ、再配布時のライセンスの写しや必要な表示等の条件があります。実際に使うライセンスの条件を確認します。動かす場所を自社内へ変えても、モデルの利用条件が消えるわけではありません。入力資料や生成物の権利は別の確認も必要です。判断できない条件を、自分に都合よく「公開だから自由」と補わず、用途と許諾の対応が確認できるまで採用を保留します。
根拠:The Open Source AI Definition 1.0(別タブで開く) ↗ / The Open Source Definition(別タブで開く) ↗ / Apache License, Version 2.0(別タブで開く) ↗
 図を拡大する ↗
図の内容を文章で確認する
公開の有無と入手料金は上の別欄です。公開・無償だけでは、利用許可は決まりません。
- 重み
- 再配布時に条件Aを確認します。
- コード
- 改変・配布時に条件Bを確認します。
- 付属データ
- 対象と利用条件Cを確認します。
それぞれ「使う版」「行うこと」「満たす条件」を確かめます。A/B/Cは対象ごとに確認するための架空の模式例で、実在のライセンス条文や許諾を示しません。空欄は確認のための枠で、許可済みの印ではありません。
一つの対象の許可を別の対象へ移しません。重みの入手、コードの閲覧、無償、変更・再配布・商用の許可は別です。オープンソースも無制限という意味ではなく、対象・版・予定する行為と条件を合わせて読みます。OSIの定義と、個別の実際の許諾も分けて確認します。
個別モデル・コード・資料の採用可否や商用利用を承認する図ではありません。判断できない条件は用途と許諾を確認するまで保留します。
根拠:The Open Source AI Definition 1.0(別タブで開く) ↗ / The Open Source Definition(別タブで開く) ↗ / Apache License, Version 2.0(別タブで開く) ↗
別の場面で確かめる
全て独自作成の問題です。本文の考え方を条件へ当てはめてみましょう。公式問題や試験全体の難易度を再現したものではありません。